01|RAG 到底在解决什么问题?(附全套学习地图)
同事甩给你一个 80 页的产品手册,说:"做个知识库,以后大家直接问它。" 你兴冲冲把文档丢给大模型,它回答得头头是道,就是有一半是编的。
这一篇,我们把"为什么会编"和"怎么让它不编"讲清楚。
本篇你能学到
- 大模型为什么会"一本正经地胡说",RAG 是怎么治这个病的
- 向量(Embedding)到底是什么,用一句人话讲明白
- 为什么"只靠向量检索"在真实文档里经常翻车
- 整个系统从头到尾分几步,后面 8 篇各自负责哪一段
一、先说病根:大模型不知道你的文档
大模型很聪明,但它没读过你的产品手册。
你问它:"我们系统的回调地址在哪配?"
它没见过你的系统。它只能根据训练时见过的"一般常识"猜一个最像的答案,于是就编了一个听起来很合理、实际上不存在的菜单路径。
这就是常说的幻觉(Hallucination,就是模型在编)。
那把文档一起塞给它行不行?
直觉方案:把 80 页手册整个贴进提问里。
三个现实问题立刻出现:
- 塞不下。大模型的输入有长度上限,一次对话能装的字数就那么多,80 页塞不进去。
- 贵。就算塞得下,每次提问都把 80 页重新发一遍,费用按字数算,问 100 次就是 8000 页。
- 反而更差。塞太多无关内容,模型注意力被稀释,答案质量不升反降。
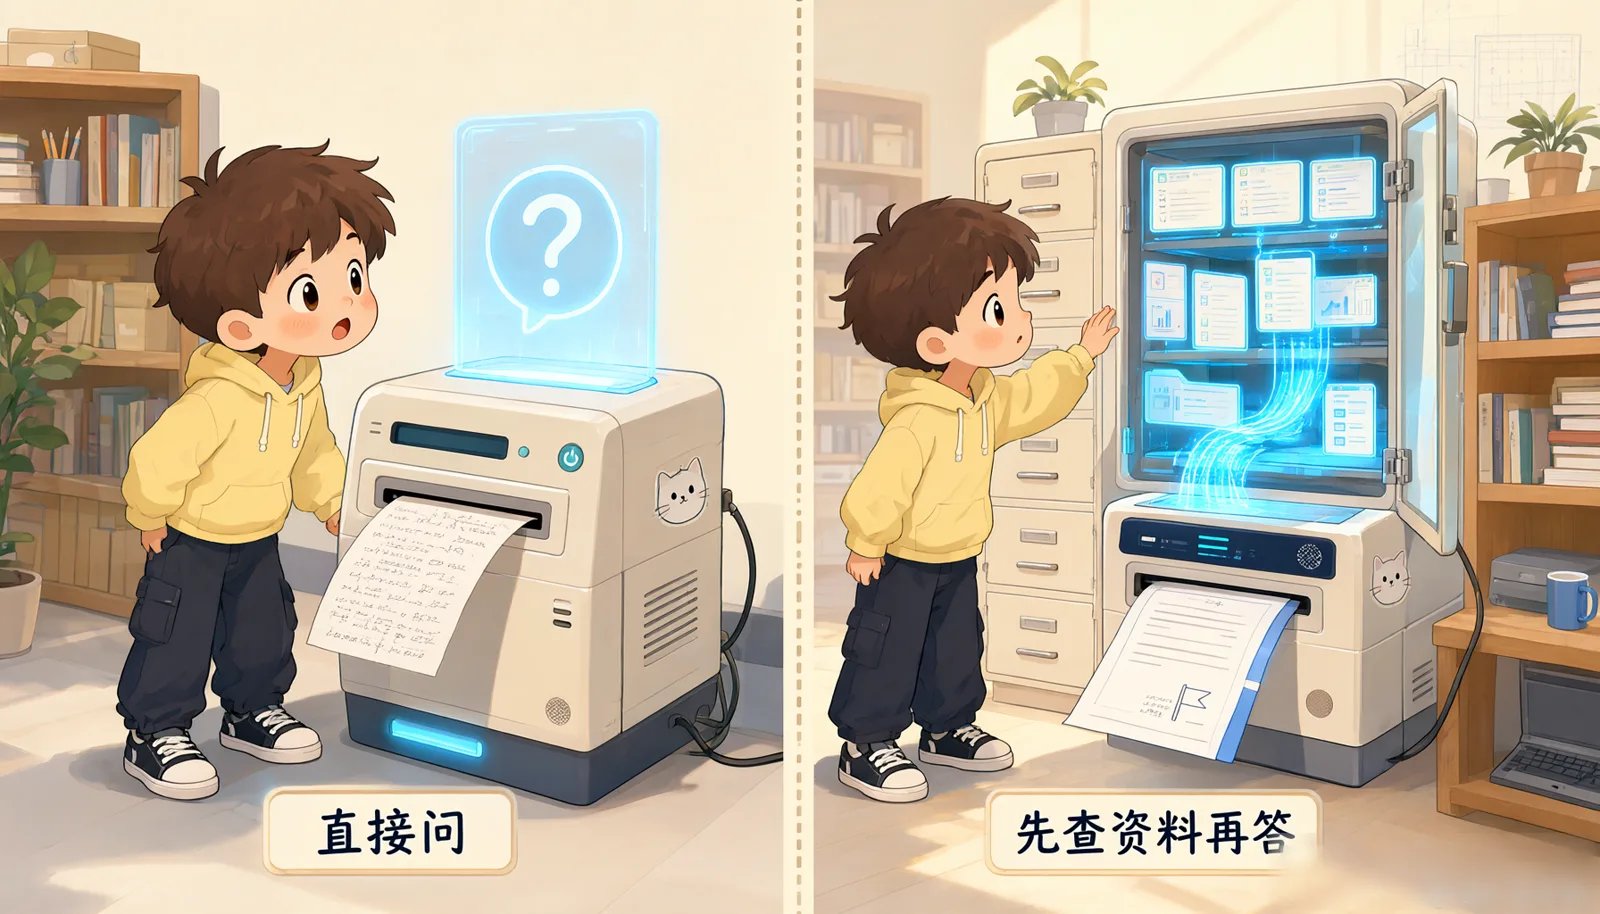
RAG 的思路:先查资料,再回答
RAG(Retrieval-Augmented Generation,检索增强生成)说白了就是三步:
1. 用户提问
2. 先从你的文档里,找出跟问题最相关的几段(检索)
3. 把这几段和问题一起交给大模型,让它照着这几段回答(生成)
关键差别:模型的回答有了"参考资料"。 它不再需要凭空猜,而且我们能指着参考资料说"答案出自第 12 页"。
二、检索这一步,到底在"检"什么?
这是整个系统的核心难点。
用户问"回调地址怎么配",你的文档里可能有这么一段:
"商户可在开放平台的开发配置页中修改回调通知地址,修改后 5 分钟生效。"
注意:用户说的"回调地址"和文档里的"回调通知地址",字面并不完全一样。 用 WHERE content LIKE '%回调地址%' 这种精确匹配,直接就漏了。
所以我们需要"按意思找"。
向量是什么:给文字发一张数字身份证
向量(Embedding,中文叫"嵌入"):用一套模型,把一段文字变成一串固定长度的数字。
"回调通知地址配置"  →  [0.12, -0.83, 0.45, ... ](共 1024 个数字)
"支付成功后通知你"  →  [0.11, -0.79, 0.48, ... ]
"公司团建报名通知"  →  [-0.62, 0.31, -0.15, ... ]
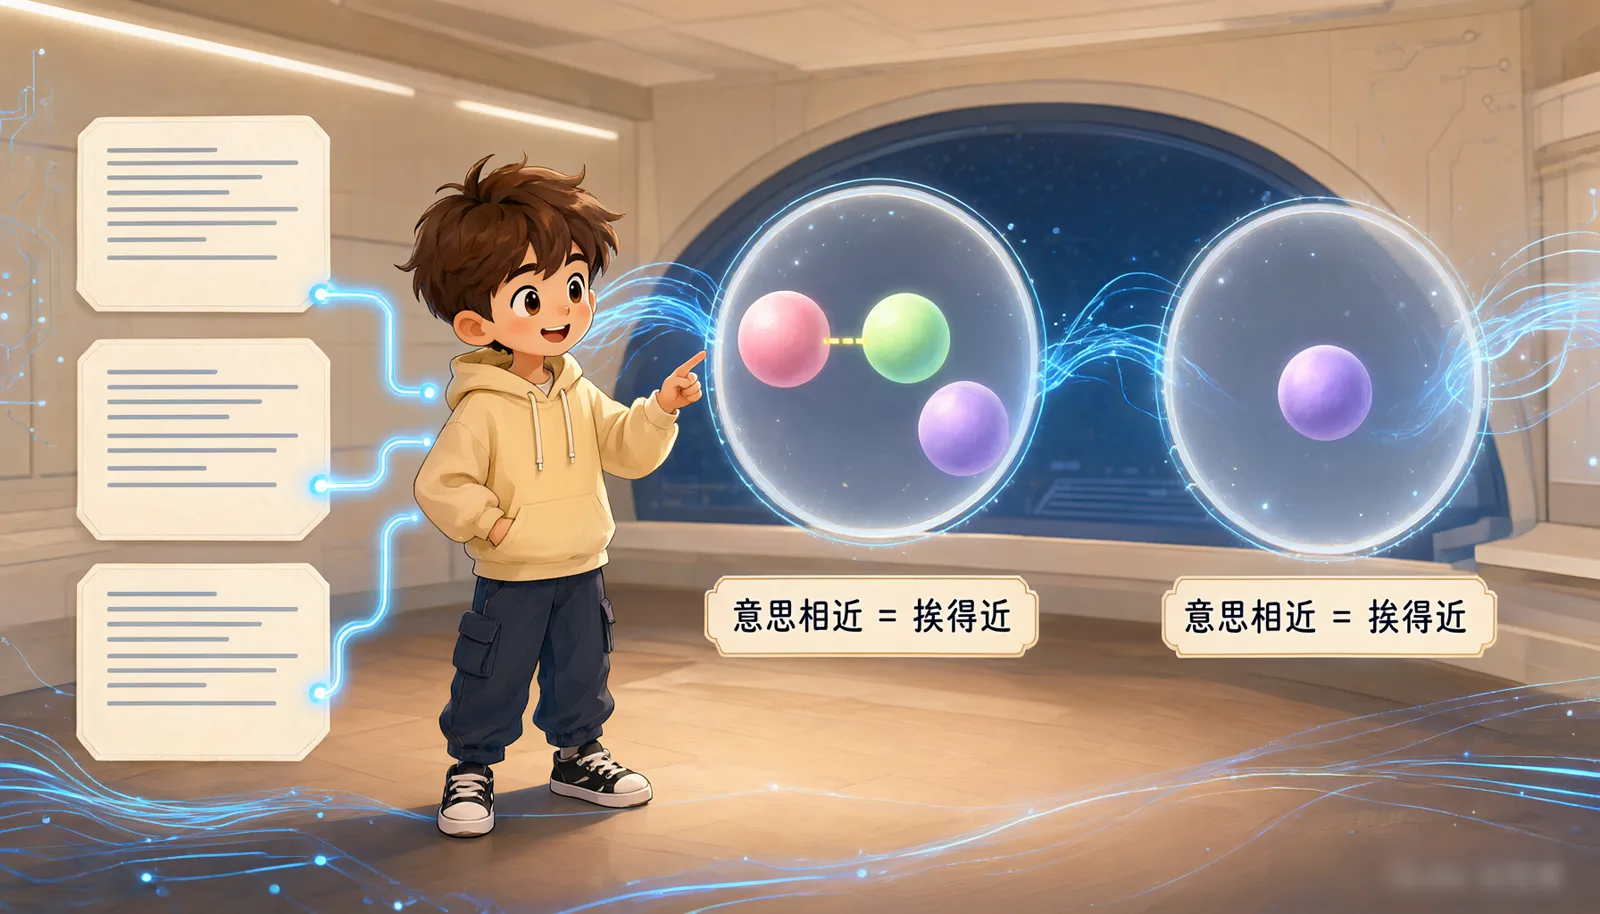
意思越相近的两段话,它们对应的这串数字就越像。
怎么衡量"像"?把这两串数字看成空间里的两个点,算它们的夹角(专业上叫余弦相似度)。夹角越小 → 意思越近。
于是"按意思找"就变成了一个数学问题:把提问也变成一串数字,然后去数据库里找跟它夹角最小的那几段。
三、只靠向量,为什么还是会翻车?
很多教程到这里就结束了:"把文档切块 → 变成向量 → 存起来 → 提问时找最像的几块"。
这套做法在真实文档里会翻车,我们踩过至少四个坑:
坑 1:型号、缩写、专有名词,向量搞不定
用户搜 "KB-2024-0317 工单"。
这是一个纯字符串编号,没有任何"语义"。向量模型看到它,跟看到一堆乱码差不多,很可能给你返回一堆讲"工单流程"的段落,但就是没有那条编号。
坑 2:中文分词
英文天然用空格分词,中文没有。如果检索时切不出"回调""通知"这些词,全文检索直接失效。
坑 3:表格和跨页内容
"2023 年和 2024 年的费率分别是多少?"
答案在一张跨了两页的表格里。如果切块时把表格拦腰截断,或者把表格压成了一坨没有行列结构的纯文本,检索时就再也拼不回来。
坑 4:切块大小的两难
这是最要命的一个,我们第 4 篇会专门展开:
- 切小一点:检索很准,但送给模型的是碎片,模型看不到上下文,答不完整。
- 切大一点:上下文完整,但一大段里什么都有,检索就不准了。
我们的解法:一次切两层,小块用来检索,大块用来生成。这就是"父子分块",第 4 篇的主角。
四、全链路总览:9 个环节,后面 8 篇各讲一段
先看这张图,建立整体印象,后面咱们一个一个拆。
【写链路:文档进来,离线慢慢处理】

  上传文件
    ↓
  ① 解析:PDF/Word/Excel/PPT → 统一格式(第 3 篇)
    ↓
  ② 分块:切成父块 + 子块两层(第 4 篇)
    ↓
  ③ 落库:写进 PostgreSQL(第 2 篇建的表)
    ↓
  ④ 向量化:给每个子块算向量(第 5 篇)
    ↓
  文档状态变成"已完成",可以参与检索了

【读链路:用户提问,要快,要稳】

  用户提问
    ↓
  ⑤ 三路并行检索:按意思找 + 按词找 + 按长相找(第 6 篇)
    ↓
  ⑥ 融合 + 重排:三张榜单合成一张,再让模型审一遍(第 6 篇)
    ↓
  ⑦ 上卷 + 裁剪:小块并回大块,塞进 Token 预算(第 7 篇)
    ↓
  ⑧ 流式生成 + 引用回指(第 8 篇)
    ↓
  ⑨ 长期维护:切片可编辑、知识库、鉴权上线(第 9 篇)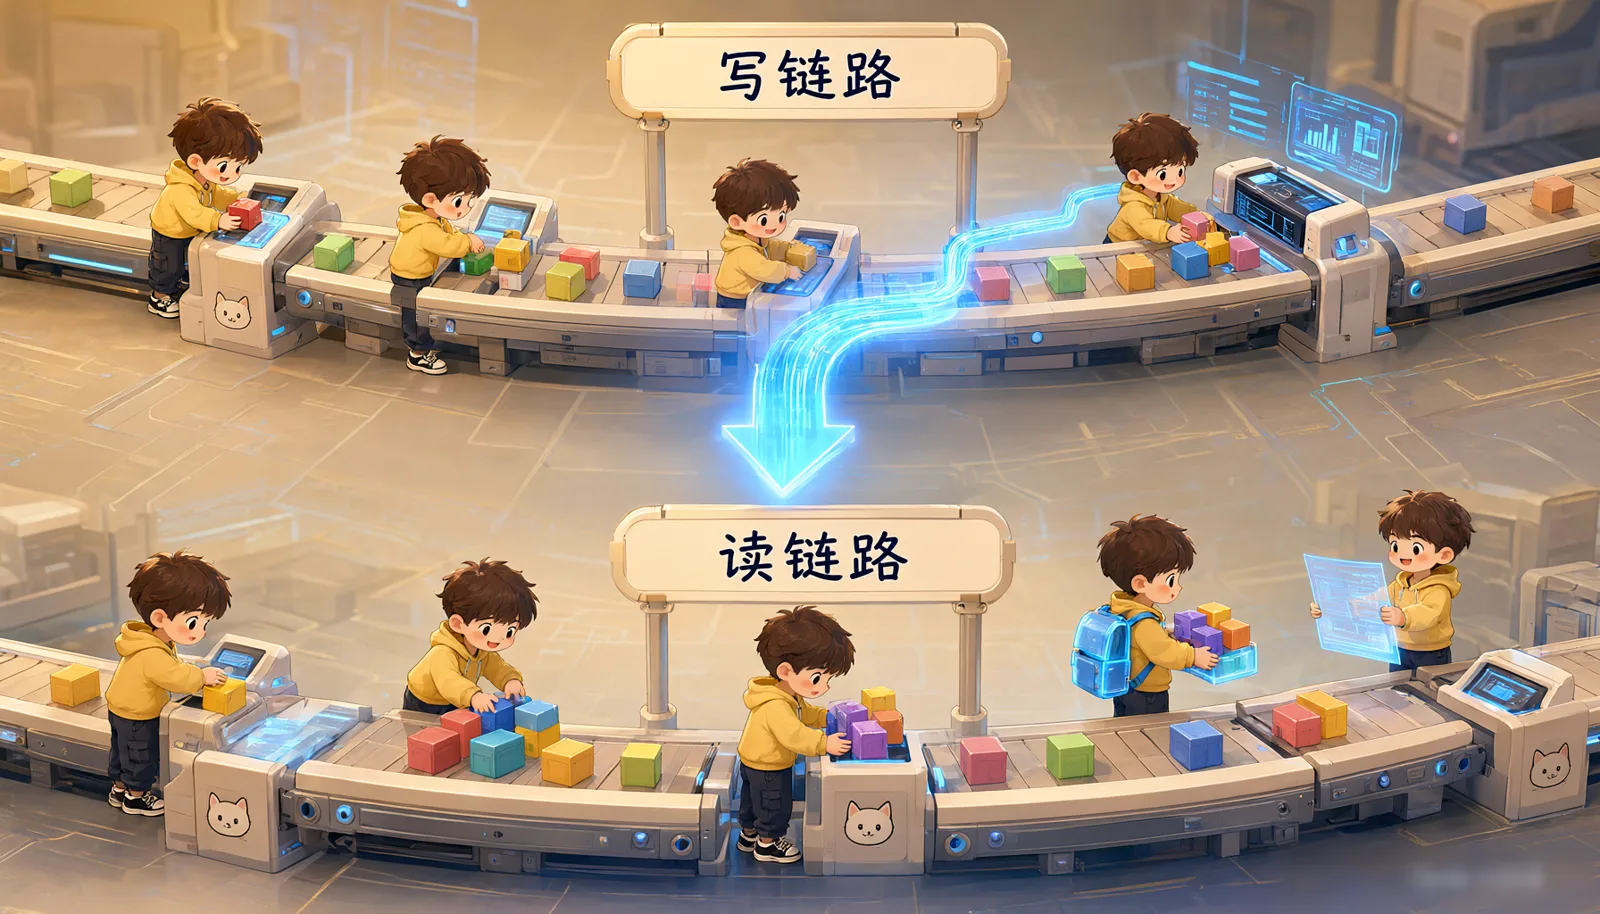
这个系统的三个设计取向
先说清楚我们不做什么,这决定了整套方案的性格:
| 不做 | 换成什么 |
|---|---|
| 不单独部署 Milvus / Qdrant 向量数据库 | 就用 PostgreSQL,装个 pgvector 插件 |
| 不单独部署 Elasticsearch | 就用 PostgreSQL 自带的中文全文检索 |
| 不自建 OCR 服务 | 扫描件直接拦下来提示用户,或交给云端解析 |
为什么敢这么省? 因为这是给个人开发者和小团队用的单机方案。数据量在几十万段落以内时,一个 PostgreSQL 完全扛得住,而省下的运维成本是实打实的。
反过来说:如果你的数据量到了千万级、要横向扩容,那这套就不合适了,该上专用向量数据库。技术选型没有银弹,只有场景。
五、动手前,先确认你的环境
后面每篇都会带你跑命令,先把环境备好:
# 检查 Java(需要 17 或以上)
java -version
# 预期输出:java version "17.x.x" 或更高

# 检查 Maven
mvn -v
# 预期输出:Apache Maven 3.8.x 或更高

# 检查 Docker
docker --version && docker compose version
# 预期输出:Docker version 20.x+ / Docker Compose version v2.x+
三个命令都能正常输出版本号,就可以跟着往下走了。 缺哪个先装哪个,版本不够就升级,尤其是 Java,必须是 17 以上,Spring Boot 3.5 起不来。
⚠️ 常见错误与排错
Q1:我按教程做完,为什么模型还是在编?
先检查这三点:
- 文档状态是不是
COMPLETED?没完成向量化的文档不参与检索,系统会"假装没这份文档"。这是新手第一大坑,第 5 篇会讲。 - 检索是不是真的召回到了内容?看日志里有没有
retrieval stage=recall ... hits=0。hits=0说明压根没找到,模型只能瞎编。 - 提示词里有没有明确写"资料没提到的就说不知道"?第 8 篇会给完整提示词。
Q2:向量维度是不是越大越好?
不是。维度越大越占空间、索引越慢。我们用的是 1024 维,这是一个精度和成本的平衡点。改维度必须同时改数据库表字段和已有索引,否则会报错,第 2 篇会特别标注。
Q3:我可以直接用 Dify / LangChain 吗,为什么还要自己写?
可以用,而且上手更快。但那些平台把父子分块、混合检索、重排都封装成了配置项,你不知道它背后做了什么,出问题时就没法调。这个系列的价值就是把黑盒拆开,让你知道每个旋钮拧下去会发生什么。
Q4:这套东西能处理图片/扫描件吗?
原生不支持。扫描件(没有文字层的 PDF)会被系统拦下来,标记为 NEEDS_OCR 并提示你。要处理就得开云端解析(第 3 篇会讲),或者自己接 OCR。
本篇小结
- RAG 的本质:先查资料再回答,让答案有出处,治"大模型瞎编"。
- 向量就是数字身份证:意思相近的文字,数字串也相近,于是"按意思找"变成了算距离。
- 只靠向量不够:编号型号、中文分词、表格结构、切块大小,四个坑都得单独处理。
- 切块的两难是整个系统的核心矛盾,解法是父子两层分块,小块检索、大块生成。
- 选型要有场景感:数据量几十万段落以内,一个 PostgreSQL 就够了;到了千万级再考虑专用向量库。
下一篇预告
下一篇我们先把仓库盖起来:只用一条命令,起一个同时具备「向量检索 + 中文全文检索 + 模糊匹配」三种能力的 PostgreSQL。
顺便剧透一个几乎所有中文 RAG 教程都不会告诉你的坑:数据库初始化时的一个字符集设置选错,pg_trgm 会静默地忽略掉所有中文字符,不报错,就是查不出来,而且很难想到是字符集的问题。
下一篇预告:一头小象驮着三块牌子,脚下踩着 Docker 集装箱。
课程章节
01|RAG 到底在解决什么问题?(附全套学习地图)
正在检查解锁状态…