02|地基:一个 PostgreSQL 扛下三种检索
上篇说到,只靠向量检索会在型号、缩写、中文分词上翻车。 这次我们把"仓库"先盖好:一个数据库,同时具备三种检索能力。
不用装 Milvus,不用装 Elasticsearch。
本篇你能学到
- 一个 PostgreSQL 怎么同时做向量检索、中文全文检索、模糊匹配
- 一条命令把数据库跑起来,含完整可直接复制的配置
- 三张表的关系,以及每个索引为什么那么建
- 中文检索最容易踩、又最难排查的那个坑
一、为什么敢用一个数据库扛所有?
先算笔账。
常规方案要凑齐这套能力,你得部署:向量数据库(Milvus / Qdrant)+ 全文检索引擎(Elasticsearch)+ 关系库(MySQL / PG)+ OCR 服务。
四个中间件,四套运维。
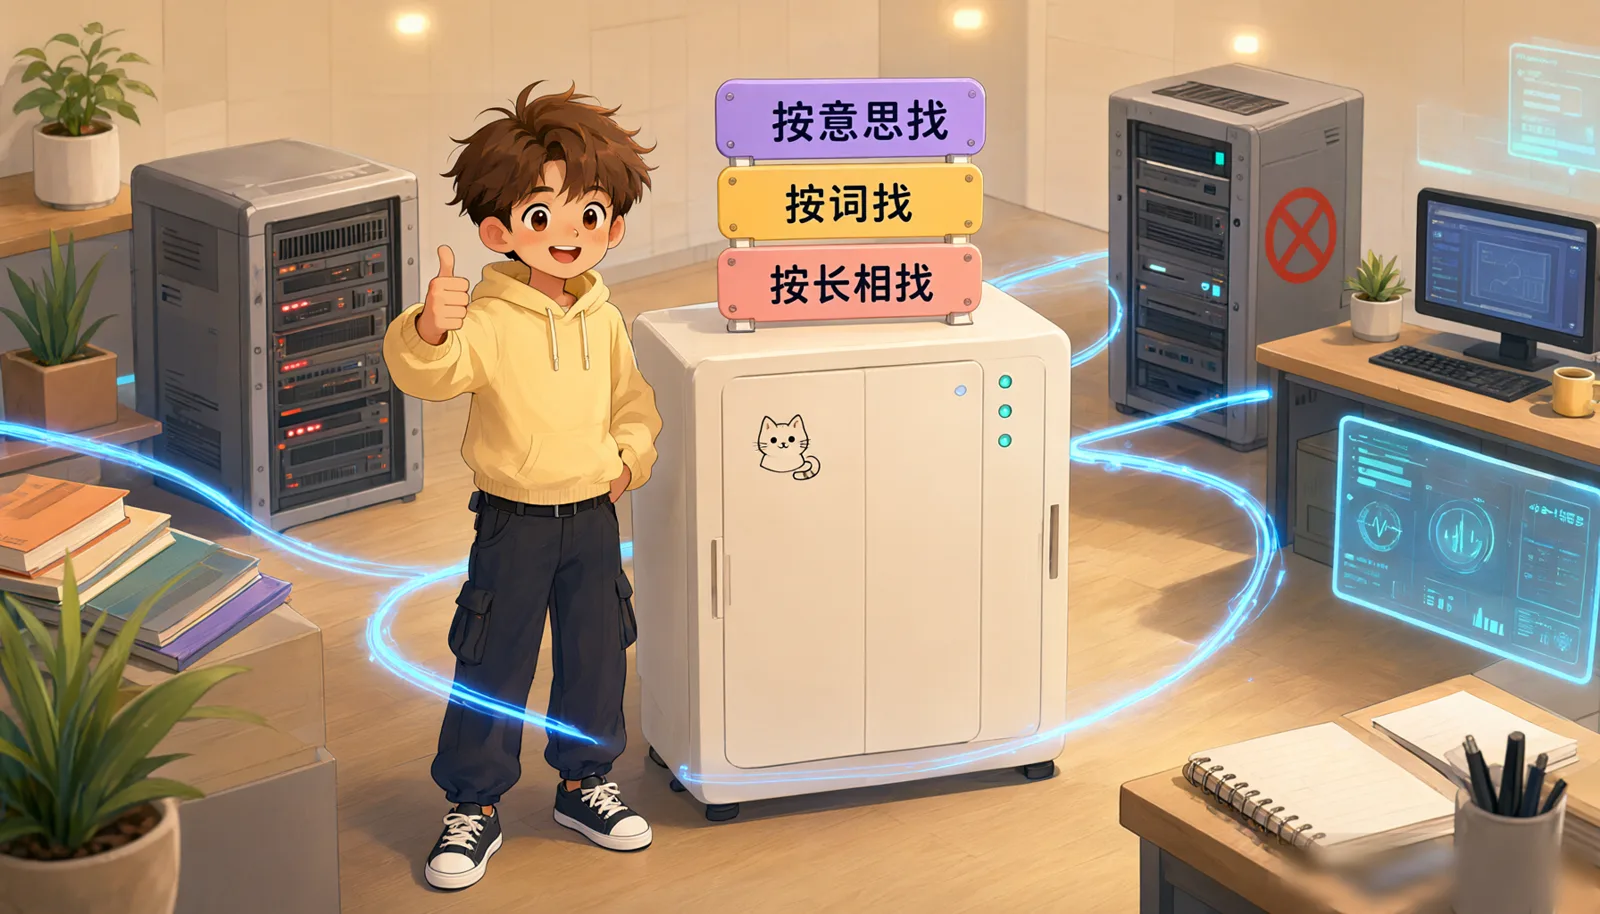
而 PostgreSQL 装三个扩展就能全搞定:
| 能力 | 用的扩展 | 解决什么问题 |
|---|---|---|
| 向量检索 | pgvector | 按意思找("回调地址"能找到"回调通知地址") |
| 中文全文检索 | zhparser | 按词找(能正确切出"支付""网关"这些中文词) |
| 模糊匹配 | pg_trgm | 按长相找(错别字、"KB-2024-0317"这种编号) |
代价是什么? 单机的上限。几十万段落以内它又快又省心;上千万级要横向扩容时,就得换专用向量库了。先跑起来,再谈扩容,大多数项目根本走不到需要扩容的那天。
二、一条命令把库跑起来
1. 先看镜像里做了什么
官方的 pgvector/pgvector:pg16 只带了 pgvector。我们还要 zhparser,所以要在镜像里多编两个东西:
# docker/Dockerfile(节选)
FROM pgvector/pgvector:pg16

# 1) 装编译工具 + PG 开发头文件
RUN apt-get install -y --no-install-recommends \
        build-essential git wget bzip2 postgresql-server-dev-16

# 2) 编译安装 SCWS(中文分词内核)
RUN wget -O scws.tar.bz2 "${SCWS_URL}" \
    && tar xjf scws.tar.bz2 \
    && cd scws-1.2.3 && ./configure --prefix=/usr/local \
    && make -j$(nproc) && make install && ldconfig

# 3) 编译安装 zhparser 扩展
RUN git clone --depth 1 https://github.com/amutu/zhparser.git \
    && cd zhparser && make -j$(nproc) && make install
你不需要手动执行这些,它们已经写在 Dockerfile 里了,构建时自动跑。
2. 起容器
cd docker
export KB_DB_PASSWORD='换成你自己的强密码'
docker compose up -d --build
预期输出(第一次会慢,要编译分词器):
[+] Building 180.3s (12/12) FINISHED
[+] Running 2/2
 ✔ Network eon-rag_default   Created
 ✔ Container eon-rag-db      Started
容器起来后会自动做两件事:建库 eon_rag、执行 docker/init/001_schema.sql 建表建索引。
3. 验证三件套都装好了
docker exec -it eon-rag-db psql -U postgres -d eon_rag -c "\dx"预期输出(Description 列太宽,这里省略):
   Name   | Version |   Schema
----------+---------+------------
 pg_trgm  | 1.6     | public
 pgcrypto | 1.3     | public
 plpgsql  | 1.0     | pg_catalog
 vector   | 0.8.6   | public
 zhparser | 2.4     | public
(5 rows)
四个扩展都在,地基就稳了。(多出来的 plpgsql 是 PostgreSQL 自带的,不用管。)
三、⚠️ 中文检索最隐蔽的坑:locale
现象
你按教程配好了一切,插入了一条中文数据,然后:
SELECT '支付网关' % '支付网关' AS 是否相似;预期是 t(true),实际返回 f(false)。
更诡异的是英文完全正常:
SELECT 'payment' % 'payment'; -- 返回 t,正常于是你怀疑索引没建、怀疑扩展没装、怀疑版本不对,一圈查下来什么都没问题。
根因:pg_trgm 会静默忽略非 ASCII 字符
pg_trgm 依赖数据库的字符分类设置(LC_CTYPE)。如果实例初始化时用的是 C 或 POSIX,它会认为"非 ASCII 字符不算字符",中文在三元组眼里就是空气。
注意"静默"两个字:它不报错,就是查不出来。
解法:初始化时就指定 locale
看 docker-compose.yml 里这行,中文检索能不能用就取决于它:
services:
  postgres:
    environment:
      POSTGRES_INITDB_ARGS: "--encoding=UTF8 --locale=C.UTF-8"
必须是 C.UTF-8 或 en_US.utf8,不能是 C 或 POSIX。
怎么确认自己没踩坑
SELECT datctype FROM pg_database WHERE datname = 'eon_rag';
-- 预期输出:C.UTF-8   (如果是 C 或 POSIX,说明中招了)

SELECT similarity('支付网关', '支付网关') AS 相似度;
-- 预期输出:1   (如果是 0,说明中招了)
别用 SHOW lc_ctype 去查:lc_ctype 是库级属性,不是运行时参数,SHOW 会直接报 unrecognized configuration parameter。只能查 pg_database。
中招了没有修补办法:这个设置在实例初始化时就固定了,只能删掉数据卷重来:
docker compose down -v     # -v 会连数据卷一起删,数据会丢!
docker compose up -d --build
⚠️
-v会删掉所有数据。只在还没导入真实文档时执行。
四、建表:三张表,一条外键链
建表脚本在 docker/init/001_schema.sql,是幂等的(重复执行不会报错,可以放心重跑)。
表关系
documents          文档主表(文件名、状态、父子块计数)
    │  1 : N
    │  ON DELETE CASCADE
    ▼
parent_chunks      父块(完整上下文,给大模型看的)
    │  1 : N
    │  ON DELETE CASCADE
    ▼
child_chunks       子块(建向量索引,负责检索)

knowledge_bases            知识库分类
document_knowledge_bases   文档 ↔ 知识库 多对多关联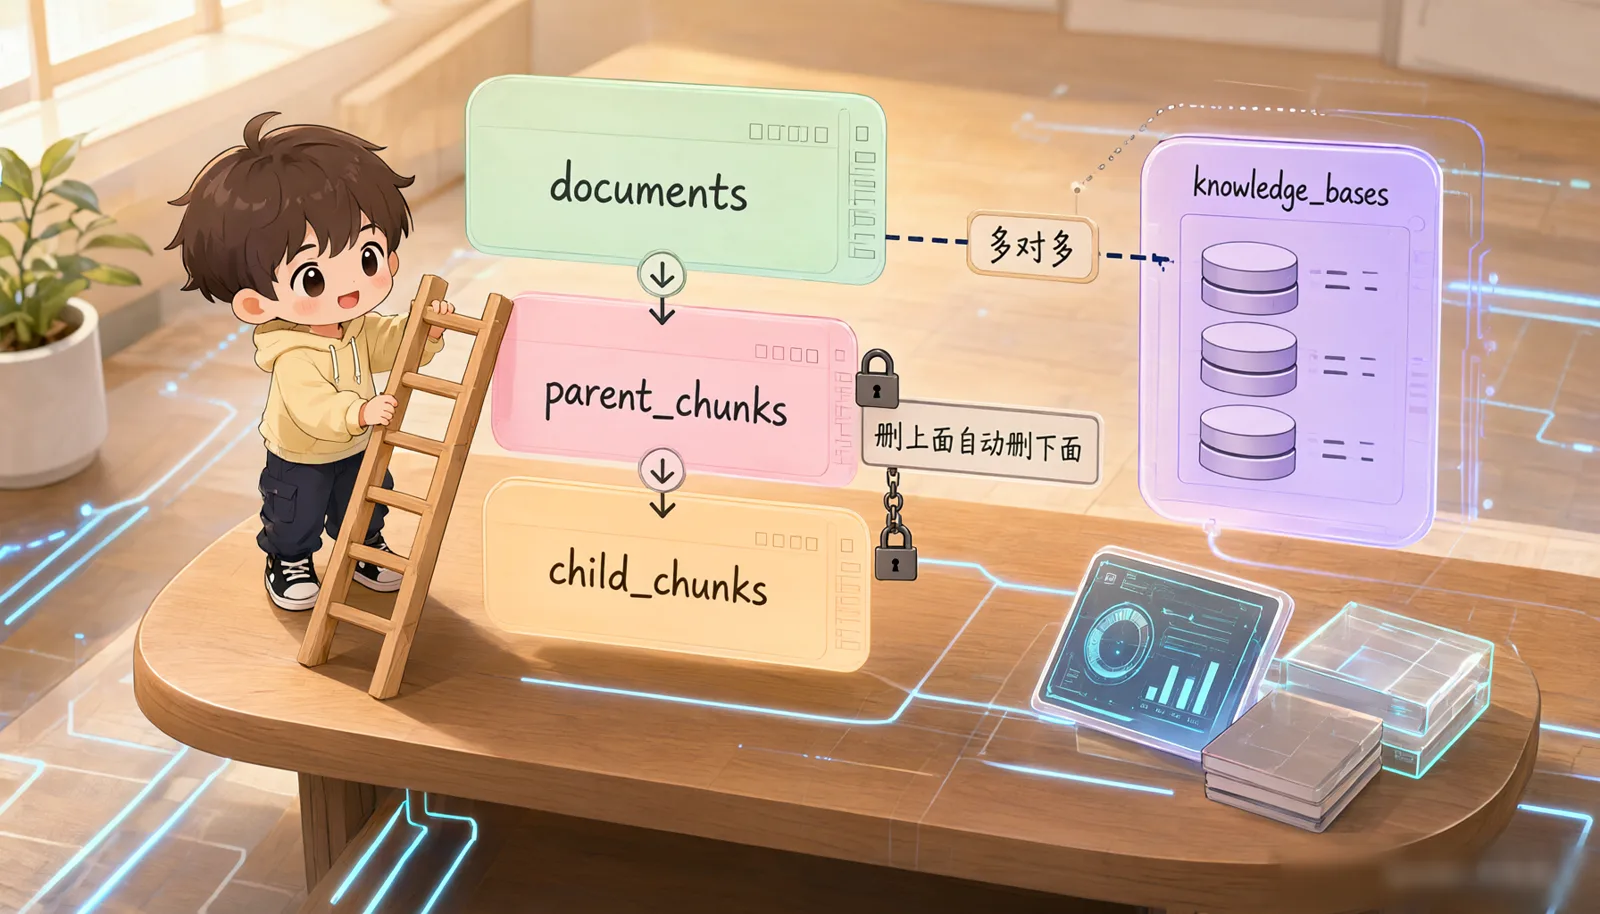
核心表:child_chunks
这是整个系统的心脏,三路检索都打在它身上。
每个子块记着自己属于哪个父块、哪个文档、排第几;
embedding存向量、search_content存分词索引(meta存页码等定位信息);父块或文档被删时,子块自动跟着删。
CREATE TABLE IF NOT EXISTS child_chunks (
    id             UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    parent_id      UUID NOT NULL REFERENCES parent_chunks(id) ON DELETE CASCADE,
    document_id    UUID NOT NULL REFERENCES documents(id) ON DELETE CASCADE,
    seq            INT  NOT NULL,
    content        TEXT NOT NULL,
    context_prefix TEXT,                  -- 上下文增强前缀,可为空
    embedding      vector(1024),          -- 向量!没做向量化前是空的
    search_content tsvector,              -- 全文检索向量,触发器自动维护
    token_count    INT  NOT NULL DEFAULT 0,
    meta           JSONB NOT NULL DEFAULT '{}'::jsonb,
    CONSTRAINT uq_child_parent_seq UNIQUE (parent_id, seq)
);
三个字段值得单独说:
embedding vector(1024):1024 维向量。改维度必须同步改这里,还要重建索引。search_content tsvector:不用你手动填,触发器自动从content生成。meta JSONB:存定位信息(页码、表名、片序),后面做引用回指全靠它。
三个索引,各伺候一路检索
一个字段一种索引,向量用 HNSW、分词索引用 GIN、模糊匹配用 Trigram GIN。少了哪个,对应那路检索就会退化成全表扫描。
-- ① 向量检索:HNSW 余弦索引
CREATE INDEX IF NOT EXISTS idx_child_embedding
    ON child_chunks USING hnsw (embedding vector_cosine_ops)
    WITH (m = 16, ef_construction = 64);

-- ② 中文全文检索:GIN 索引
CREATE INDEX IF NOT EXISTS idx_child_search
    ON child_chunks USING gin (search_content);

-- ③ 模糊匹配:Trigram GIN 索引
CREATE INDEX IF NOT EXISTS idx_child_trgm
    ON child_chunks USING gin (content gin_trgm_ops);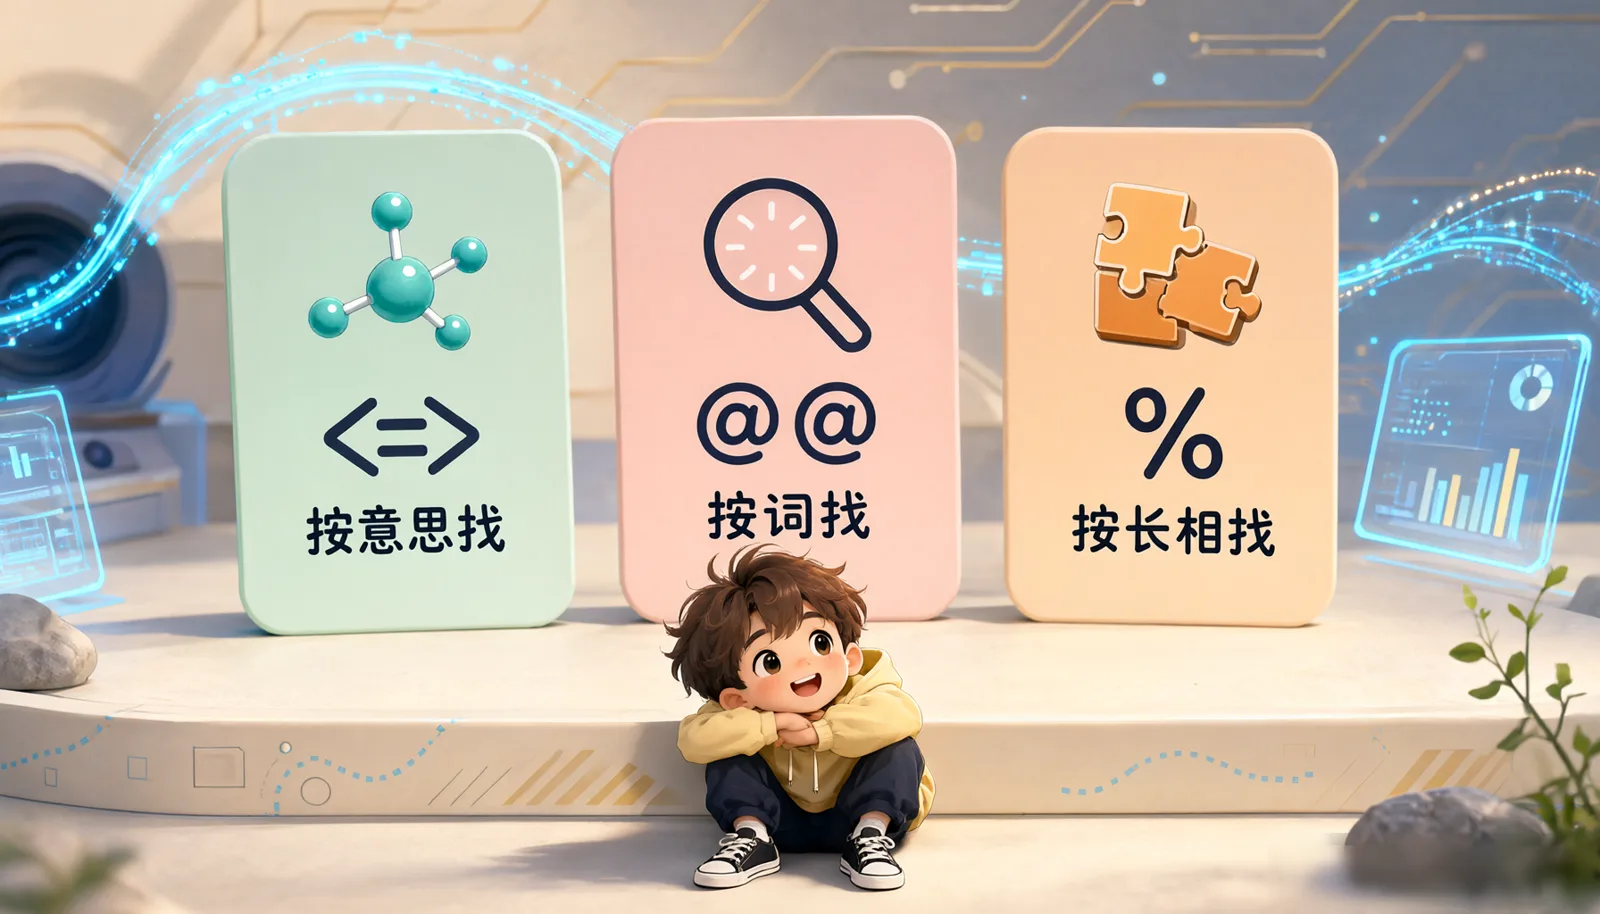
vector_cosine_ops 这个后缀别丢,它决定了索引按余弦距离组织。写错会导致查询时索引不生效,退化成全表扫描,数据量一大就慢到没法用。
触发器:全文检索向量自动维护
你只管写 content,search_content 由数据库自动填。
每次插入或更新子块时,数据库自动把「上下文前缀」和「正文」切成中文词元,分别打上 B 权重和 A 权重后拼起来存好,检索时直接用。
CREATE OR REPLACE FUNCTION child_chunks_tsvector_trigger()
RETURNS trigger AS $$
BEGIN
    NEW.search_content :=
        setweight(to_tsvector('zh_cfg', COALESCE(NEW.context_prefix, '')), 'B') ||
        setweight(to_tsvector('zh_cfg', COALESCE(NEW.content, '')), 'A');
    RETURN NEW;
END;
$$ LANGUAGE plpgsql;
注意 A 和 B 两个权重:正文权重 A(高),上下文前缀权重 B(低)。这样排序时,正文里命中的词比前缀里命中的词更值钱,一个很实用的细节。
五、验证:三路检索都真的能用
建完表,跑一遍这三个查询确认地基合格。
① 中文分词
SELECT to_tsvector('zh_cfg', '支付网关配置说明');预期输出:
'支付':1 '网关':2 '说明':4 '配置':3✅ 正确切出了「支付」「网关」「配置」「说明」四个词,说明 zhparser 工作正常。注意输出是按词元排序的,不是按出现顺序,所以位置编号看起来是乱的。
② 模糊匹配
SELECT similarity('支付网关', '支付网关') AS 完全一样,
       similarity('支付网关', '支付网')   AS 少一个字;
预期输出:
 完全一样 | 少一个字
----------+----------
        1 |      0.5
✅ 完全一样是 1,少一个字掉到 0.5,说明 pg_trgm 在 C.UTF-8 下确实把中文当字符在处理。中文掉分比英文狠(四个字只剩三个三元组重叠),这就是第 6 篇要把阈值从默认 0.3 调到 0.2 的原因。
③ 向量检索
向量查询需要表里真有带向量的行。手工插一条最小数据(1024 维向量用 repeat 生成,不用手敲一千个数):
INSERT INTO documents (id, file_name, file_type)
VALUES ('11111111-1111-1111-1111-111111111111', 'test.pdf', 'pdf');

INSERT INTO parent_chunks (id, document_id, seq, title, content)
VALUES ('22222222-2222-2222-2222-222222222222',
        '11111111-1111-1111-1111-111111111111',
        0, '回调配置', '商户可修改回调通知地址');

INSERT INTO child_chunks (id, parent_id, document_id, seq, content, embedding)
VALUES ('33333333-3333-3333-3333-333333333333',
        '22222222-2222-2222-2222-222222222222',
        '11111111-1111-1111-1111-111111111111',
        0, '商户可在开发配置页修改回调通知地址',
        ('[' || repeat('0.1,', 1023) || '0.1]')::vector);
然后用同一个向量去查:
SELECT c.content,
       1 - (c.embedding <=> ('[' || repeat('0.1,', 1023) || '0.1]')::vector) AS score
FROM child_chunks c
ORDER BY c.embedding <=> ('[' || repeat('0.1,', 1023) || '0.1]')::vector ASC
LIMIT 5;预期结果:第一行就是刚插的那条,score = 1,同一个向量和自己的余弦距离是 0,换算成相似度就是 1。
用完清掉(删文档会级联删掉父块子块):
DELETE FROM documents WHERE id = '11111111-1111-1111-1111-111111111111';✅ <=> 是余弦距离(越小越像),<-> 是欧氏距离,别混。配合前面的 HNSW 索引,这就是第 6 篇向量通道的全部秘密。
六、把服务跑起来
数据库只是地基。后面每篇的 curl 都打在后端服务上,这一节把它和前端一起起起来。
1. 先备齐 4 个 Key
系统在启动那一刻就检查凭证,缺任何一个直接启动失败(这是刻意的 Fail-Fast,第 9 篇讲)。先把 Key 备齐:
| 环境变量 | 去哪申请 | 干什么用 |
|---|---|---|
KB_CHAT_API_KEY | 小米 MiMo 开放平台 | 问答生成(Chat) |
DASHSCOPE_EMBEDDING_API_KEY | 阿里云百炼 | 子块向量化 |
DASHSCOPE_RERANK_API_KEY | 阿里云百炼 | 检索结果重排 |
KB_DB_PASSWORD | 自己定 | 数据库密码,和上一步 docker compose 用的是同一个 |
KB_CHAT_API_KEY 对应对话生成模型。项目默认对接小米 MiMo(base-url 默认 https://api.xiaomimimo.com,模型 mimo-v2.6-flash);想换别家就改 KB_CHAT_BASE_URL 和模型名,只要是 OpenAI 兼容协议都行。
百炼的 Embedding 和 Rerank 是两个独立的 Key,端点前缀也不一样(compatible-mode vs compatible-api/v1),混用会 404,第 6 篇会再提一次。
2. 起后端
export KB_CHAT_API_KEY='...'
export KB_DB_PASSWORD='换成你自己的强密码'
export DASHSCOPE_EMBEDDING_API_KEY='...'
export DASHSCOPE_RERANK_API_KEY='...'

mvn spring-boot:run
看到 Started RagApplication in ... seconds 这行就算成功。如果启动直接抛 XXX 未配置,就是上面哪个 Key 没 export 对。
3. 起前端
另开一个终端:
cd frontend
pnpm install
pnpm dev
打开 http://localhost:5173。开发模式下 Vite 把 /api 开头的请求代理到 http://127.0.0.1:8080,前端不用配任何后端地址。
到这里,上传一份文档、点一下"向量化"、去问答页提个问题,整条链路就通了。后面 7 篇把每一环拆开看。
⚠️ 常见错误与排错
Q1:改了建表 SQL,重启容器后没生效?
init 脚本只在数据卷为空时执行一次。 这是 Docker 官方镜像的行为。
docker compose down -v     # ⚠️ 会删除所有数据
docker compose up -d --build
或者手动执行:
docker exec -i eon-rag-db psql -U postgres -d eon_rag < docker/init/001_schema.sql(建表脚本是幂等的,手动重跑安全。)
Q2:SELECT to_tsvector('zh_cfg', ...) 报错「text search configuration zh_cfg does not exist」?
说明 zh_cfg 配置没建成功。检查 init 脚本里那段 DO $$ ... END $$; 是否执行了,或者手动补:
CREATE TEXT SEARCH CONFIGURATION zh_cfg (PARSER = zhparser);
ALTER TEXT SEARCH CONFIGURATION zh_cfg
    ADD MAPPING FOR n,v,a,i,e,l,j,b,d,f,m,q,r,s,t,x,z WITH simple;
Q3:端口 15432 连不上?
确认容器在跑、端口映射正确:
docker ps | grep eon-rag-db
# 预期看到:0.0.0.0:15432->5432/tcp
注意宿主端口是 15432 不是 5432(避免和你本机已有的 PG 冲突)。项目默认连接串就是 jdbc:postgresql://127.0.0.1:15432/eon_rag。
Q4:为什么用 15432 这种怪端口?
因为很多人本机已经装了 PostgreSQL 占了 5432。错开端口能省掉一次"我明明配对了却连不上"的排查。
本篇小结
- 一个 PostgreSQL + 三个扩展(pgvector / zhparser / pg_trgm)就能覆盖向量、中文全文、模糊三路检索,省下三套中间件的运维。
POSTGRES_INITDB_ARGS: "--locale=C.UTF-8"是中文检索能不能用的前提,写成C会让pg_trgm静默忽略所有中文,不报错,就是查不出来。child_chunks是心脏:embedding存向量、search_content由触发器自动维护、meta存定位信息。- 三个索引各伺候一路,向量索引的
vector_cosine_ops后缀不能丢。 - 建表脚本是幂等的,但 init 目录只在数据卷为空时自动执行,改了 SQL 要手动重跑或
down -v。
下一篇预告
仓库盖好了,下一步是往里搬货。
但 PDF、Word、Excel、PPT、HTML、Markdown……每种格式的结构都不一样。如果直接把它们压成纯文本,章节层级、表格行列、页码就全丢了,后面切块只能瞎切。
下一篇我们做一件很关键的事:给所有格式定义一个统一的"中间表示",让下游彻底不用关心文件原来是什么格式。
下一篇预告:漏斗把 PDF / Word / Excel / PPT 倒成一排整齐积木。
课程章节
02|地基:一个 PostgreSQL 扛下三种检索
正在检查解锁状态…