07|组装:父块上卷与 Token 预算(第 4 篇埋的伏笔,这里揭晓)
第 4 篇我们问过:小块切出来是为了检索准,那生成时怎么办? 现在揭晓答案。
顺便解决一个很现实的问题:大模型的"书包"就那么大。
本篇偏实现。只想把系统用起来、不打算自己写组装逻辑的读者,读第一节和「本篇小结」就够。
本篇你能学到
- 命中的小碎片怎么"吸"回各自的大父块
- 父块打分公式:为什么"多个子块同时命中"要额外加分
- Token 预算怎么算,装不下时怎么优雅降级
- 一个反直觉的结论:高分父块优先完整呈现
一、为什么不能直接把子块丢给模型?
假设检索返回了 15 个子块,每个约 300 Token,总共 4500 Token。看起来挺好,直接丢给模型?
问题是这些子块是碎片。比如命中了这么一段:
"生效前请保持旧地址可用。"模型看到这一句,会懵:什么东西生效前?旧地址是什么地址?
但如果它看到的是这个子块的父块:
3.2 回调配置

商户可在「开放平台 → 开发配置」中修改回调通知地址。
修改后 5 分钟生效,生效前请保持旧地址可用。
如需更换域名,请提前 3 个工作日提交工单报备。
完整、可读、能直接引用。 这就是第 4 篇说的"大块负责被读懂"。
上卷:命中子块 → 找到它的父块
按父块分组 ← 空表
遍历 每个命中子块:
    按父块分组[子块.父块ID].追加(这个子块)
因为第 4 篇保证了"子块绝不跨父块",所以每个子块有且只有一个父块,上卷关系天然确定,不需要任何模糊匹配。
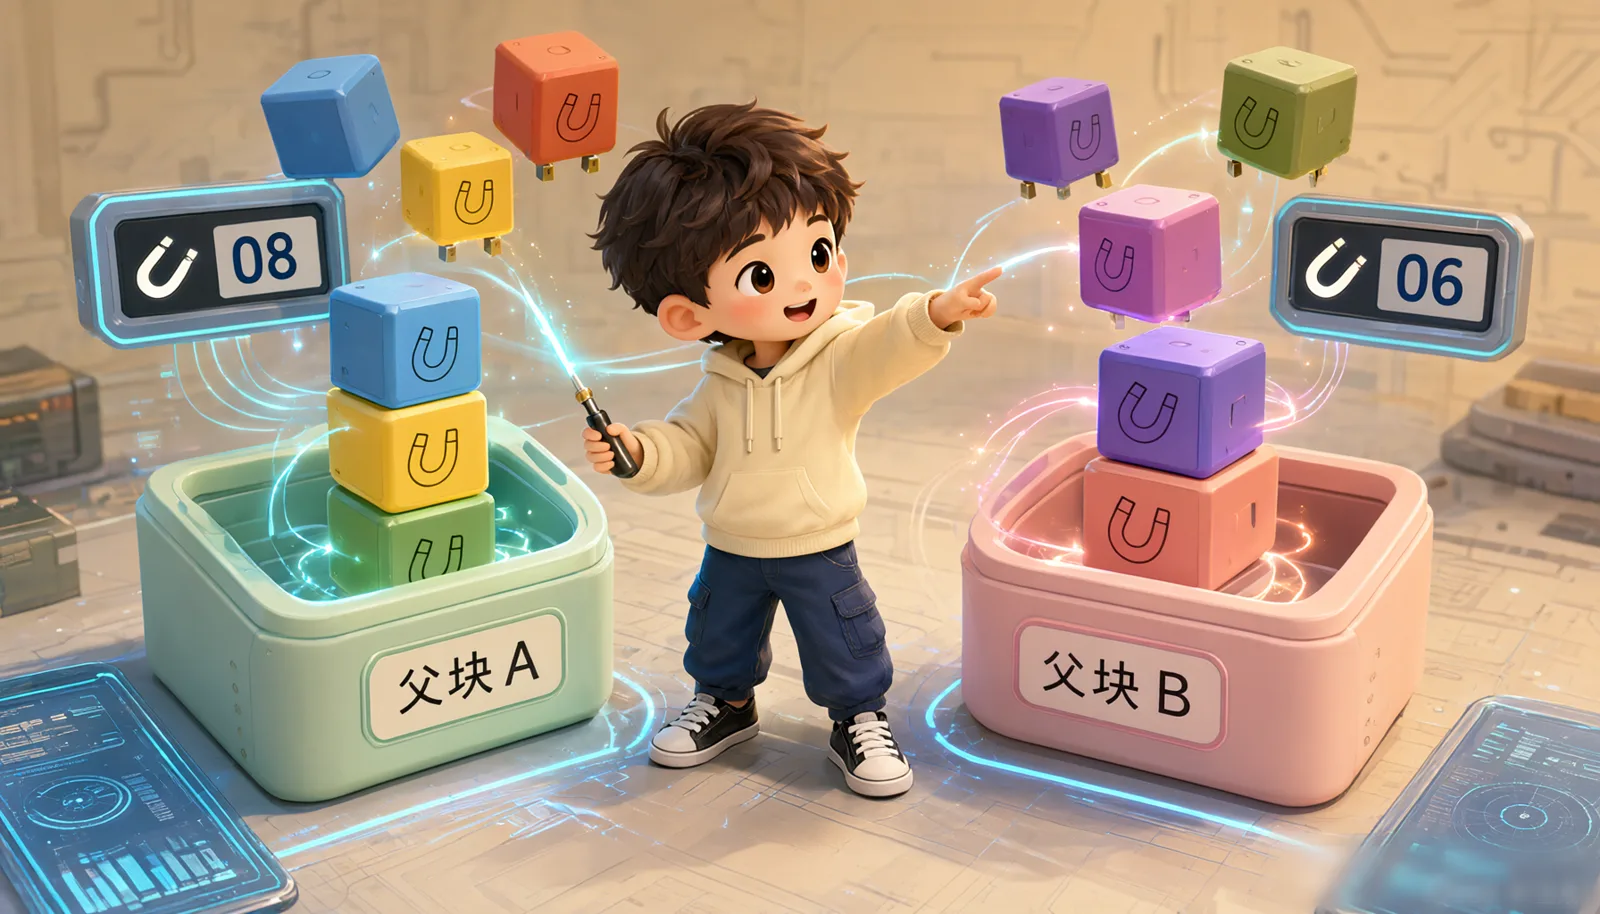
一个额外好处:去重。 15 个子块可能只属于 6 个父块。上卷后,模型看到的是 6 段完整内容,而不是 15 段碎片,同样的信息量,可读性天差地别。
二、父块打分:命中越多越可信
如果两个子块都命中了同一个父块,说明这个父块跟问题高度相关。所以:
父块得分 = max(它所有命中子块的分数) + α × (命中子块数 - 1)α(parent-hit-bonus-weight)默认 0.05。
最高分 ← 该父块所有命中子块里的最高分
加分   ← 0.05 × (命中子块数 - 1)
父块得分 ← 最高分 + 加分
算个例子
父块 A:命中 3 个子块,最高分 0.91
得分 = 0.91 + 0.05 × (3 - 1) = 0.91 + 0.10 = 1.01父块 B:命中 1 个子块,分数 0.93
得分 = 0.93 + 0.05 × 0 = 0.93结果:父块 A 赢了,尽管它的单块最高分更低(0.91 < 0.93)。
理由很直观:三个不同位置都命中了,比一个位置命中更可信。 这跟 RRF 的思想是一脉相承的,多路/多次认可 > 单次高分。
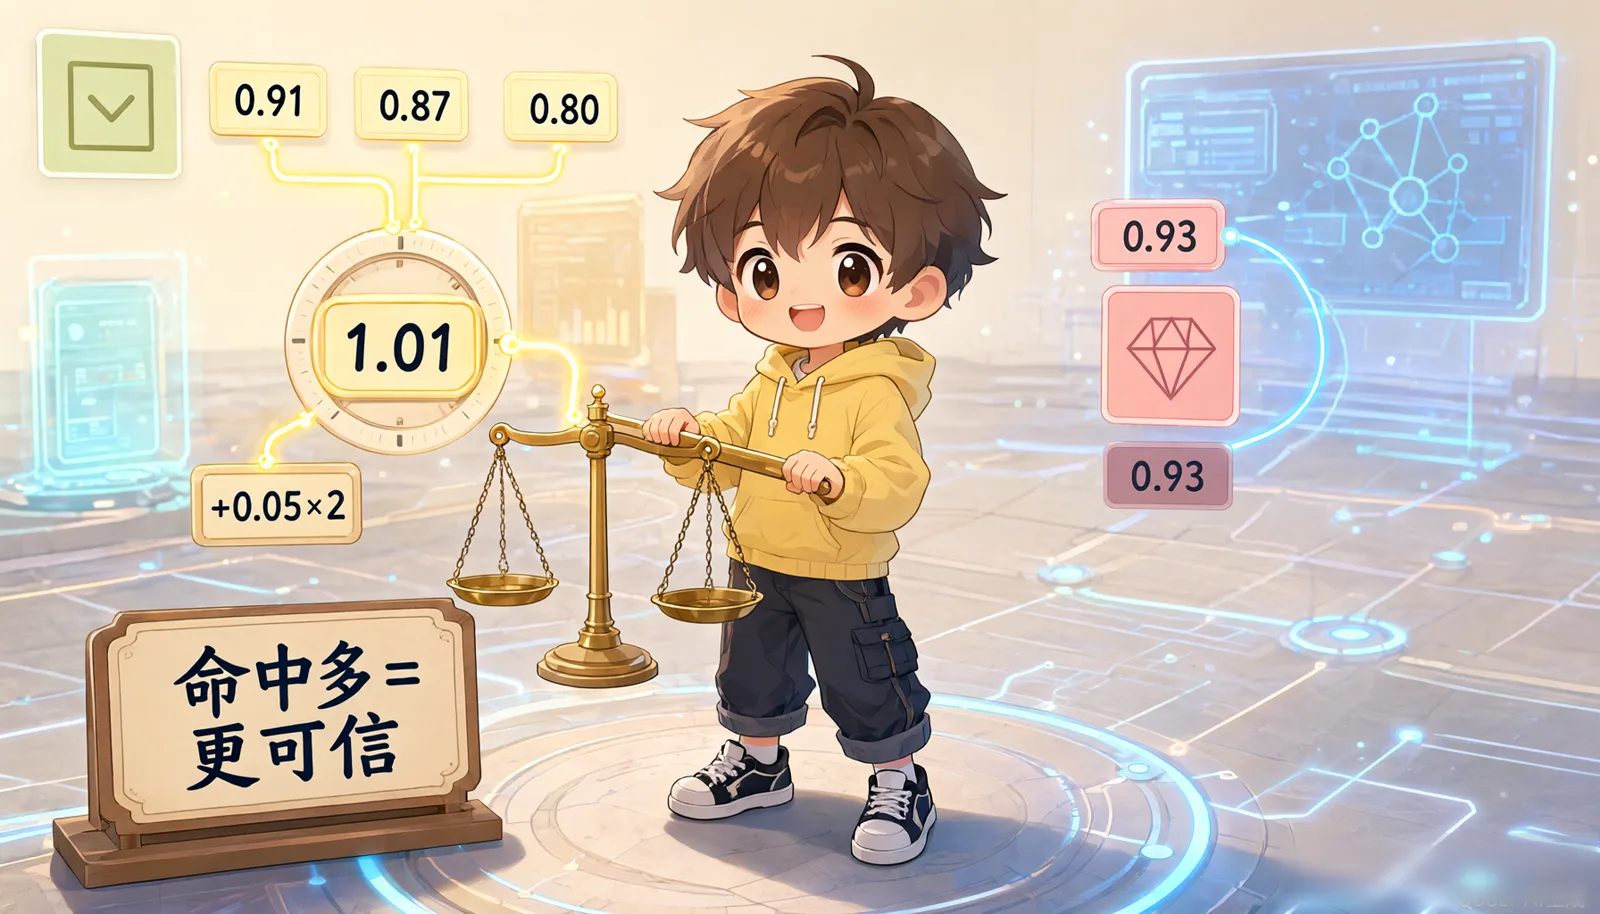
降级时 α 会归零:Rerank 失败时我们用的是 RRF 分数,量纲不同,加分就没有意义了,所以代码里把 hitBonusWeight 置为 0。
三、Token 预算:书包就那么大
现在有 6 个排好序的父块,但不能全塞给模型。
两个原因
- 输入长度有上限,超了直接报错;而且输入按 Token 计费,塞得多就是钱。
- 效果反而差:塞太多无关内容会稀释模型注意力。
预算怎么算
预算 ← 上下文总预算(6000)
        − 输出预留(1000)
        − 模板固定开销(200)
        − 问题本身的 Token 数
四项扣减,一个都不能少:
| 扣减项 | 默认 | 为什么 |
|---|---|---|
| 上下文总预算 | 6000 | 留给"参考资料"的总额度 |
| 输出预留 | 1000 | 必须给模型的回答留地方 |
| 模板开销 | 200 | 指令文字、[n] 编号、context 标签 |
| 问题本身 | 动态 | 问题越长,能装的资料越少 |
举例:问题 10 Token,则预算 = 6000 - 1000 - 200 - 10 = 4790 Token。
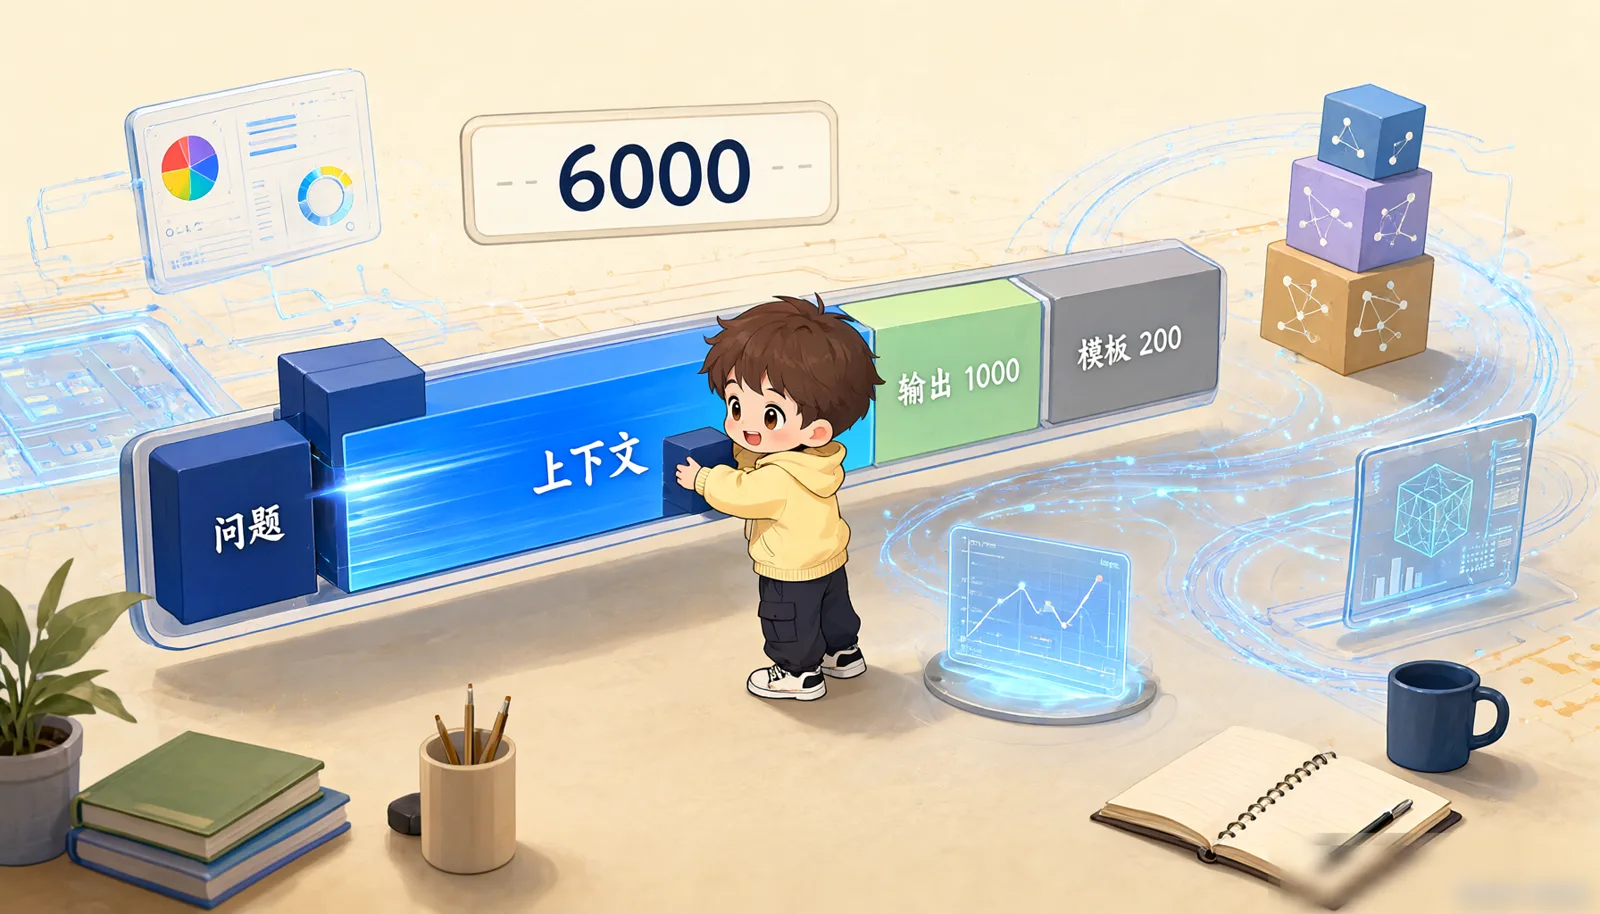
装载规则:依次装,装不下就降级
剩余预算 ← 预算
遍历 每个候选父块(已按得分从高到低排好):
    如果 剩余预算 ≤ 0: 停止

    如果 这个父块.Token数 ≤ 剩余预算:
        ① 整个父块装进去
        剩余预算 ← 剩余预算 − 这个父块.Token数
    否则:
        ② 装不下 → 降级为局部窗口
        窗口 ← 取"命中子块 ±1"的局部内容(这个父块, 命中子块, 剩余预算)
        如果 窗口 非空:
            装进去
            剩余预算 ← 剩余预算 − 窗口.Token数
注意这个循环是"按分数降序依次装",不是"平均分"。 这带来一个反直觉但正确的结果:
高分父块优先完整呈现,低分父块可能根本进不来。
这是刻意的:宁可少给几段高质量完整内容,也不要为了凑数把每段都切得七零八落。
四、降级:装不下就只给"命中处附近"
一个父块有 1200 Token 而预算只剩 400 时,不装整个父块,只装「命中的那个子块 ± 左右各 1 个邻居」。
① 最佳子块 ← 这个父块里得分最高的那个命中子块

② 窗口 ← 查出 序号在 [最佳子块.seq − 1, 最佳子块.seq + 1] 之间的子块
        (即左邻 + 自己 + 右邻)

③ 遍历 窗口里的每个子块:
        如果 已用Token + 这个子块.Token数 > 剩余预算: 停止
        拼接这个子块的正文
        已用Token ← 已用Token + 这个子块.Token数
对应 SQL(利用 (parent_id, seq) 的唯一索引,非常快):
在同一个父块里,取序号落在 [中心序号−1, 中心序号+1] 范围内的子块,按序号排好,就是左邻、自己、右邻。
SELECT ... FROM child_chunks c
WHERE c.parent_id = #{parentId}
  AND c.seq BETWEEN #{centerSeq} - 1 AND #{centerSeq} + 1
ORDER BY c.seq ASC
取 ±1 而不是只给命中的那一个,是因为子块之间有重叠,只给一个块仍然可能缺上下文。带上左右邻居,能覆盖到命中点前后完整的语境。
如果连窗口都装不下,就整个丢弃这个父块(返回 null),继续看下一个。绝不为了塞进去而把内容截断成半句话。
Token 数不准时的兜底
子块的 token_count 列是 NOT NULL DEFAULT 0,正常一定有值;万一读到 0(比如手工插进去的数据),有个估算兜底:
遍历 每个字符:
    如果 字符 > 0x2E7F:  累计 + 1.5     # 中文
    否则:                累计 + 0.25    # 英文数字标点
保证任何情况下预算计算都不会崩。
五、看一次组装日志
以下为示意输出:字段与真实日志一致,数值为示例。
retrieval stage=rerank.done queryId=a3f2 returned=15 elapsedMs=310 topScore=0.912
retrieval stage=aggregate   queryId=a3f2 segments=6 budget=4790 usedTokens=4210 totalMs=561
怎么读:
- 15 个精排子块上卷成 8 个候选父块,最终装进 6 段(去重效果明显)
- 预算 4790,实际用了 4210,还剩 580
- 整个检索链路 561ms
如果想看更细的降级情况,开 DEBUG 日志:
aggregate grouped candidateParents=8 loadedParents=8 budgetTokens=4790
aggregate done candidateParents=8 segments=6 degraded=2 usedTokens=4210 remaining=580
degraded=2 说明有 2 个父块被降级成了局部窗口,candidateParents=8 但 segments=6 说明有 2 个根本没装进来。
开启方式(临时,别常开):
java -jar eon-rag.jar --logging.level.cn.kong.eon.rag=DEBUG⚠️ 常见错误与排错
Q1:召回了 15 条,答案里却只出现 [1] [2] [3]?
正常。15 是子块数,模型看到的是父块。上卷之后 15 个子块可能只归属 8 个父块,再被预算裁掉几个,最后送进提示词的可能只有 3 段,编号就是 1、2、3。
编号本身永远连续,不会跳号:编号只在父块真正装进预算时才分配,装不进的父块不占号。所以 [1] [3] 中间缺 [2] 不是裁剪造成的,去查提示词或模型输出。
如果最终段数太少、答案明显缺上下文,说明预算太小或父块太大:
- 调大
kb.chat.max-context-tokens(默认 6000) - 或调小
kb.chunk.parent.max-tokens(默认 1200)
Q2:答案经常说"未找到相关信息",但明明有相关内容?
检查三处:
retrieval stage=aggregate ... segments=0?说明预算被吃光了,最常见原因是问题本身太长,或者output-reserve-tokens设太大。segments > 0但答案仍说没有?那是提示词或模型的问题,看第 8 篇。- 开了 DEBUG 看
degraded数量,如果几乎全部降级,说明父块普遍过大。
Q3:能把所有父块都塞进去吗?我把预算调到 30000 试试?
不建议。 三个理由:
- 费用:输入 Token 是钱。
- 效果:塞太多无关内容,模型注意力被稀释,答案反而变差(这叫"迷失在中间",模型对长上下文中间部分的关注度显著更低)。
- 延迟:输入越长,首字越慢。
正确做法是让检索更准,而不是让上下文更大。
Q4:output-reserve-tokens 是什么,能设成 0 吗?
它是给模型的回答预留的位置。 设成 0 意味着模型可能在写到一半时被长度限制截断,答案会突然断在半句话。
默认 1000 Token 约等于 700~1500 个中文字。如果你的答案普遍很短可以调小,但别设 0。
Q5:父块打分里的 α 能调吗?
可以,kb.search.parent-hit-bonus-weight,默认 0.05。
- 调大:更偏好"多个子块同时命中"的父块(更保守、更相关)
- 调小:更看重单次最高分(更激进)
一般不用动。 除非你发现答案老是引到同一个大而全的章节,那可以调小 α。
本篇小结
- 上卷:命中的小碎片吸回各自的大父块,模型看到的是完整章节而不是半句话。
- 父块得分 = 最高子块分 + 0.05 ×(命中数-1),多次命中比单次高分更可信;Rerank 降级时 α 归零。
- Token 预算 = 总预算 - 输出预留 - 模板开销 - 问题长度,四项缺一不可。
- 按分数降序依次装载,高分父块优先完整呈现,宁缺毋滥,绝不把内容切碎凑数。
- 装不下就降级为「命中块 ±1」的局部窗口,连窗口都装不下就整个丢弃。
下一篇预告
内容组装好了,最后一步:让模型开口说话。
但这里有个体验上的分水岭,让用户盯着空白等 20 秒,和让用户看着文字一个字一个字蹦出来,是完全不同的两种产品。
下一篇讲 SSE 流式输出:
- 后端怎么把答案"一段一段"推给前端
- 四种事件(引用 / 正文 / 结束 / 报错)怎么约定
- 生成卡住了怎么办(超时看门狗)
- 前端怎么把
[1]这种角标变成能点开的引用卡
下一篇预告:一条从 citations 到 done 的事件时间轴。
课程章节
07|组装:父块上卷与 Token 预算(第 4 篇埋的伏笔,这里揭晓)
正在检查解锁状态…