03|解析:把五花八门的文档变成统一积木
仓库盖好了,现在往里搬货。 但你手上有一份 PDF、一份 Word、一个 Excel、一套 PPT,它们的"内部结构"完全不同。
如果一股脑压成纯文本,章节、表格、页码全没了,后面切块只能瞎切。
本篇你能学到
- 为什么"提取纯文本"是 RAG 最常见的错误起点
- 怎么用一套统一的"积木"(Block)描述所有格式
- 7 种格式各自该用什么工具解析,以及为什么
- 怎么一眼识破"扫描件",避免给一堆图片做无用功
一、反面教材:直接压成纯文本会怎样?
很多教程的第一步是这么写的:
❌ 常见但错误的做法:
    文本 ← 解析器.把整个文件读成字符串()
    切块列表 ← 按长度硬切(文本, 500 字)
看起来能跑,实际上埋了三颗雷:
| 丢了什么 | 后果 |
|---|---|
| 标题层级 | 不知道哪段属于哪一章,切块时把"3.1 结算规则"和"4.2 退款流程"切进同一块 |
| 表格结构 | 表格变成一堆散乱的数字,问"2024 年费率是多少"永远答不对 |
| 页码定位 | 答案无法回指原文,用户没法核对 |
解析层丢掉的结构信息,后面所有环节都补不回来。
二、解法:定义一套统一的"积木"
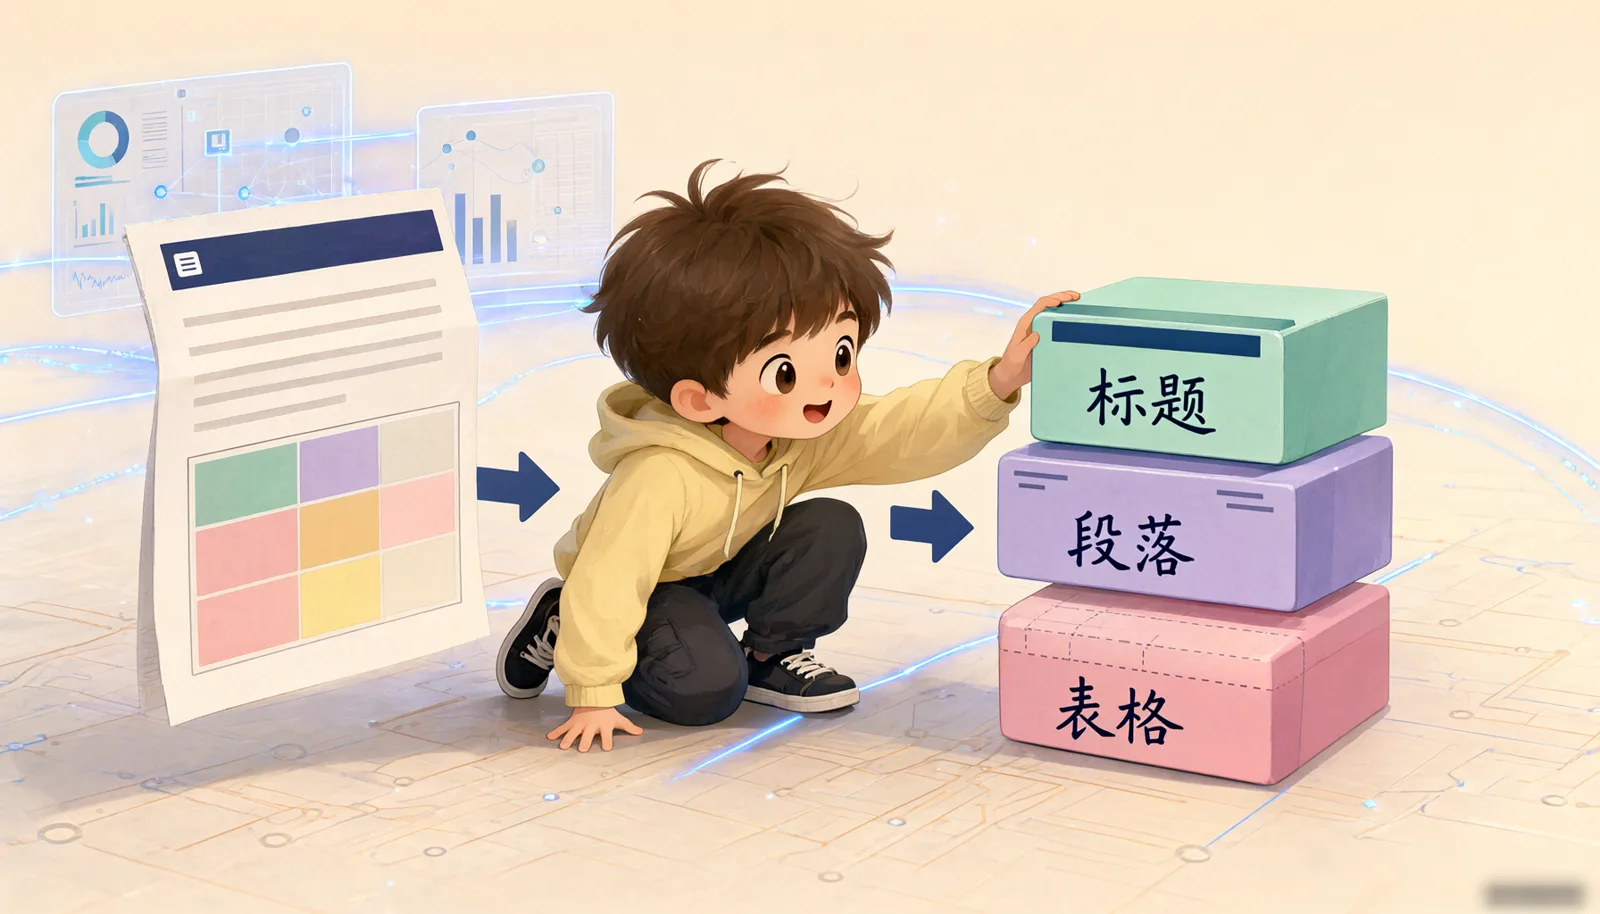
我们不输出纯文本,而是输出一个有序的积木列表。每块积木长这样:
结构 积木块(Block):
    type       类型,六种取值:
                   HEADING    标题
                   PARAGRAPH  段落
                   LIST       列表
                   CODE       代码块
                   TABLE      表格(内容是 Markdown 管道表格)
                   SLIDE      单页幻灯片
    level      标题层级 1~6(非标题为 0)
    text       文本内容(表格用 Markdown 表示)
    startPage  起始页码(无页概念的格式填 0)
    endPage    结束页码
    meta       定位元数据:page_number / sheet_name / slide_number / title / rows
file_name 不在这份 meta 里,它是摄入落库时写进父块 meta 的,引用回指时靠它显示文件名。
一个真实例子
一份 Word 文档里有这么一节:
3.2 回调配置                    ← Heading 2 样式
商户可在开发配置页修改回调地址:  ← 普通段落
┌ 参数  说明 ┐                 ← Word 表格
│ url  │ 回调地址 │
└──────┴──────┘
解析后变成:
Block[0] HEADING   level=2  "3.2 回调配置"               meta={}
Block[1] PARAGRAPH level=0  "商户可在开发配置页修改…"      meta={}
Block[2] TABLE     level=0  "| 参数 | 说明 |\n|---|…"    meta={rows: 2}
下游的分块层拿到这个列表,就知道:这是一个二级标题开头的章节,里面有个表格,于是能做出正确的切分决策。 它完全不需要知道原文件是 Word 还是 Markdown。
PDF 是个例外:表格识别不出来
上面三种块,Word / Markdown / PPT 都能产出(Excel 只产 TABLE 一种)。PDF 不行。
PDF 内部没有"这是表格"的标记,PDFBox 拿到的只是一股文本流。所以本地解析 PDF 只产出 HEADING 和 PARAGRAPH 两种块:表格会被压成一段没有行列结构的段落文本,问"2024 年费率是多少"就再也拼不回来了。
PDF 唯一比别的格式多的信息是页码:startPage / endPage 和 meta.page_number 只有它有,Word / Markdown 都填 0。
要保住 PDF 里的表格结构,两条路:开云端解析(LlamaParse 有版面识别,第 4 节讲),或者直接上传 Word / Excel / Markdown 原件。
一个关键约定:表格和幻灯片是"原子块"
规则:
    如果 type 是 TABLE 或 SLIDE:
        那么 这是原子块 → 不可分割
    否则:
        这是普通文本块 → 可以和相邻内容合并
原子块 = 不可分割。 解析阶段必须整块输出,绝不在解析层把它切碎。
表格一旦被切开,行列关系就断了;一页 PPT 被切成两半,各自都不完整。第 4 篇讲分块时你会看到,原子块会独占一个父块。
三、7 种格式,7 套工具
不要指望一个库搞定所有格式,那样必然每种都做得平庸。我们按格式特征分别选型:
| 格式 | 用什么解析 | 关键处理 |
|---|---|---|
| Apache PDFBox | 逐页提取,页码写进 meta;靠字号跳变、加粗、短行特征猜标题 | |
| DOCX | Apache POI(XWPF) | 按 Heading 1..6 样式映射层级;表格直接读单元格矩阵 |
| DOC(老格式) | Tika → HtmlParser | Tika 导出 XHTML,jsoup 消毒 + flexmark 转 Markdown,再走 Markdown 解析 |
| XLSX / XLS | Apache POI | 每个工作表产出一个 TABLE 块,首行当表头 |
| PPTX / PPT | POI(XSLF)/ Tika | pptx 每页幻灯片一个 SLIDE 块,带 slide_number;老 ppt 走 Tika,同 DOC |
| HTML | jsoup + flexmark | jsoup 先消毒防 XSS,再转 Markdown |
| MD | flexmark AST | 直接读 Markdown 语法树,标题/代码块/表格一目了然 |
| TXT | 自研 TxtParser | 先剥 BOM;UTF-8 严格解码失败就回退 GBK(中文 Windows 导出的 txt 十有八九是它),再按空行分段 |
注意 PDF 那行的"猜"字:PDF 内部没有"这是标题"的标记,只能靠视觉特征推断。这也是 PDF 效果通常不如 Word 的根本原因,不是我们不用力,是格式先天不足。这也是为什么我们提供云端解析作为备选。
解析器怎么被找到:一个 Map 就够了
路由表 ← 空表
遍历 每个解析器:
    遍历 该解析器声明的扩展名:
        路由表[扩展名] ← 这个解析器
每个解析器自己声明负责哪些扩展名:
以 ExcelParser 为例:
    声明扩展名 ← ["xls", "xlsx"]
扩展新格式只需要两步:写一个实现 DocumentParser 的类,声明 extensions()。路由层一行代码都不用改。
四、解析路由:本地还是云端?
三种模式,用配置切换:
kb:
  parse:
    mode: AUTO                          # AUTO / LOCAL / CLOUD
    cloud-types: pdf,doc,docx,ppt,pptx  # AUTO 模式下优先走云端的格式
    cloud:
      enabled: false                    # 默认关闭
路由逻辑(伪代码):
按 mode 分流:
    如果 mode 是 LOCAL: 返回 本地解析(文件字节, 扩展名)
    如果 mode 是 CLOUD: 返回 云端解析(文件字节, 扩展名, 文件名)
    否则(即 AUTO):      返回 自动解析(文件字节, 扩展名, 文件名)

函数 自动解析(文件字节, 扩展名, 文件名):
    如果 扩展名 在 云端白名单 里 并且 云端客户端已装配:
        尝试:
            返回 云端解析(...)
        捕获任何异常:
            记日志("云端解析失败,回退本地")   # ← 关键:不让它炸
    返回 本地解析(...)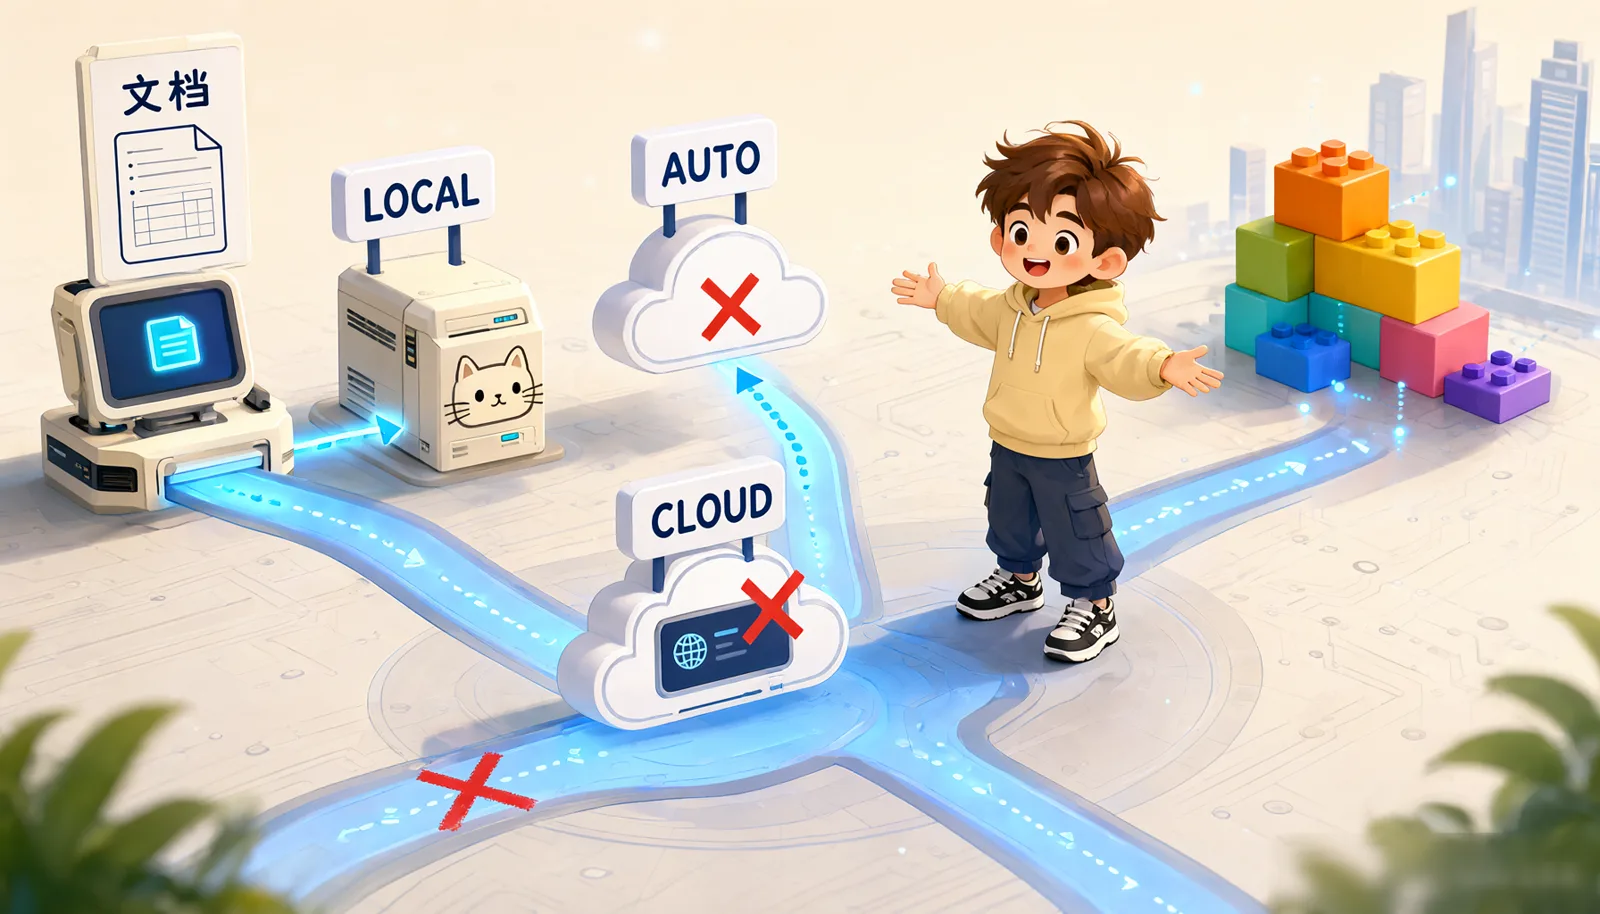
这个"失败回退"的设计很重要:云端服务会限流、会超时、会欠费。有了回退,最坏情况只是效果差一点,而不是整批文档导入失败。
云端解析走的也是同一套积木,LlamaParse 返回 Markdown,我们再用 Markdown 解析器转成 Block。所以云端和本地的产物完全一致,下游无感知。
什么时候该开云端?
| 场景 | 建议 |
|---|---|
| 普通文字版 PDF / Word | 本地就够,省钱 |
| 扫描件(图片型 PDF) | 必须开云端,或先做 OCR |
| 复杂跨页表格、多栏排版 | 开云端,效果明显更好 |
| 预算紧张 / 数据不能出内网 | 保持本地 |
开启方式(开启后必须配 Key,否则启动直接失败):
export LLAMA_CLOUD_ENABLED=true
export LLAMA_CLOUD_API_KEY='llx-xxx'
export KB_PARSE_MODE=AUTO
五、扫描件检测:别给一堆图片做无用功
这是解析层最容易省、但最该做的一步。
用户上传了一份扫描件,看起来是 PDF,其实是一页页图片,里面一个字都没有。
如果不检测,流程会一路走到向量化:给一堆空文本算向量、写数据库、花掉真金白银,最后用户问什么都答不出来。
检测逻辑(简单得出奇)
函数 检查是否为扫描件(每页文本列表, 整篇字符阈值):
    有效字数 ← 去掉所有空白后统计(拼接(每页文本列表))

    # 规则 1:整篇有效字符太少(阈值默认 50)
    如果 有效字数 < 整篇字符阈值:
        抛错(NEEDS_OCR, "疑似扫描件…")

    # 规则 2:按页平均(PDF 才有页的概念)
    如果 每页文本列表 非空:
        页均 ← 有效字数 ÷ 页数
        如果 页均 < 10:          # 每页平均不到 10 个字
            抛错(NEEDS_OCR, "疑似扫描件…")
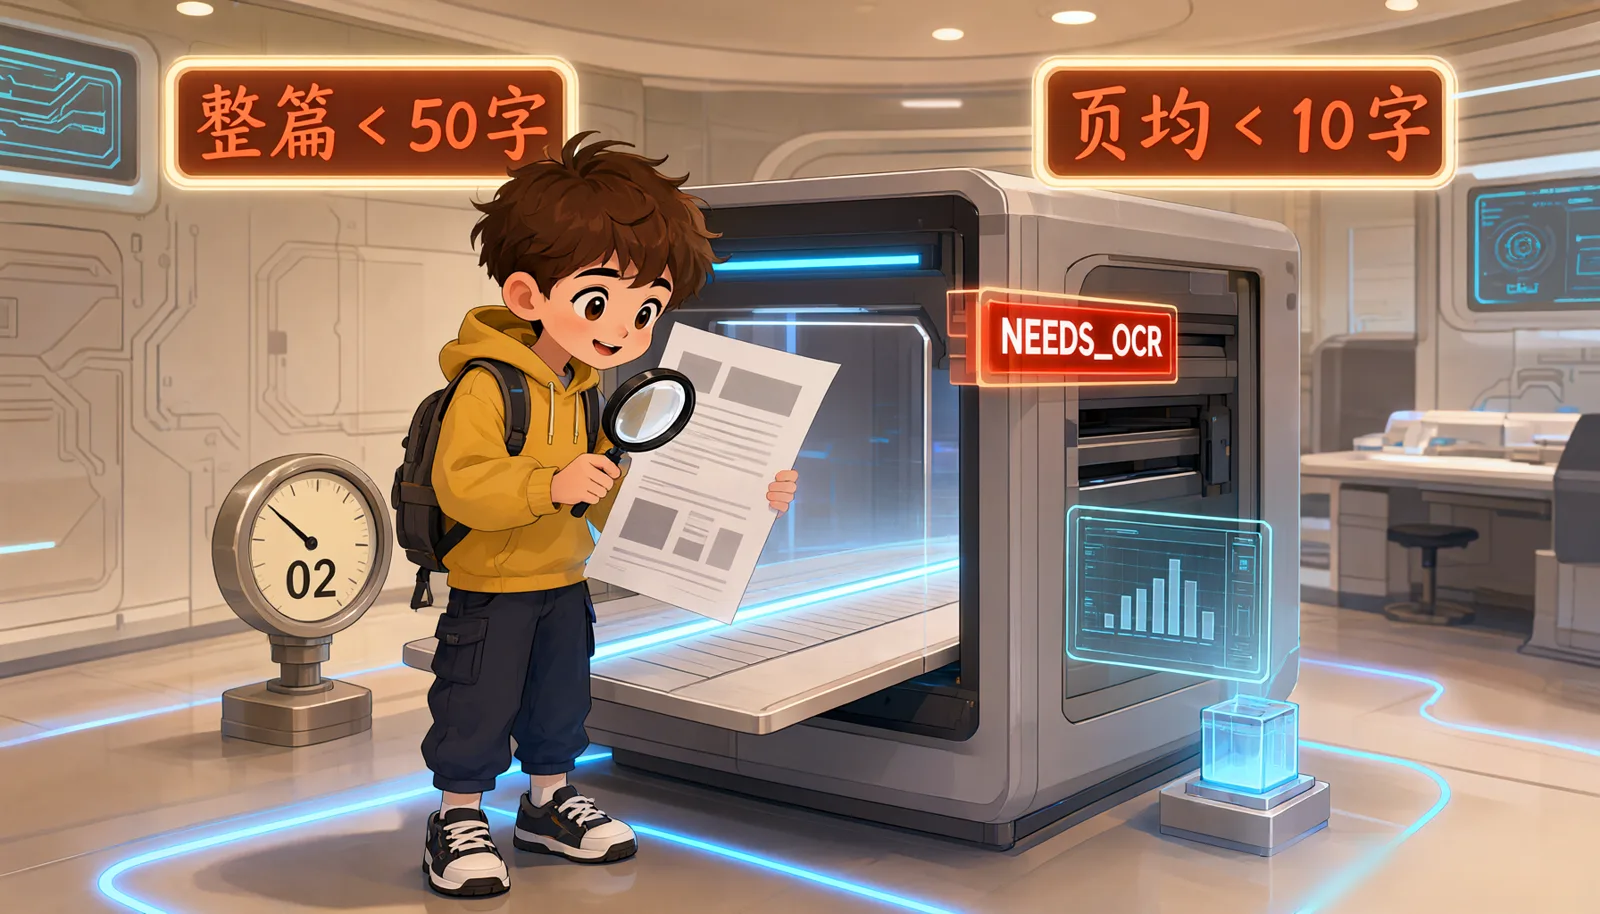
两条规则的分工:
- 规则 1(整篇 < 50 字):抓"整份文档都是图片"。
- 规则 2(页均 < 10 字):抓"大部分页是图片,只有几页有字",这种更隐蔽,单看总量可能过关。
命中后,文档状态被标记为 NEEDS_OCR,界面上直接提示用户:"疑似扫描件,请上传文字版文档或开启云端解析"。
这一步省下的不只是钱,还有用户的时间,让他 3 秒内知道问题,而不是等十分钟才发现导入了个寂寞。
⚠️ 常见错误与排错
Q1:导入成功了,但文档状态是 FAILED,怎么办?
先看错误信息(error_message 字段):
curl http://127.0.0.1:8080/api/documents/<文档ID>
# 关注 errorMessage 字段
按错误码对症下药:
| 错误码 | 含义 | 解法 |
|---|---|---|
UNSUPPORTED_FORMAT | 本地解析器不认识这个扩展名 | 开云端解析,或把格式加进 cloud-types |
NEEDS_OCR | 疑似扫描件 | 换文字版文档 / 开云端解析 |
PARSE_FAILED | 解析过程报错 | 看日志,多半是文件损坏或内存不足 |
Q2:PDF 解析出来标题层级全乱了?
这是 PDF 的先天缺陷,不是 bug。 PDF 里没有"标题"这种标记,只能靠字号、加粗、行长短来猜。
三个应对:
- 优先上传 Word / Markdown 原件(有明确的标题样式);
- 开云端解析,LlamaParse 的版面识别更准;
- 用第 9 篇讲的切片编辑功能手工修,这是兜底方案,也是这套系统留给你的后门。
Q3:Excel 导入后,每个 Sheet 变成了一个巨大表格?
这是设计如此:每个工作表产出一个原子 TABLE 块,保证表格结构完整。第 4 篇会讲超长表格怎么按行拆分并重放表头。
Q4:HTML 导入有安全风险吗?
我们做了处理:jsoup 会先整块删掉 script / style / noscript / iframe / object / embed 这些标签再转 Markdown。即便如此,前端渲染原文时仍要用 DOMPurify 再消毒一次(第 8 篇会提到)。两层防护,别省任何一层。
Q5:为什么我改了 cloud-types 却没生效?
检查两件事:
LLAMA_CLOUD_ENABLED是不是true?客户端没装配时,AUTO 模式所有格式都走本地。- 扩展名是不是小写、不带点?配置里写
pdf不是.pdf。
本篇小结
- 解析层丢掉的结构,后面补不回来,"提取纯文本"是 RAG 最常见的错误起点。
- Block 是统一中间表示:类型 + 层级 + 文本 + 页码 + 元数据,让下游彻底脱离对原始格式的感知。
- 表格和幻灯片是原子块,解析阶段绝不切碎,后面会独占一个父块。
- 7 种格式 7 套工具,扩展新格式只需写一个类 + 声明扩展名,路由层零改动。
- AUTO 模式云端失败会自动回退本地,最坏情况只是效果差一点,不会整批失败。
- 扫描件检测必须做:两条阈值规则(整篇 < 50 字 / 页均 < 10 字),省下的是钱和用户的时间。
下一篇预告
现在我们手上有了一排整齐的积木:标题、段落、表格、幻灯片,还带着层级和页码。
接下来是整个系列最见功力的一步:怎么把这些积木切成块?
切大了检索不准,切小了模型看不懂上下文,这个两难怎么破?
下一篇揭晓答案:一次切两层,小块负责检索,大块负责生成。我们还会讲清楚"为什么重叠一点点反而更好"。
下一篇预告:一条父块被切成带重叠区的小段。
课程章节
03|解析:把五花八门的文档变成统一积木
正在检查解锁状态…