08|生成:流式输出与引用回指
内容组装好了,最后一步:让模型开口说话。
让用户盯着空白等 20 秒,和看着文字一个字一个字蹦出来,这是两种完全不同的产品。
本篇你能学到
- SSE 是什么,为什么问答一定要用它
- 四种事件的协议设计(引用 / 正文 / 结束 / 报错)
- 生成卡住时怎么自救:超时看门狗
- 提示词怎么拼,才能让模型"敢说不知道"
- 前端怎么把
[1]角标变成能点开的引用卡
一、为什么必须流式?
假设一次问答要 20 秒。
非流式:用户盯着空白 20 秒,然后一大段文字突然出现。
流式:0.8 秒后开始出字,之后持续滚动,20 秒读完。
等待时间完全一样,但体验天差地别。 前者用户会以为卡死了,刷新页面;后者用户会一直盯着读。
SSE 是什么
SSE(Server-Sent Events):服务端主动往浏览器"推"数据的一种 HTTP 用法。
跟 WebSocket 的区别:SSE 是单向的(服务端 → 浏览器),问答场景本来就只需要单向,用 SSE 更简单、更省资源,还能自动重连。
后端返回类型:
接口 POST /api/chat,响应类型声明为 事件流(text/event-stream)

    问题 ← 请求体.question
    kbIds ← 请求体.kbIds 转成 UUID 列表(没传就是空列表,表示全库)

    返回 问答服务.开始问答(问题, kbIds)
记住:问答是 POST(问题内容在请求体里),不是 GET。 这是很多人第一次接 SSE 时踩的坑。
二、四种事件:约定一套"对话协议"
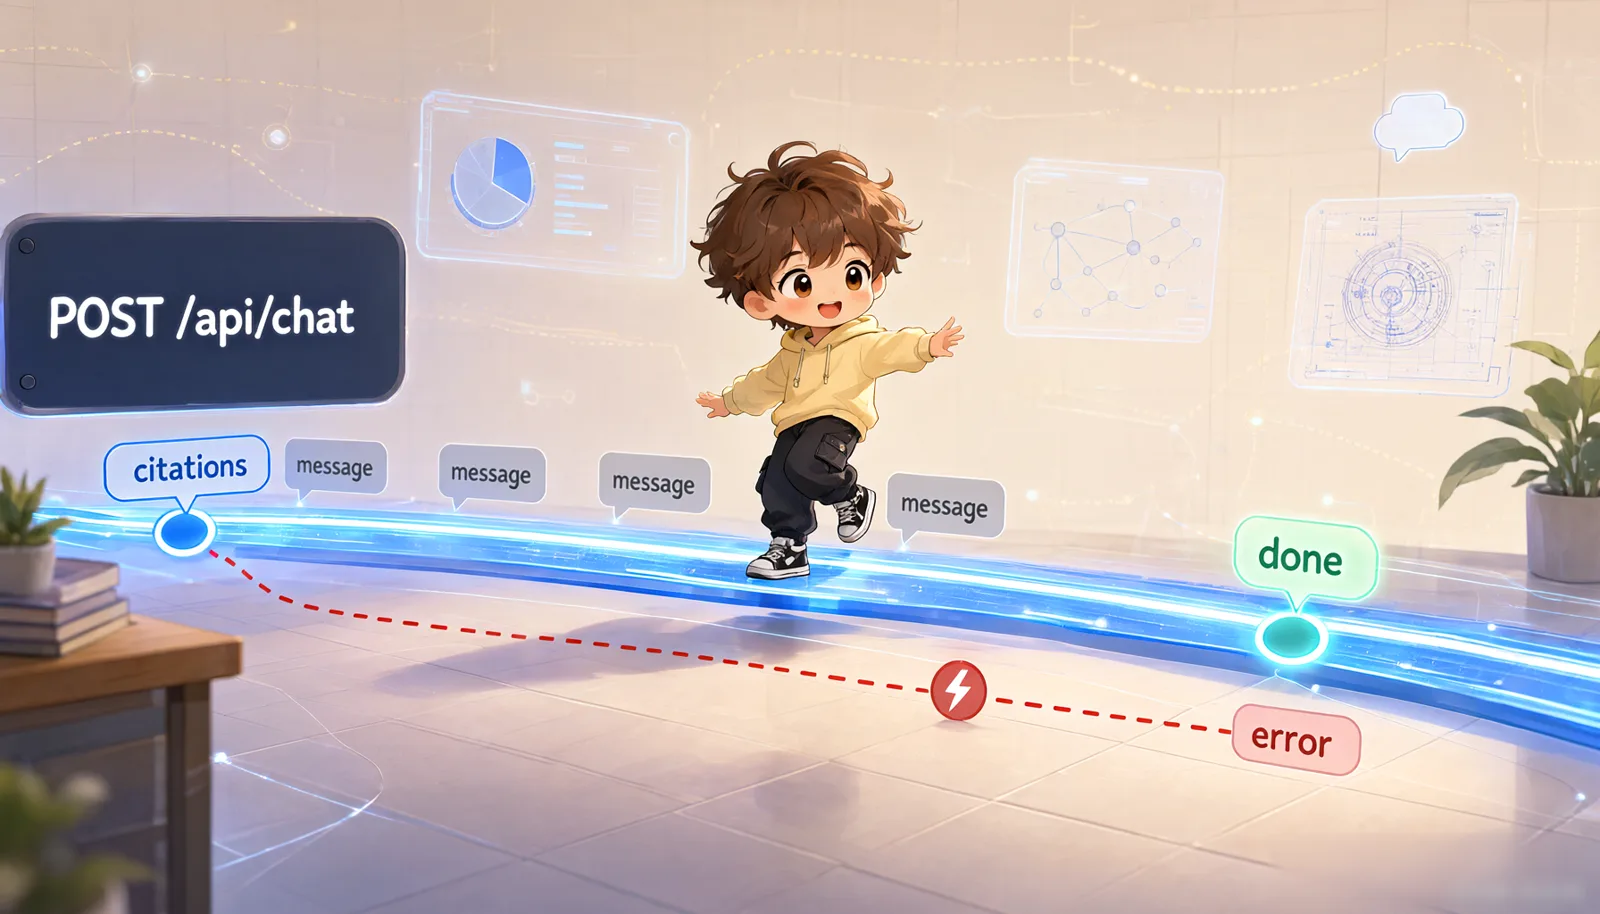
我们定义了四个事件,前后端按这个契约通信:
| 事件 | 时机 | 数据 |
|---|---|---|
citations | 检索完成后立刻发一次 | 引用列表(JSON) |
message | 生成过程中持续发 | 一小段增量文本 |
done | 生成结束 | {} |
error | 出错或超时 | 错误提示文本 |
为什么引用要先发? 因为用户在看答案滚动的同时,右侧引用栏就应该已经就位了。引用先到,答案后到,用户可以边读边对照。
实际看到的流
event: citations
data: [{"index":1,"title":"回调配置","documentId":"7f3a…","parentId":"9c2b…",
        "meta":{"file_name":"产品手册.pdf","page_start":"12","page_end":"12"},
        "children":[{"childId":"a1…","seq":3,"score":0.91}]}]

event: message
data: 商户可以在

event: message
data: 「开放平台 → 开发配置」页面

event: message
data: 中修改回调通知地址[1]。

event: done
data: {}
注意 message 是增量:每帧只有几个字,前端把它们拼起来才是完整答案。
空结果时的特殊处理
如果 组装好的上下文片段 为空:
    发一条 message 事件: "知识库中未找到相关信息。"
    直接收尾(根本不调用模型)
    返回
没检索到任何内容时,根本不调用模型,直接返回一句标准答复。
这既省钱、又快,而且避免了模型在没有资料时"自由发挥"。
三、提示词:让模型"敢说不知道"
这是决定答案可靠性的关键一步。我们的提示词非常朴素:
你是知识库问答助手。请严格依据下方 <context> 标签内的资料回答问题:
1. 资料未涵盖的内容,明确回答"知识库中未找到相关信息",禁止编造;
2. 回答中引用资料时,在对应句子末尾标注角标 [n](n 为资料编号)。

<context>
三句话,三个作用:
- "严格依据资料" , 划定边界,不许用外部知识。
- "明确回答未找到,禁止编造" , 明确允许模型说"不知道"。很多幻觉问题,本质是提示词没给模型"说不知道"的许可。
- "标注角标 [n]" , 让答案可追溯。
上下文部分这样拼:
遍历 每个上下文片段:
    追加 "[片段编号] "                          # 例如 [1]
    如果 该片段有章节标题:
        追加 "(《章节标题》)"                 # 例如(《回调配置》)
    追加 换行 + 片段正文 + 两个换行

最后追加 结尾模板 + 问题                        # 例如"问题:xxx"
每个片段带上 [n] 编号和章节标题,模型才知道该引用哪个号。
我们不做占位符替换,就是纯拼接。 简单、可预测、好调试,提示词越朴素越容易控制。
四、超时看门狗:生成卡住了怎么办
模型有时会卡住:网络抖动、上游限流、生成进入死循环。
不能让用户无限等下去。
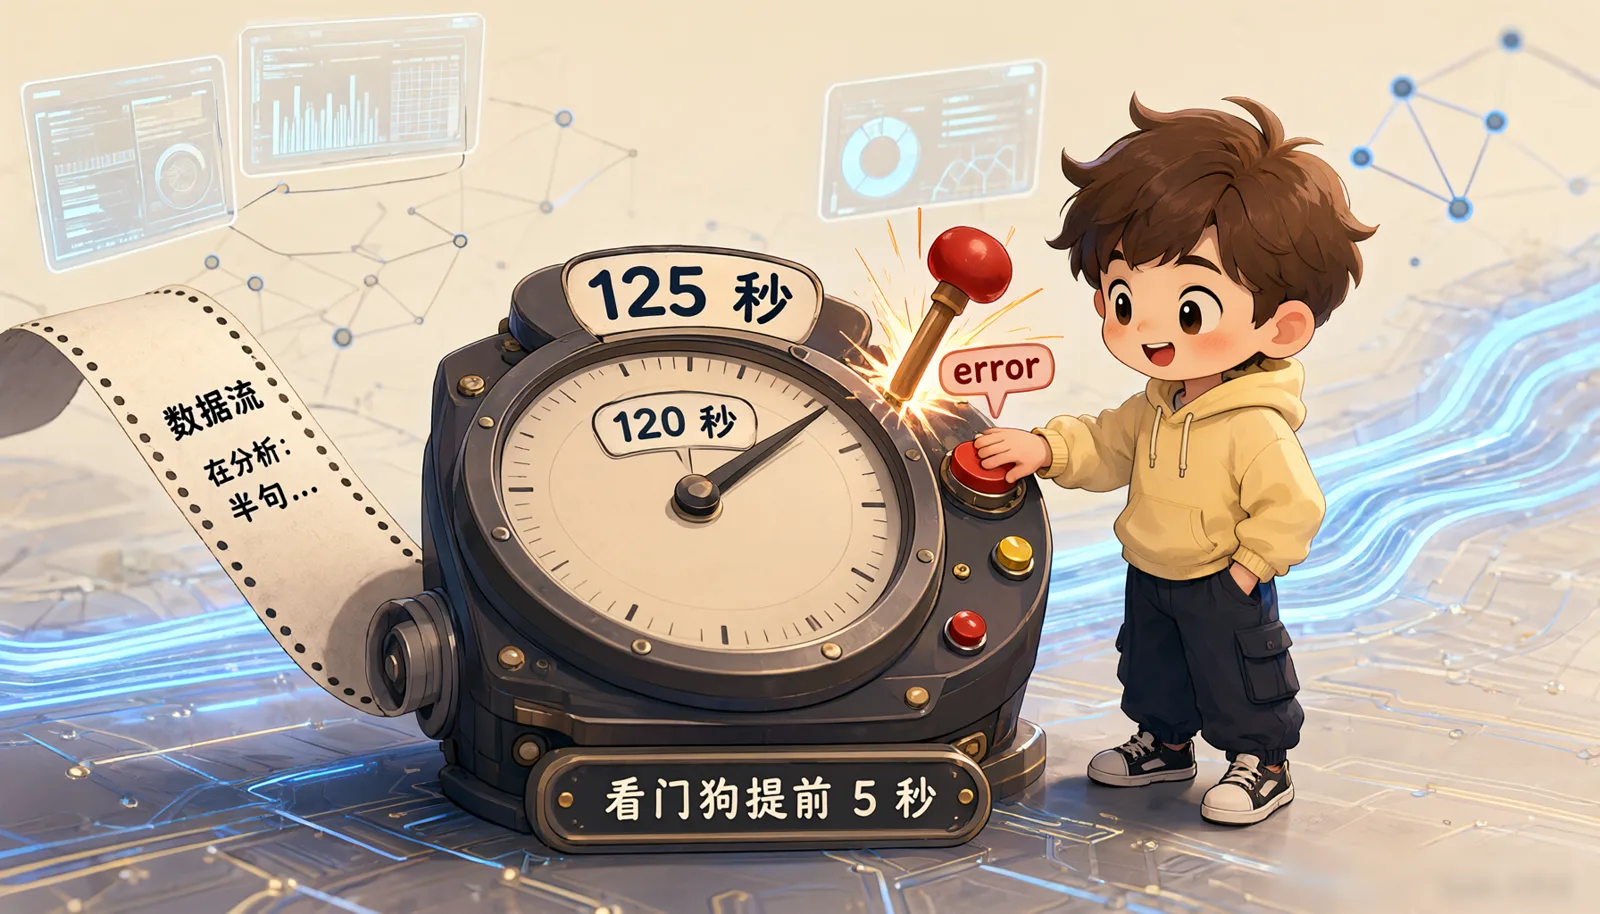
看门狗宽限时间 ← 5 秒

创建流时:
    流的超时时间 ← 业务超时(120 秒) + 宽限(5 秒)
    注册一个延迟任务: 到 120 秒时执行 超时处理()
设计细节:看门狗比 SseEmitter 自身的超时早 5 秒触发。
为什么? 因为 SseEmitter 超时回调触发时,响应已经被容器标记完成,回调里再也写不进事件了。所以必须提前动手:
函数 超时处理():
    收尾失败("回答生成超时(120 秒),请重试或缩短问题。")

函数 收尾失败(提示文本):
    如果 已终止: 直接返回            # 幂等,只执行一次
    标记 已终止
    取消对模型流的订阅                # ← 关键:不让后台继续生成继续烧钱
    写一条 error 事件: 提示文本
    结束流
"取消订阅"这一步很关键:超时后必须取消对模型流的订阅,否则后台还在继续生成、继续烧钱。
terminated 是原子布尔量,保证 done / error 只发一个,不会重复收尾。
默认超时 120 秒,可调:
export KB_CHAT_SSE_TIMEOUT_MS=180000五、前端怎么收流
后端推的是 SSE,前端用 fetch + ReadableStream 收(注意是 POST,不能用 EventSource,EventSource 只支持 GET):
发起请求(POST /api/chat,请求体 = { question, kbIds },带上可中断信号)
拿到一个可以一点点读的响应流

缓冲 ← 空字符串
循环:
    读一小段数据,追加到 缓冲
    如果 流已读完: 跳出循环

    当 缓冲 里出现空行("\n\n") 时:        # SSE 每个事件以空行结束
        取出空行之前的一整帧
        解析出 event 名 和 data 内容 → 分发处理
        把这一帧从缓冲里删掉
两个关键处理:
- 按
\n\n切帧:网络可能把一个事件拆成两批送到,也可能一批送来两个事件。必须缓冲 + 按分隔符切,不能直接按"一批 = 一帧"处理。 AbortController:用户点"停止生成"时abort(),同时取消后端订阅。
引用角标怎么变成可点的按钮
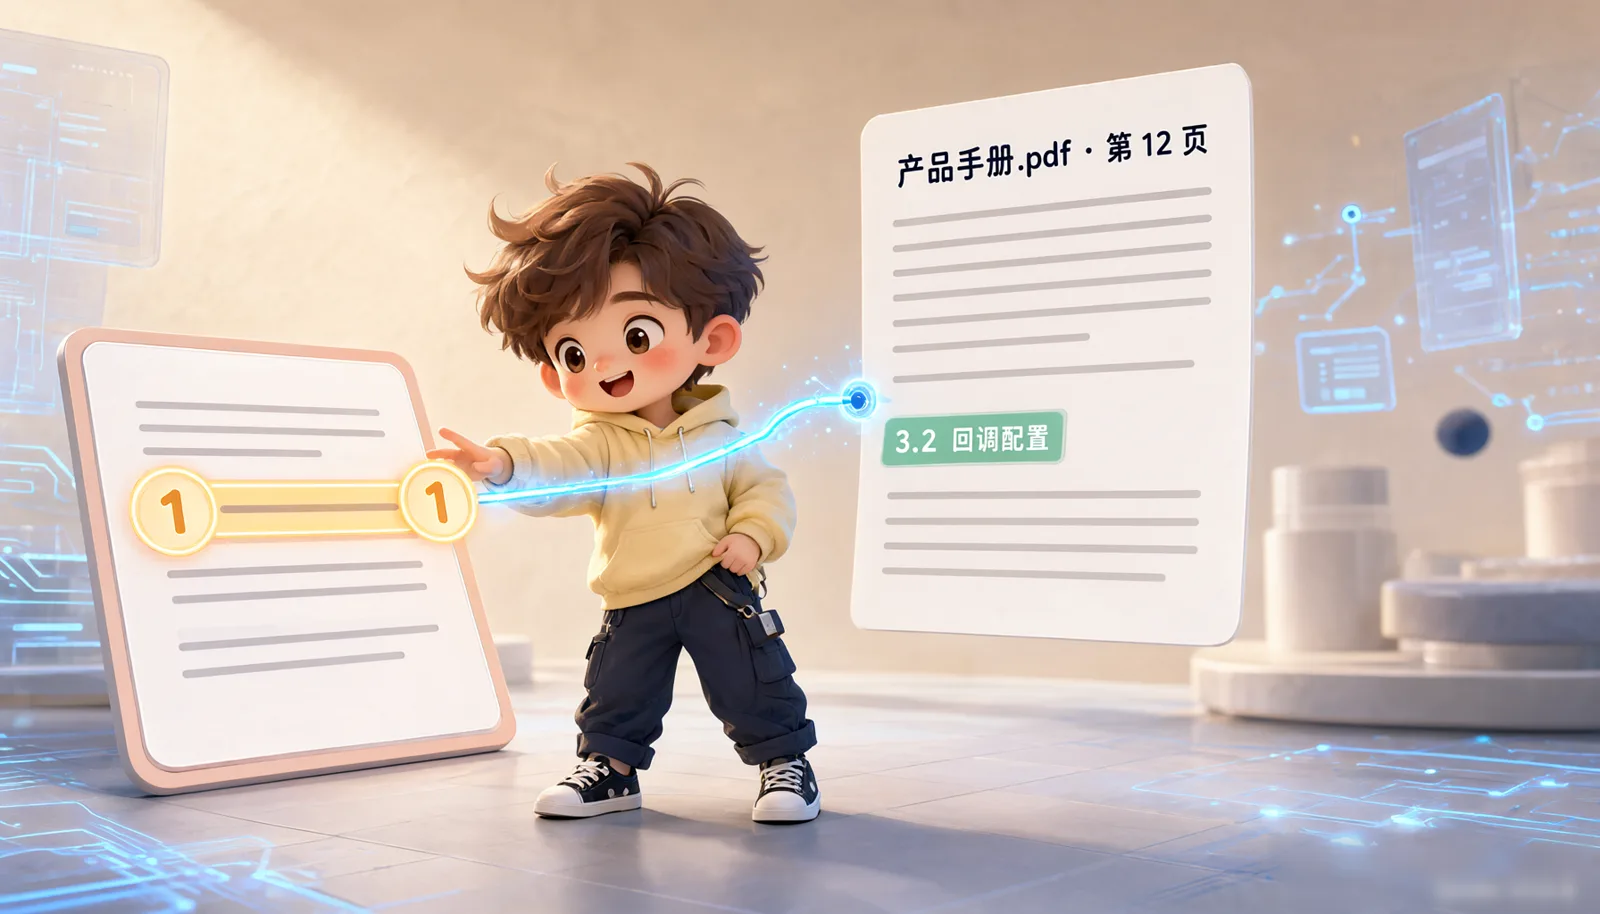
模型输出的是 [1] 这种纯文本。前端用 markdown-it 自定义规则把它渲染成按钮:
给 Markdown 渲染器加一条自定义规则:
    遇到 "[数字]" 这种格式时:
        不要当成普通文本
        渲染成一个可点击的小按钮,并把数字记在按钮上
点击后联动右侧引用卡,点开能看到父块原文。
两个安全细节
- 原文渲染必须消毒:引用原文按 Markdown 渲染,内容来自用户上传的文档,必须用 DOMPurify 消毒,否则一份恶意 HTML 文档就能 XSS。
- 不要拼接历史:我们的做法是每次提问独立检索,历史会话只存在浏览器 IndexedDB(最多 20 条),不发给服务端。这样既省 Token,又避免历史污染检索。
六、一次完整问答的日志
以下为示意输出:字段与真实日志一致,数值为示例。
chat stage=start            questionLength=8 kbCount=2
chat stage=retrieval.done   segments=6 elapsedMs=561
chat stage=generation.start segments=6 elapsedMs=563
chat stage=first_token      elapsedMs=1180 segments=6      ← 首字延迟 1.18 秒
chat stage=done             elapsedMs=8420 segments=6
三个时间指标要盯:
| 指标 | 本例 | 说明 |
|---|---|---|
| 检索耗时 | 561ms | 三路召回 + 融合 + 重排 + 组装 |
| 首字延迟(TTFT) | 1180ms | 用户感知的"响应速度",最重要 |
| 总耗时 | 8420ms | 完整答案生成完毕 |
优化优先级:先降首字延迟,再降总耗时。 用户对"多久开始出字"最敏感。
⚠️ 常见错误与排错
Q1:前端收到的是一大段而不是流式?
99% 是 Nginx 缓冲没关。 SSE 必须关闭代理缓冲:
location /api/ {
    proxy_pass http://127.0.0.1:8080;   # 后端地址,按你的部署改
    proxy_http_version 1.1;             # SSE 长连接需要 HTTP/1.1
    proxy_buffering off;                # ← 关键!不关就是一次性返回
    proxy_cache off;
    proxy_read_timeout 300s;            # SSE 长连接要放宽读超时
    proxy_send_timeout 300s;
    proxy_set_header Connection "";
}
项目自带的 frontend/nginx.conf 里写的是 proxy_pass http://app:8080,那个 app 是容器编排里的服务名。仓库自带的 docker-compose.yml 只编排了数据库,所以本地单独跑前端容器时,要么把这一行改成实际的后端地址,要么自己在编排里补一个 app 服务。
proxy_buffering off 是 SSE 在 Nginx 后面能工作的必要条件。
Q2:模型还是在编造,怎么办?
按顺序检查:
- 提示词里有没有"禁止编造"这句话?没写模型就会自由发挥。
- 检索到的内容真的包含答案吗?看日志
segments=是不是 0。 - 温度参数是不是太高?我们设的是
temperature: 0.2(低温度 = 更保守、更少发挥)。
spring:
  ai:
    openai:
      chat:
        options:
          model: mimo-v2.6-flash
temperature: 0.2 # 知识库问答建议 0.1~0.3Q3:KB_CHAT_BASE_URL 配了却报 404?
base-url 不能带 /v1! Spring AI 会自己拼 /v1/chat/completions。
export KB_CHAT_BASE_URL=https://api.xiaomimimo.com      # ✅
export KB_CHAT_BASE_URL=https://api.xiaomimimo.com/v1   # ❌ 会变成 /v1/v1/
Q4:生成到一半断了,没有 done 也没有 error?
可能是用户点了"停止",或者网络断开。前端要处理这种"流被中断"的情况:
如果 流结束了却没收到终态事件:
    按"已完成"处理(可能是用户点了停止,或网络断开)
Q5:答案里没有引用角标?
两个可能:
- 提示词没生效,检查
PromptRenderer的 HEAD 常量是否被改动。 - 模型没遵守,可以调低 temperature,或在提示词里加一个示例(few-shot)。
Q6:引用卡点了没反应?
检查 citations 事件的 index 和正文里的 [n] 是否对得上。两者都来自 ContextSegment.index(),编号从 1 开始连续递增,不会跳号,装不进预算的父块不占编号。
本篇小结
- 问答用 SSE 且是 POST,四个事件:
citations(先发)→message(增量)→done;异常时error。 - 检索为空时直接返回"未找到",不调模型,省钱、快、避免瞎编。
- 提示词必须明确写"禁止编造",给模型说"不知道"的许可,这是抑制幻觉的第一道防线。
- 超时看门狗比流自身的超时早 5 秒触发,超时后要取消上游订阅,别让后台继续烧钱。
- Nginx 反向代理必须
proxy_buffering off,否则 SSE 退化成一次性返回。 base-url不能带/v1,Spring AI 会自己拼。
下一篇预告
到这里,整条链路已经跑通了:上传 → 解析 → 分块 → 索引 → 检索 → 组装 → 生成。
但真实使用中一定会遇到这些问题:
- 切片切错了,能不能改?改了要不要重新算向量?
- 两个人同时编辑同一块怎么办?
- 怎么给接口加鉴权?
- 上线还有哪些坑?
最后一篇收官,我们把这些"上线后才会在意"的事一次讲完,并附一份 20 条踩坑清单。
下一篇预告:盖着印章的出厂合格证。
课程章节
08|生成:流式输出与引用回指
正在检查解锁状态…