09|收官:切片可编辑、知识库、鉴权,以及 20 条踩坑清单
前 8 篇我们把链路跑通了。 但"能跑"和"敢上线"之间,还差这一篇。
最后附一份 20 条踩坑清单。
本篇你能学到
- 切片切错了怎么改,改了要不要重新算向量
- 两个人同时编辑同一块怎么办(乐观锁)
- 知识库怎么组织,接口怎么加鉴权
- 20 条踩坑清单
一、切片可编辑:给系统留一个"人工后门"
再好的自动分块也会出错,尤其是 PDF 那种靠猜标题的格式。
所以必须让人能改。但"改"的语义要想清楚,否则会改出乱子。
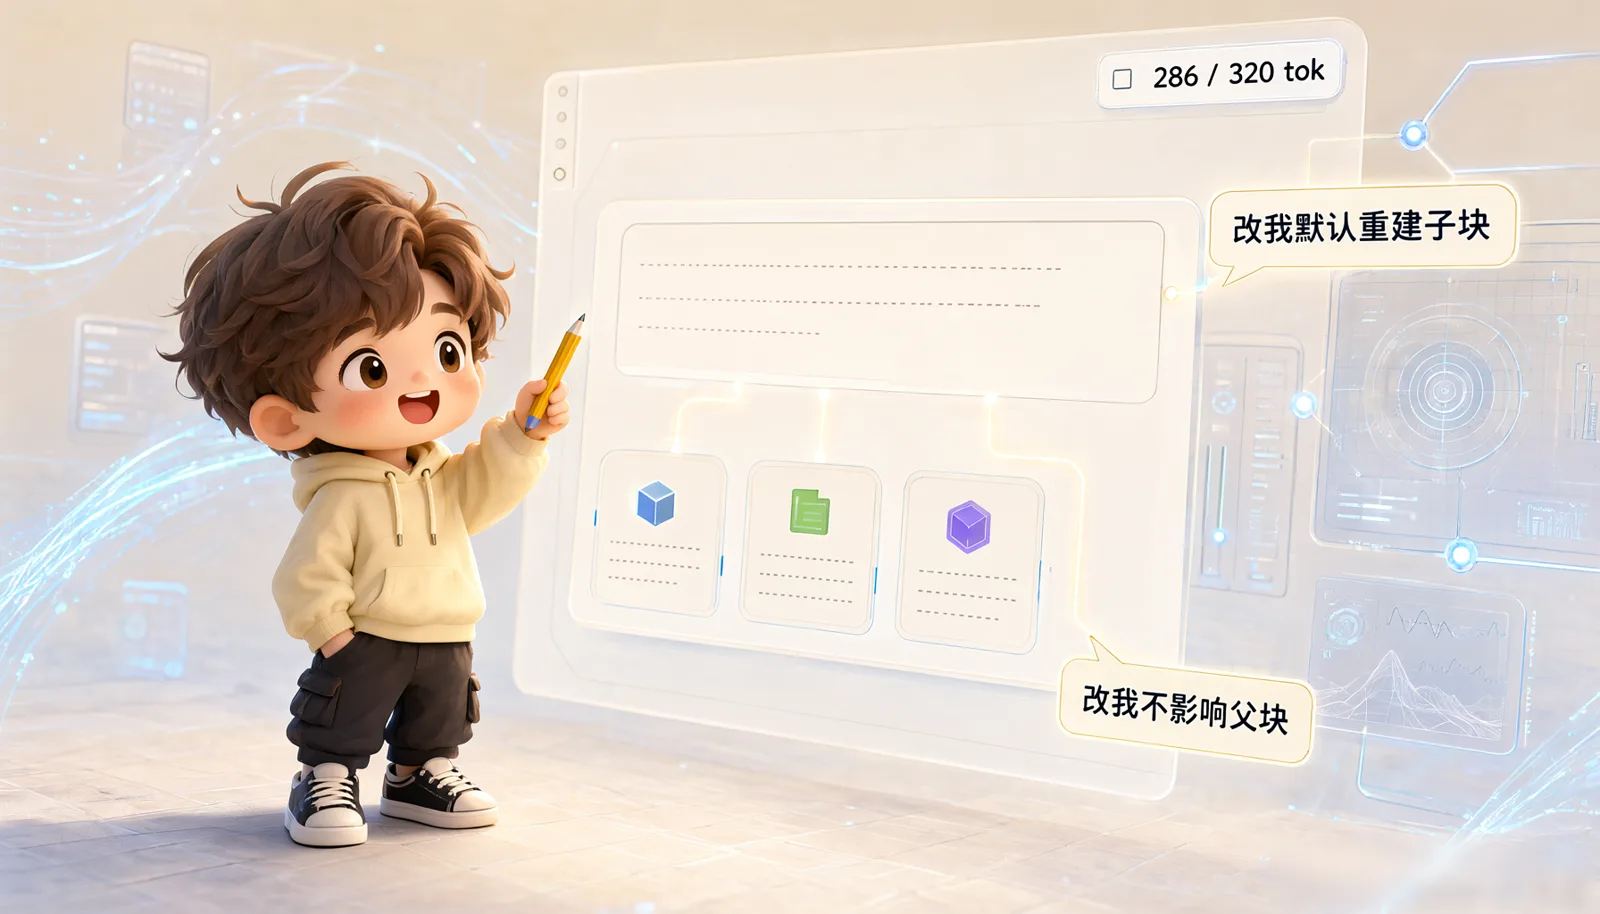
四条编辑语义
下面的语义约定对齐 Dify 的父子分段:
| 语义 | 说明 |
|---|---|
| 改子块不影响父块 | 子块只服务于检索,改它是调检索效果,不动给模型看的内容 |
| 改父块默认重建子块 | 父块内容变了,子块必须跟着变,否则检索和生成对不上 |
| 删最后一个子块保留空父块 | 避免父块被"误删",给你反悔的机会 |
| 改完自动重嵌(仅已完成文档) | 省掉手工点索引的麻烦 |
"改父块默认重建子块" 可以通过参数关掉:
{ "title": "回调配置", "content": "……", "rebuildChildren": false }传 false 就只改父块文本、保留原有子块。适合你只想微调措辞、不想动切分的场景。
什么时候自动重新算向量?
函数 是否需要自动重嵌(文档):
返回 文档.状态 是否等于 COMPLETED| 文档状态 | 编辑后行为 |
|---|---|
CHUNKED(待向量化) | 只保存文本,反正还没索引 |
INDEX_FAILED | 只保存文本,等你统一重试 |
COMPLETED | 自动重嵌受影响的子块 |
这个设计很自然:还没花钱的时候随便改;已经花钱了就自动把改动同步过去,不让你手动再点一次。
三种 Token 上限,别混
kb:
  chunk:
    parent: { max-tokens: 1200 }
    child:
      max-tokens: 320          # 普通编辑 / 拆分的上限
      merge-max-tokens: 640    # 人工合并允许更大
为什么合并的上限更大? 因为合并是人的主动决策,你看到两个块明明该在一起,那合并出 600 Token 的块是合理的。而系统自动切分时,320 是保守值。
二、并发编辑:用乐观锁,别用悲观锁
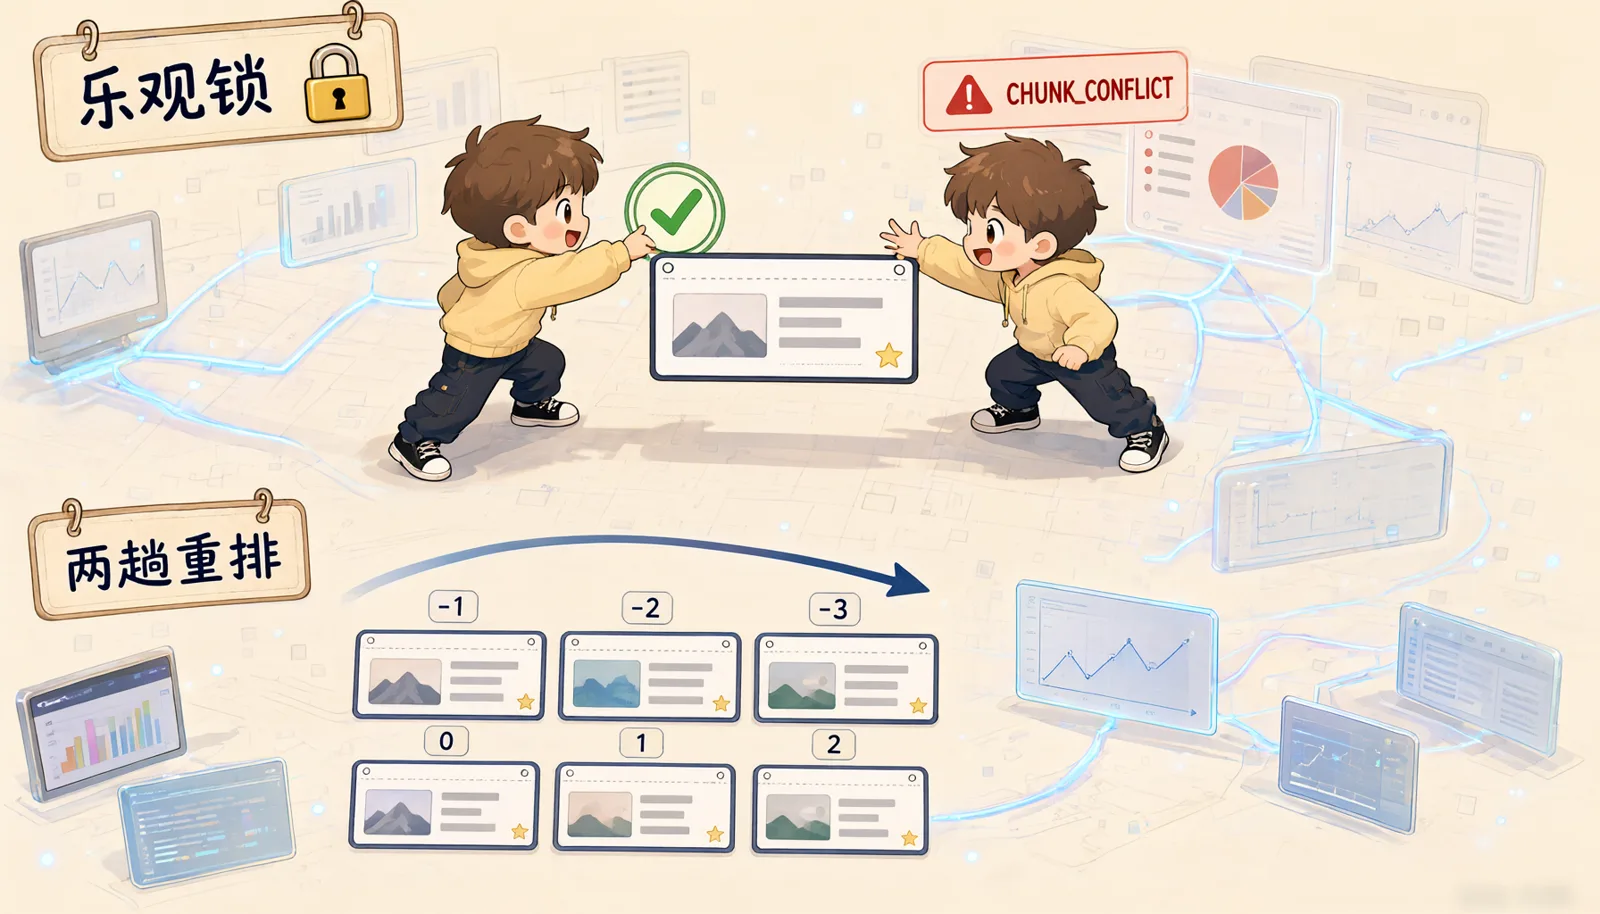
两个人同时改同一个子块的情况,用乐观锁处理:更新时带上"我看到的旧值"作为条件。
更新内容,但前提是这一行的内容还和我读出来时一模一样,不是就说明被别人改过了,一行都不更新。
UPDATE child_chunks
SET content = #{content}, token_count = #{tokenCount}, ...
WHERE id = #{id}
AND content = #{oldContent} -- ← 关键:内容必须还是我读到的那个更新行数 ← 更新内容(新内容, 条件: 内容必须还是我读到的旧值)
如果 更新行数 = 0:
抛错(CHUNK_CONFLICT, "内容已被其他操作修改,请刷新后重试")更新行数为 0 说明有人抢先改了,直接报错让用户刷新。
不用悲观锁(SELECT ... FOR UPDATE)的原因是:切片编辑是低频操作,冲突概率很小,而悲观锁会长时间占着数据库连接;摄入和检索共用同一个连接池(HikariCP,最大 10 个连接),一把锁能把在线问答一起拖慢。低频冲突场景下乐观锁性价比高得多。
重排序的一个小技巧
删除一个子块后,剩下的 seq 要重新编号。但 (parent_id, seq) 有唯一约束,直接 update 会撞键。
解法:先全部改成负数,再改回正数。
第一趟 遍历 排好序的子块:
    把它的 seq 改成 −(序号 + 1)        # 先挪到负数区间,避开唯一约束

第二趟 遍历 排好序的子块:
    把它的 seq 改成 序号              # 再挪回正数
两趟更新,干净地绕过唯一约束冲突。 这个小技巧在很多"重排序"场景都能用。
合并的两个限制
① 按顺序检查待合并的子块:
    如果 后一个.seq ≠ 前一个.seq + 1:
        抛错("只能合并同一父块内连续的子块")

② 拼接时自动去掉滑窗重叠:
    重叠长度 ← 计算(前一段的尾部 与 后一段的头部 的最长公共部分)
    如果 重叠长度 > 0:
        后一段跳过这段重叠再拼接      # 否则文本会重复一段
    否则:
        正常用两个换行拼接
第 ② 点是个容易忽略的细节:第 4 篇讲过子块之间有 48 Token 重叠,合并两段时如果不去重,文本会重复一段。
三、知识库:一个多对多的分类
知识库不是"文件夹",一份文档可以同时属于多个知识库。
CREATE TABLE document_knowledge_bases (
    document_id       UUID REFERENCES documents(id) ON DELETE CASCADE,
    knowledge_base_id UUID REFERENCES knowledge_bases(id) ON DELETE CASCADE,
    PRIMARY KEY (document_id, knowledge_base_id)
);
两个级联方向要注意:
- 删文档 → 关联记录自动清理,知识库还在。
- 删知识库 → 关联记录自动清理,文档还在(只是不再属于这个库)。
这一点很多人会搞错:删知识库不会删文档。
检索时知识库过滤下推到 SQL(第 6 篇讲过),不是捞全库再筛。
四、鉴权:一个 Key 就够,但要知道边界
kb:
  security:
api-key: ${KB_API_KEY:} # 非空即启用函数 是否跳过鉴权(请求):
如果 没配置密钥: 跳过(本地开发不启用)
如果 请求方法是 OPTIONS: 跳过(放行跨域预检)
如果 路径以 /actuator 开头: 跳过(放行健康检查)
否则: 不跳过,必须校验 X-API-Key三个放行条件要记牢:
- 没配就不启用,本地开发不用烦心。
OPTIONS预检放行,否则跨域请求第一次握手就被拦了。/actuator放行,否则健康检查一直 401,容器编排会以为服务挂了。
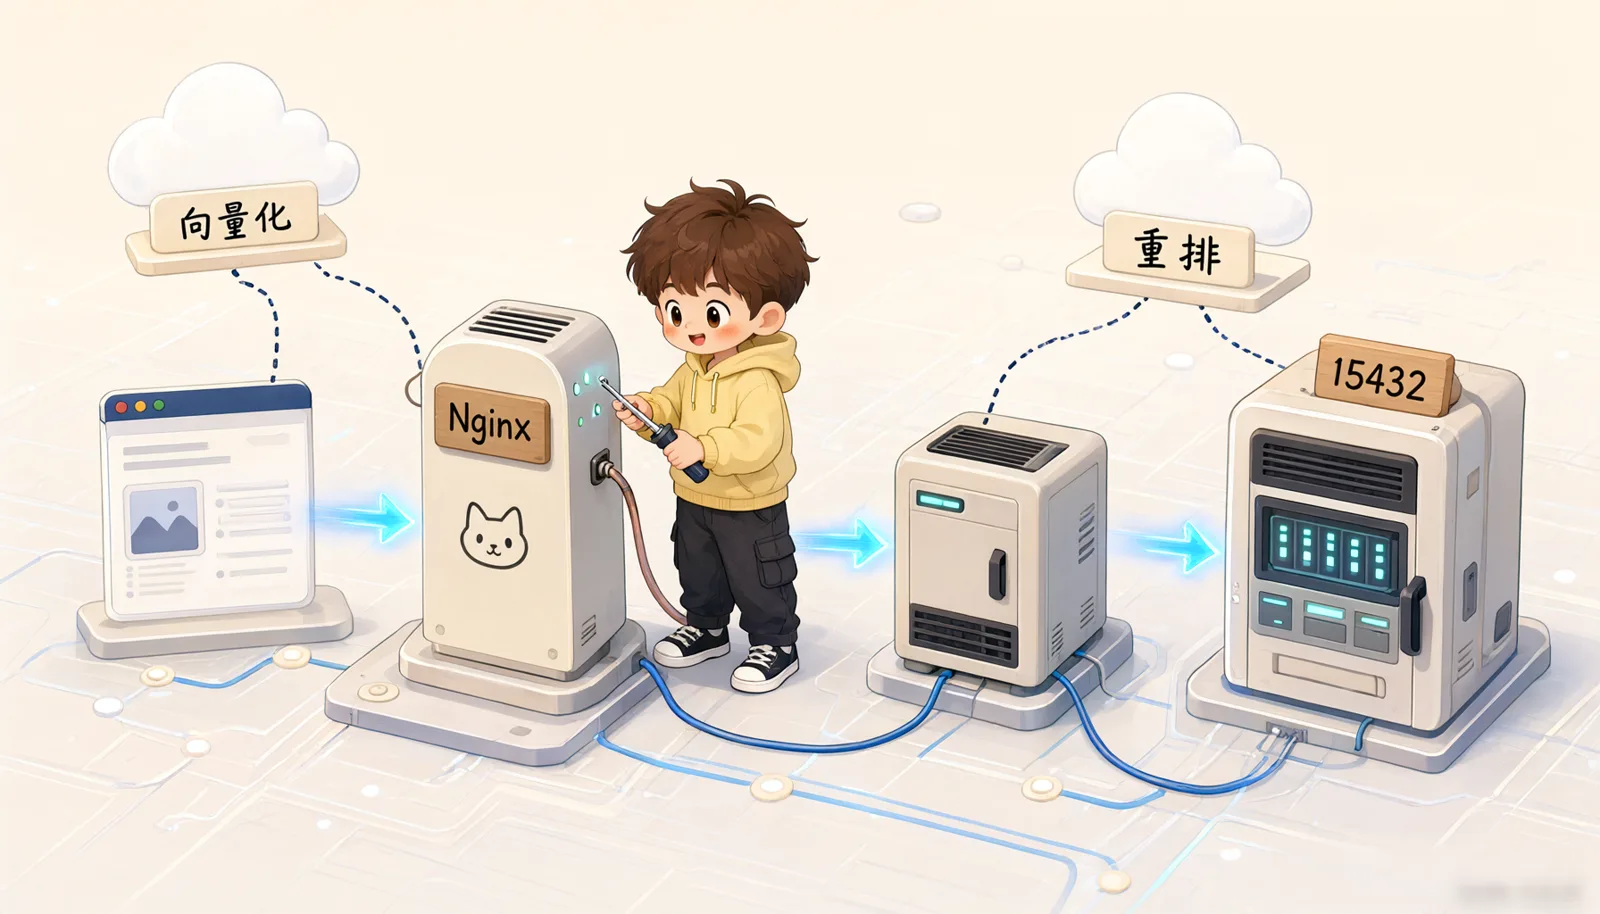
前端的处理:固定同源访问(通过 Nginx 反代),不提供 API 地址/Key 的配置入口。收到 401 时只提示"检查后端鉴权配置",不暴露细节。
启动期就校验凭证(Fail-Fast)
启动即检查(缺哪个直接启动失败):
    必须有 KB_CHAT_API_KEY
    必须有 KB_DB_PASSWORD
    必须有 DASHSCOPE_EMBEDDING_API_KEY
    必须有 DASHSCOPE_RERANK_API_KEY
    如果 开了云端解析: 还必须有 LLAMA_CLOUD_API_KEY
缺哪个启动就失败,绝不让你带着空 Key 跑到一半才报错。 这比"运行时报错"友好一百倍,问题暴露在最早、最便宜的时刻。
线程池:摄入和检索必须分开
kb:
  thread-pool:
    ingest: { core: 2, max: 4, queue: 50 }    # 慢任务,少量并发
    search: { core: 8, max: 16, queue: 100 }  # 快任务,高并发
分开的原因是:摄入是慢任务(几秒到几分钟),检索是快任务(几百毫秒)。如果共用一个池,几份大文档在解析就会把线程占满,导致所有问答请求排队,用户会觉得"系统卡死了"。
队列满时的策略是 CallerRunsPolicy(回落到调用线程执行),这时请求会同步阻塞,起到天然的限流作用。
五、20 条踩坑清单
数据库
| # | 坑 | 解法 |
|---|---|---|
| 1 | locale 不是 C.UTF-8,pg_trgm 静默忽略中文,不报错就是查不出来 | POSTGRES_INITDB_ARGS: "--encoding=UTF8 --locale=C.UTF-8" |
| 2 | 改了建表 SQL 重启没生效 | init 脚本只在数据卷为空时执行,需 docker compose down -v(会丢数据)或手动 psql < xxx.sql |
| 3 | 向量索引不生效,查询越来越慢 | 确认建的是 USING hnsw (embedding vector_cosine_ops),后缀不能丢 |
| 4 | 全文检索报 zh_cfg 不存在 | 手动补建 CREATE TEXT SEARCH CONFIGURATION zh_cfg (PARSER = zhparser) |
| 5 | 连不上数据库 | 宿主端口是 15432 不是 5432 |
检索
| # | 坑 | 解法 |
|---|---|---|
| 6 | 文档导入了却搜不到 | 必须同时满足:文档 COMPLETED + 子块 embedding 非空 |
| 7 | 模糊检索永远 0 条 | 检索时动态 SET LOCAL pg_trgm.similarity_threshold = 0.2(默认 0.3 对中文太严) |
| 8 | 模糊检索慢 10 倍 | WHERE 必须写 content % 查询词;写 similarity(...) >= x 会让索引失效 |
| 9 | 用户提问带问号就报错 | 用 websearch_to_tsquery,不要用 to_tsquery |
| 10 | 重排一直 404 | 端点前缀是 compatible-api/v1,不是 compatible-mode |
模型与配置
| # | 坑 | 解法 |
|---|---|---|
| 11 | base-url 报 404 | 不能带 /v1,Spring AI 会自己拼,否则变 /v1/v1/ |
| 12 | 改了向量维度报错 | dimensions: 1024 必须与表字段 vector(1024) 一致,改了要重建索引 |
| 13 | batch-size 调大报错 | 百炼 text-embedding-v4 单批硬上限是 10,不可调 |
| 14 | 启动即失败提示"未配置" | 这是 Fail-Fast 设计,补齐对应环境变量即可 |
| 15 | 模型还在编造 | 提示词必须写"禁止编造";temperature 调低到 0.1~0.3 |
文档处理
| # | 坑 | 解法 |
|---|---|---|
| 16 | 扫描件白花冤枉钱 | 系统会自动标记 NEEDS_OCR,看到就换文字版或开云端解析 |
| 17 | PDF 标题层级全乱 | PDF 先天缺陷,只能靠字号猜;优先用 Word/Markdown 原件 |
| 18 | 改了分块参数,老文档没变 | 参数只在摄入时生效,需重传或用切片编辑 |
上线
| # | 坑 | 解法 |
|---|---|---|
| 19 | SSE 变成一次性返回 | Nginx 必须 proxy_buffering off |
| 20 | 上传大文件报 413 | 后端上限 50MB,Nginx 要同步设 client_max_body_size 60m |
六、上线前最后检查一遍
# ① 数据库三件套都在吗
docker exec -it eon-rag-db psql -U postgres -d eon_rag -c "\dx"
# 预期看到 pgcrypto / vector / pg_trgm / zhparser

# ② locale 对吗(中文检索的前提)
docker exec -it eon-rag-db psql -U postgres -d eon_rag -c \
  "SELECT datctype FROM pg_database WHERE datname = 'eon_rag'"
# 预期:C.UTF-8

# ③ 服务活着吗
curl http://127.0.0.1:8080/actuator/health
# 预期:{"status":"UP"}

# ④ 网关没拦健康检查吧(配了 KB_API_KEY 时)
curl http://127.0.0.1:8080/actuator/health    # 不带 Key,应该仍然 200
curl http://127.0.0.1:8080/api/kbs            # 不带 Key,应该 401
四条全绿,就可以上线了。
⚠️ 常见错误与排错
Q1:编辑切片时提示 DOC_NOT_EDITABLE?
只有 CHUNKED / INDEX_FAILED / COMPLETED 三种状态可编辑。PROCESSING 和 INDEXING 期间系统正在写数据,编辑会冲突。
Q2:提示 CHUNK_CONFLICT?
乐观锁生效了,别人(或你的另一个标签页)先改了这块。刷新页面拿到最新内容再改。
Q3:删除知识库后文档也没了?
不会。 删知识库只清关联记录,文档本体还在。如果文档真的没了,那是因为删的是文档不是知识库,检查你点的是哪个按钮。
Q4:并发上传很多文档后问答变慢?
摄入线程池把线程占满了。 调大 kb.thread-pool.ingest.max,或者更好,限制同时上传的文档数量。摄入是后台任务,慢一点没关系,别抢了在线请求的线程。
Q5:这套系统能撑多少数据?
单机 PostgreSQL 在几十万子块量级表现良好。到了百万级以上建议:
- 调大 HNSW 的
ef_search - 考虑分区表
- 真到千万级就该换专用向量数据库了
先跑起来,再谈扩容。
本篇小结
- 切片可编辑是系统的"人工后门":改子块不影响父块,改父块默认重建子块,已完成文档编辑后自动重嵌。
- 并发用乐观锁(
WHERE content = 旧值),低频冲突场景下比悲观锁划算得多;重排序用"先负数再正数"两趟更新绕过唯一约束。 - 知识库是多对多,删知识库不会删文档。
- 鉴权三个放行:未配置不启用、
OPTIONS放行、/actuator放行。 - 启动期 Fail-Fast 校验凭证,让问题暴露在最早最便宜的时刻。
- 摄入和检索必须分线程池,否则批量导入会拖垮在线问答。
系列收官
九篇下来,我们从一个"80 页手册怎么问答"的问题出发,一路搭出了:
02 地基   一个 PostgreSQL 扛下向量 + 中文全文 + 模糊三路检索
03 解析   7 种格式 → 统一 Block 积木
04 分块   父子两层:小块检索,大块生成
05 索引   手动点索引,省钱包 + 可重试
06 检索   三路并行 → RRF 融合 → 云端重排,全程可降级
07 组装   父块上卷 + Token 预算裁剪
08 生成   SSE 流式输出 + [n] 引用回指
09 收官 切片可编辑 + 知识库 + 鉴权 + 20 条踩坑清单完整代码仓库:https://github.com/ricezong/eon-rag 。把项目跑起来就三步,细节在第 2 篇第六节:
cd docker && export KB_DB_PASSWORD='...' && docker compose up -d --build   # 数据库
mvn spring-boot:run                                                        # 后端,先 export 4 个 Key
cd frontend && pnpm install && pnpm dev                                    # 前端
如果只让你记住三句话,我希望是这三句:
- 切块的核心矛盾是"检索要小、生成要大",解法是切两层。
- 任何外部依赖都可能挂,所以每一环都要有降级路径。
- 系统的可靠性不来自某个巧妙算法,而来自"每一步失败后都知道该怎么办"。
下一步可以往哪走
| 方向 | 可以做什么 |
|---|---|
| 效果 | 接入 Rerank 之外的精排模型;按业务调 rrf-k、top-k;开 HyDE |
| 能力 | 加 OCR 支持扫描件;支持图片/多模态;做服务端多轮会话 |
| 工程 | 文档列表服务端分页;批量导入队列;接入监控告警 |
跟着做到哪一步卡住了?把报错贴出来,我们一起排查。 觉得有用的话,点个「在看」,让更多被"领导要求做知识库"的同行少踩点坑。
课程章节
09|收官:切片可编辑、知识库、鉴权,以及 20 条踩坑清单
正在检查解锁状态…