04|分块:父子分块的门道
上篇我们把文档拆成了一排整齐的积木。 现在要切块了,这一步决定了整个系统的上限。
切大了检索不准,切小了模型看不懂上下文。这个两难怎么破?
本篇你能学到
- 为什么"按固定字数切"一定会出问题
- 父子分块怎么一次切两层,各管各的事
- 父块的 5 条切分规则(章节聚合、表格独占、尾块合并)
- 子块的滑窗重叠:为什么重叠一点点反而更好
- Token 到底怎么数,为什么不能简单除以 4
一、切块的两难
先看一个真实的失败案例。文档里有这么一段:
商户可在「开放平台 → 开发配置」中修改回调通知地址。
修改后 5 分钟生效,生效前请保持旧地址可用。
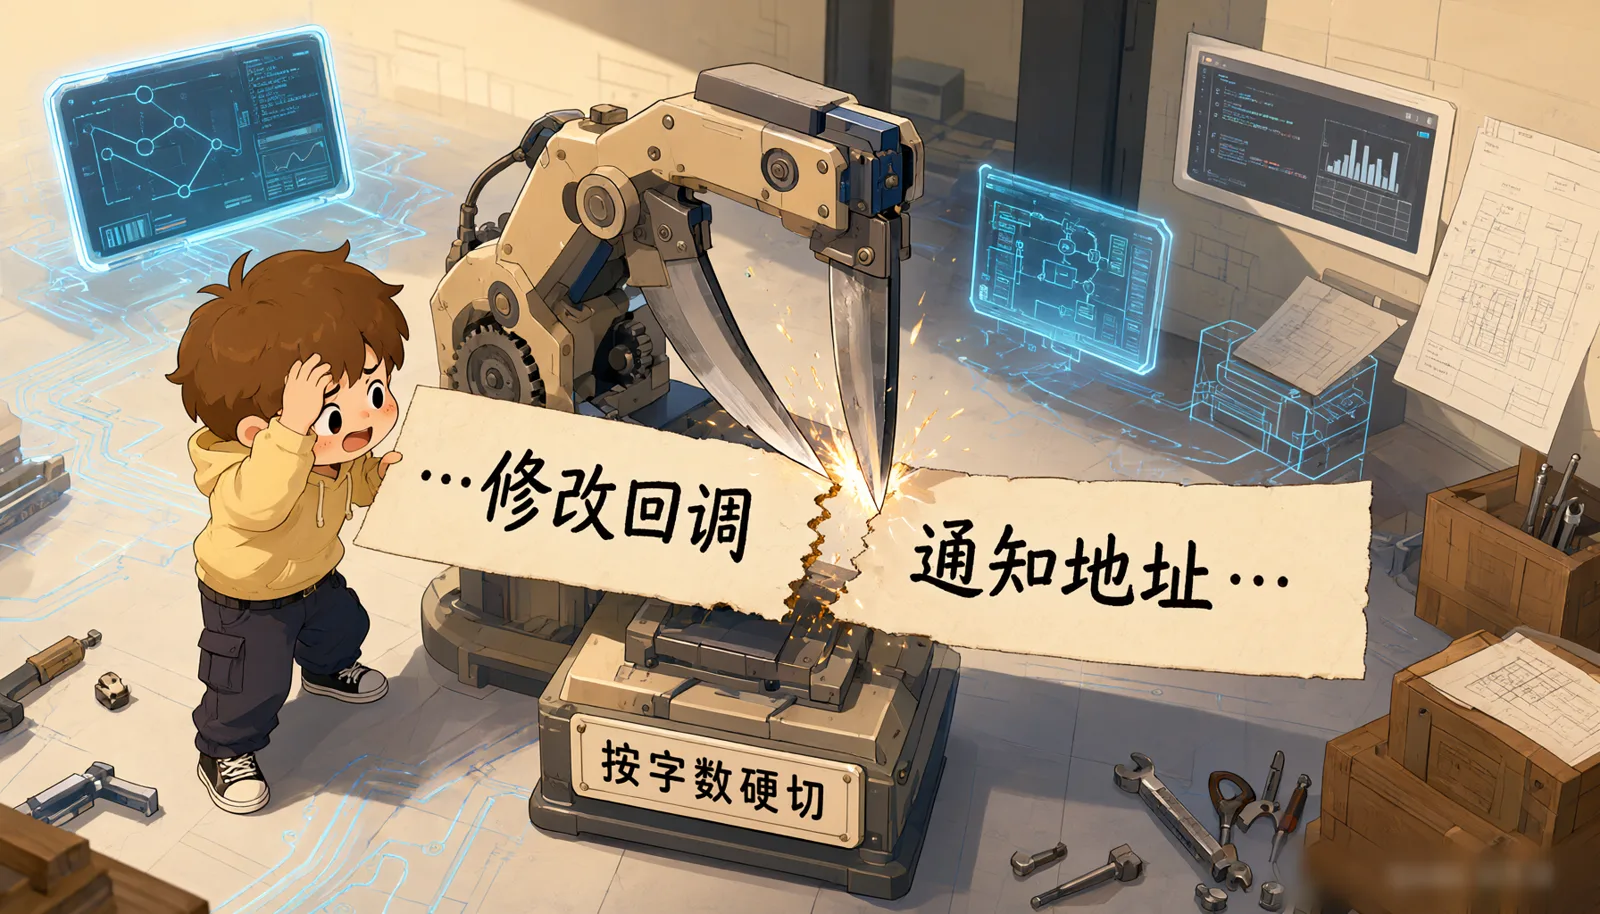
如果按 500 字机械硬切,很可能被切成:
【块 A】…商户可在「开放平台 → 开发配置」中修改回调
【块 B】通知地址。修改后 5 分钟生效…
用户问"回调地址在哪改",两个块都被召回了,但每个块只有半句话,模型看到"修改回调"和"通知地址"两个碎片,很难拼出完整答案。
两难正式表述
| 切法 | 检索 | 生成 |
|---|---|---|
| 切小(如 200 字) | ✅ 精准,噪声少 | ❌ 上下文残缺,模型看不懂 |
| 切大(如 2000 字) | ✅ 上下文完整 | ❌ 什么都有,检索不准 |
这两个目标是冲突的,一套切法满足不了。
解法:那就切两套
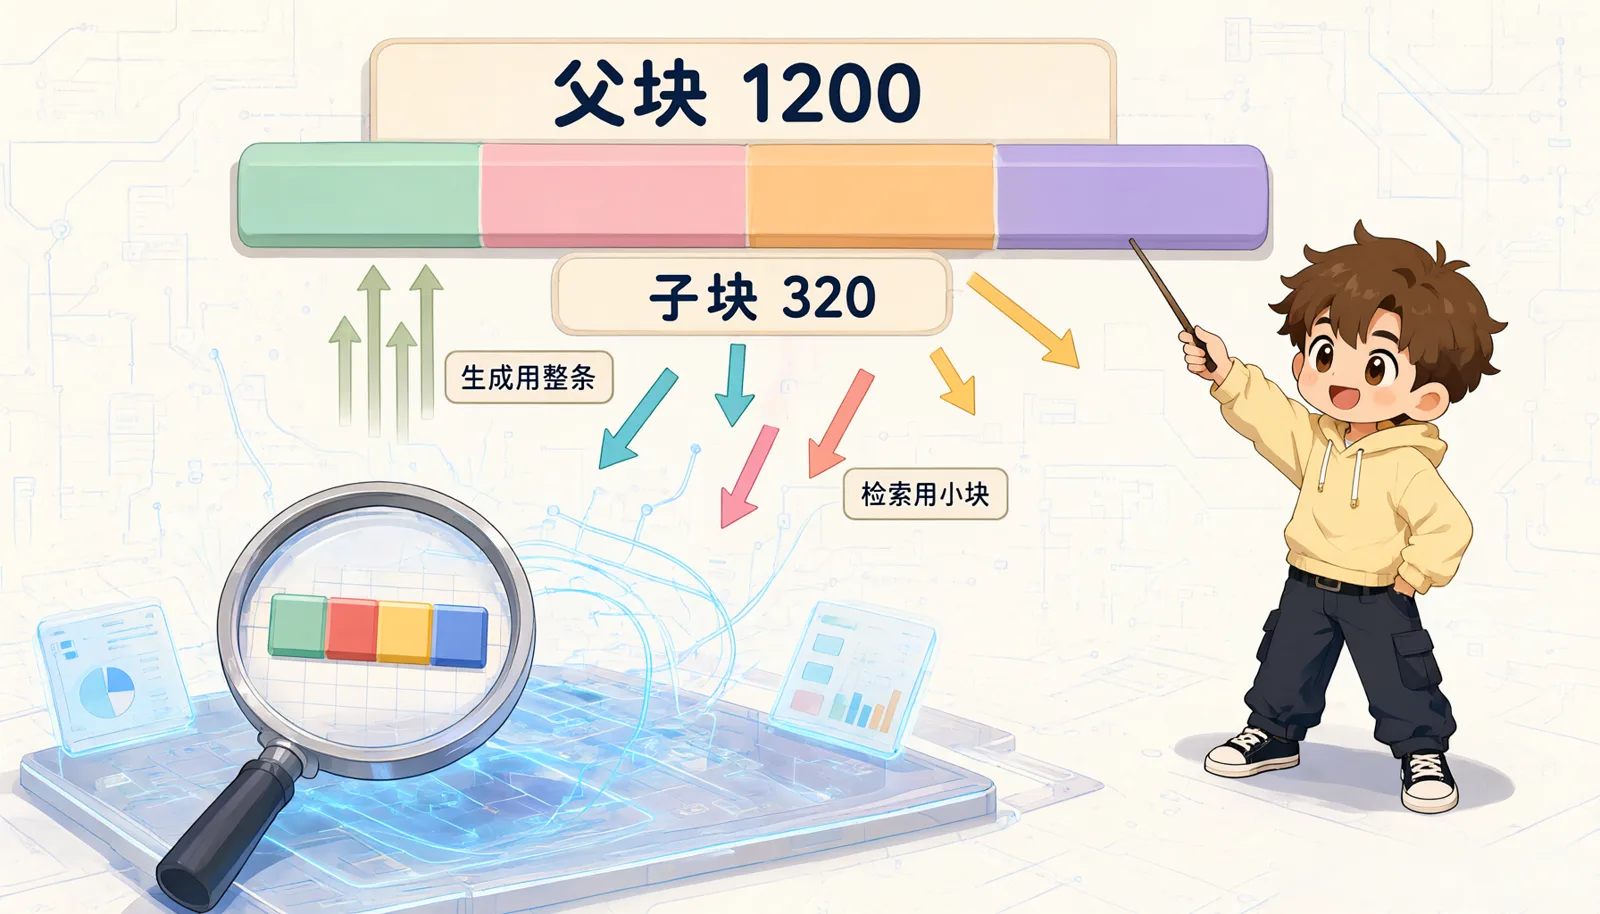
父子分块(Parent-Child Chunking):同一份内容切两层。
父块(Parent Chunk):大,约 1200 Token,按章节聚合,完整上下文
  └─ 子块(Child Chunk):小,约 320 Token,父块内部再切,带重叠

检索时:只查子块 → 精准命中
生成时:把命中的子块"上卷"回它的父块 → 完整上下文
小块负责被找到,大块负责被读懂。
这不是我们发明的,Dify 的"父子分段"就是同一个思路。但自己实现一遍,你才敢在生产环境里调参数。
二、先说 Token:为什么不能"字数除以 4"
切块的单位是 Token 不是字数。
Token 是模型看世界的最小单位。中文一个字大约 1~1.5 个 Token,英文一个词大约 1 个 Token,数字和标点又不一样。用"字数 ÷ 4"估算中文会严重低估。
精确计数:jtokkit
分词器 ← 取编码表(CL100K_BASE)
Token数 ← 分词器.数Token("回调通知地址配置")
预期结果:中文大致 1 字 1~1.5 个 Token,和下面降级估算的口径一致。
万一 jtokkit 不可用?降级估算
函数 估算Token数(文本):
    累计 ← 0
    遍历 文本的每个字符:
        如果 字符 > 0x2E7F:      # 中日韩字符分界线
            累计 ← 累计 + 1.5
        否则:
            累计 ← 累计 + 0.25
    返回 向上取整(累计)
0x2E7F 是 CJK 字符的分界线,大于它按中文算(1.5),小于等于按英文数字标点算(0.25)。
前端和后端必须用同一套计数,否则界面显示 300、后端判定 350 直接超限,用户会莫名其妙。我们的做法是:编辑时前端调 POST /api/tokens/count,让后端用同一套 jtokkit 算,网络异常才回退本地估算并标个 ≈。
三、父块怎么切:5 条规则
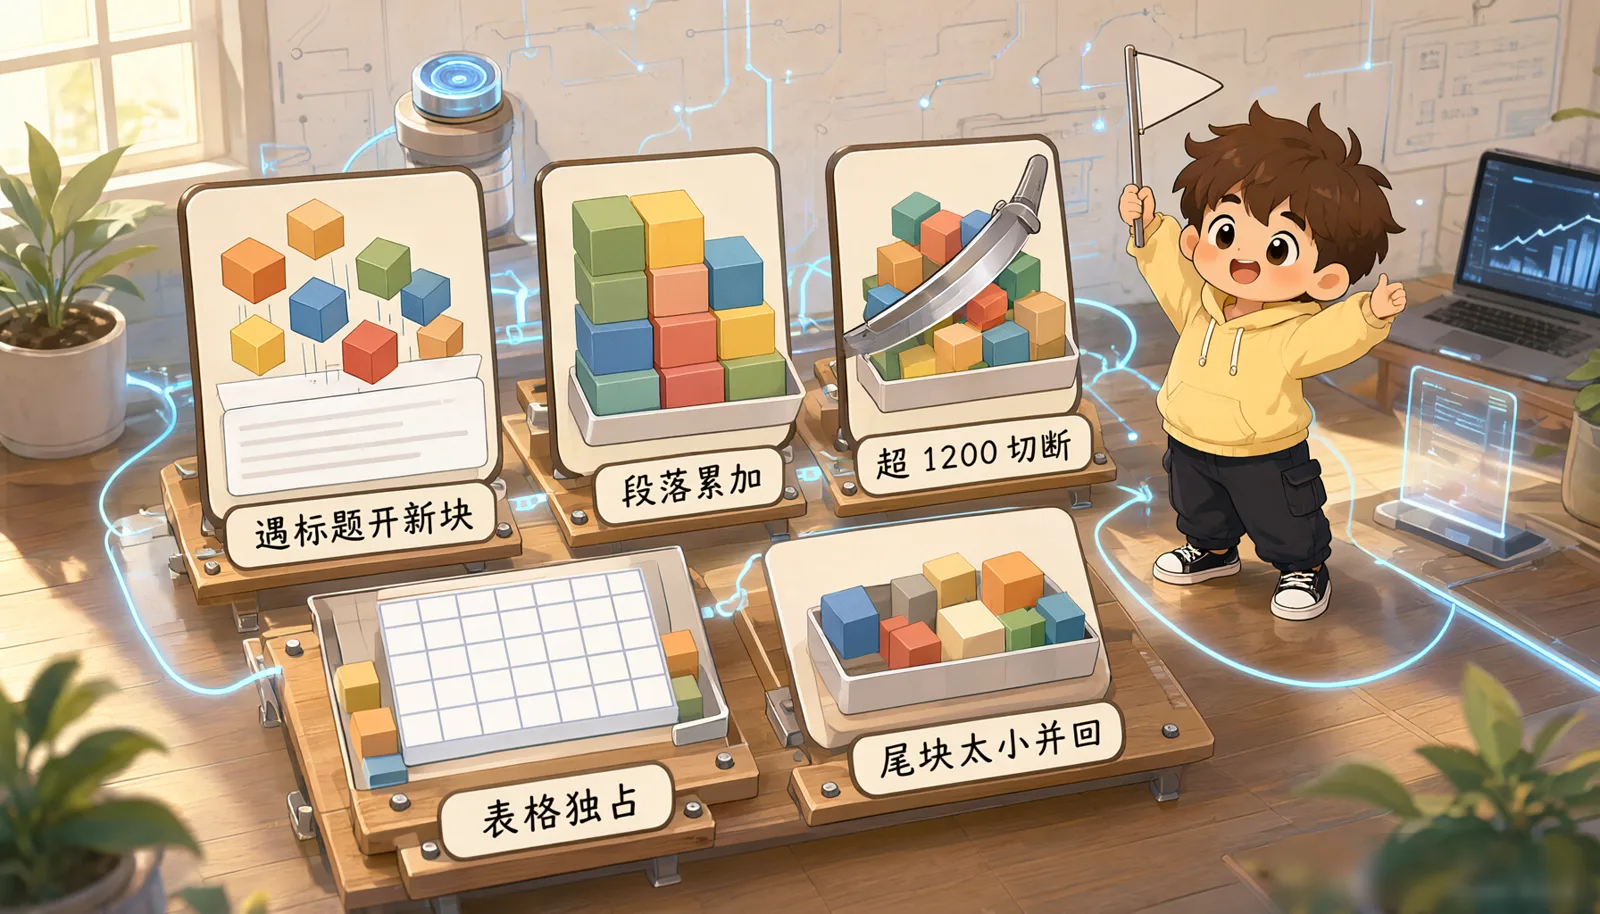
父块切分器(ParentChunker)按这几条规则跑:
kb:
  chunk:
    parent:
      max-tokens: 1200      # 上限
      min-tokens: 200       # 尾块下限
      heading-level: 2      # 一到二级标题就开新块
规则 1:遇到一级/二级标题就开新父块
如果 积木类型 是 HEADING 并且 标题层级 ≤ 2:
    结束上一个父块
    开启一个新父块,把这条标题记为它的 title
取 2 级是因为一级标题通常是一章(太大),三四级标题通常是一小节(太碎),二级标题正好是一个"能独立讲清楚一件事"的粒度。
规则 2:普通段落累加进去
段落、列表、代码,以及更深层级的小标题(3 级及以下),都累加到当前父块里。
规则 3:累加超限就在当前位置切断
如果 当前父块.Token数 + 这段文本.Token数 > 上限(1200):
    把 当前父块 落盘
    当前父块 ← 新父块(沿用最近的章节标题)
注意"沿用最近章节标题":一个长章节被切成两个父块时,第二个块也带上章节标题。这样它脱离上下文后仍然说得清自己属于哪。
规则 4:表格和幻灯片独占父块
如果 这块是原子块(TABLE 或 SLIDE):
    结束当前父块
    让这个原子块单独占一个新的父块
为什么必须独占? 表格混在正文里,切块时极可能被拦腰截断,一旦截断,"2024 年费率"就永远找不到了。
超长表格按行窗口拆分,每个窗口都重放表头和分隔行:
每个拆分窗口的内容 ← 表头行 + 分隔行 + 本窗口的数据行这样每个片段都是一张结构完整的独立小表格。
规则 5:尾巴太小就并回上一块
如果 最后一个父块.Token数 < 200 并且 上一个也是文本父块:
    把 最后一个父块 合并进 上一个父块
避免产生"只有一句话"的碎片父块,这种块既检索不准,又给不出有价值上下文。
四、子块怎么切:滑窗 + 重叠
子块切分器(ChildChunker)在每个父块内部独立运行:
遍历 每个父块:
    子块列表 ← 子块切分器.切(这个父块)     # 硬约束:子块边界绝不跨父块
"绝不跨父块"保证了上卷永远有明确归属,命中任何子块,都能确定地找到它的父块。
三种情况
① 如果 父块不是文本块(表格/幻灯片)并且 Token数 ≤ 320:
     整块就当 1 个子块,原样返回

② 如果 父块是超长表格:
     按表格行切窗口,每个子块都重放表头与分隔行

③ 如果 父块是普通文本或幻灯片:
     段落优先 → 句内滑窗 → 相邻子块保留重叠
重叠(overlap)是什么,为什么需要
kb:
  chunk:
    child:
      max-tokens: 320
      overlap-tokens: 48    # 相邻子块重叠 48 个 Token
重叠:下一个子块的开头,重复上一个子块结尾的一小段。
子块1:[……修改后 5 分钟生效。生效前请保持旧地址可用。]
子块2:[生效前请保持旧地址可用。如需更换域名,请提前报备。]
                    ↑ 这 48 个 Token 是重复的
为什么需要? 边界处的句子最容易被切碎。有了重叠,边界附近的内容在两个块里都完整存在,无论检索命中哪一边都能拿到完整的那句话。
重叠多少合适? 经验值:上限的 10%~20%。我们取 48 / 320 = 15%。太大浪费存储和检索预算,太小起不到保护作用。
单句超上限怎么办?硬切,但不丢内容
当 剩余文本.Token数 > 上限:
    前一段 ← 取前 N 个 Token(剩余文本)
    产出 前一段
    剩余文本 ← 取尾部 overlap 个 Token(前一段) + 剩余文本去掉前一段后的部分
# 关键:把上一刀的尾部重叠重新拼回剩余内容前面,保证一个字都不丢
关键在 tail(head, overlap) + 剩下部分:切完一刀后,把这一刀的尾部 overlap 重新拼到剩余内容前面,继续切。保证不丢任何一个字。
五、看一次分块日志
给一份 Markdown 文档,跑完两层切分后打印统计。以下为示意输出:字段与真实日志一致,数值为示例。
ingest stage=parent_chunk.done docId=7f3a… parents=12 tokensMin=210 tokensMax=1188 tokensAvg=760
ingest stage=child_chunk.done  docId=7f3a… children=47 tokensMin=88 tokensMax=318 tokensAvg=246
怎么读这几行:
- 12 个父块,平均 760 Token(没超 1200 上限 ✅)
- 47 个子块,平均 246 Token(没超 320 上限 ✅)
- 父块最小 210 Token,说明这份文档没切出特别碎的块。注意
min-tokens合并规则只作用于最后一个父块,中间的父块仍可能小于 200,所以这个最小值只能当参考,不能当"没有碎片"的证明
调优的三个信号:
| 现象 | 说明 | 怎么调 |
|---|---|---|
| 子块平均远小于上限 | 切太碎了 | 调大 child.max-tokens |
| 父块平均贴着上限 | 频繁触发硬切 | 调大 parent.max-tokens,或降低 heading-level |
| 父块数量 ≈ 子块数量 | 说明父块没被切开,可能是短文档 | 正常,无需处理 |
⚠️ 常见错误与排错
Q1:改了 max-tokens,为什么已经导入的文档没变化?
分块参数只在摄入时生效。 已经落库的分块不会自动重切。
三种处理:
- 删掉文档重新上传(最简单);
- 用第 9 篇的切片编辑手工调整;
- 写个一次性脚本重跑分块(改生产数据前务必备份)。
Q2:为什么我的表格答案总是答不对?
按顺序排查:
- 表格是不是被正确识别成了
TABLE块?看父块meta里有没有sheet_name或rows字段。 - 超长表格的子块有没有带上表头?打印一个子块看看第一行是不是
| 参数 | 说明 |。 - 检索时召回的是不是表格所在的子块?看日志
retrieval stage=recall hits=。
Q3:Token 数为什么和界面显示的不一样?
界面用的是后端同一套 jtokkit 算的。如果显示 ≈ 前缀,说明网络异常回退到了本地估算,这时数字不准,仅供参考。修好网络再刷新。
Q4:子块边界为什么看起来很奇怪,句子被切断了?
大概率是触发了硬切(单句超 320 Token)。这种情况说明你的文档里有超长段落(比如一整段没有句号的代码或日志)。正确做法是在源头优化文档格式,而不是无脑调大上限,调太大会牺牲检索精度。
Q5:heading-level 设成 1 会怎样?
只有一级标题才开新父块,父块会变得非常大(整章一个块),然后被规则 3 频繁硬切。除非你的文档一级标题非常密集,否则别改。
本篇小结
- 切块的两难:切小了检索准但上下文残,切大了上下文全但检索糊,一套切法满足不了。
- 父子分块:同一内容切两层,小块负责被找到,大块负责被读懂。
- 父块 5 条规则:二级标题开块、段落累加、超限切断、表格独占、尾块合并。
- 子块绝不跨父块,保证命中后能确定地上卷;48 Token 重叠保护边界处的句子。
- Token 不能按字数估,中文按 1~1.5/字;前后端必须用同一套计数器。
下一篇预告
切好的块已经躺在数据库里了,但它们的 embedding 字段全是空的。
按照很多教程的写法,到这里应该自动开始向量化了。但我们没有。
下一篇揭晓:为什么我们让你手动点一下"向量化"按钮,以及这个设计背后那条完整的状态机,它同时解决了"钱白花"和"失败了怎么办"两个问题。
下一篇预告:文档详情页上那颗等你点下的"向量化"按钮。
课程章节
04|分块:父子分块的门道
正在检查解锁状态…