06|检索:三路召回 + 两轮排序(本篇最长,也最值)
用户问:"回调地址怎么改?" 我们同时从三个方向去找:按意思、按词、按长相。
但问题来了,三路打的分根本不在一个量纲上,怎么公平地合在一起?
本篇偏实现。只想把系统用起来、不打算自己写检索的读者,读第一节和「本篇小结」就够,中间的 SQL 逐句拆解可以跳过。
本篇你能学到
- 三路检索各自解决什么问题,SQL 怎么写
- 为什么单路失败不能让整体失败(降级设计)
- RRF 融合:不看分数看名次,一句话讲明白
- Rerank 重排:让模型再审一遍卷子,以及失败后怎么兜底
一、为什么要三路?因为各有各的瞎
先看三路各自的"盲区":
| 通道 | 擅长 | 瞎在哪 |
|---|---|---|
| 向量(按意思) | "回调地址" → 找到"回调通知地址" | 遇到 KB-2024-0317 这种编号基本瞎 |
| 全文(按词) | 精确词匹配、专业术语 | 说法不一样就漏("怎么改" vs "修改方式") |
| 模糊(按长相) | 错别字、缩写、型号、部分匹配 | 语义完全无关但长得像的会误命中 |
单独用任何一路,都会漏掉另一路能轻易找到的内容。 所以三路一起上,互为补充。
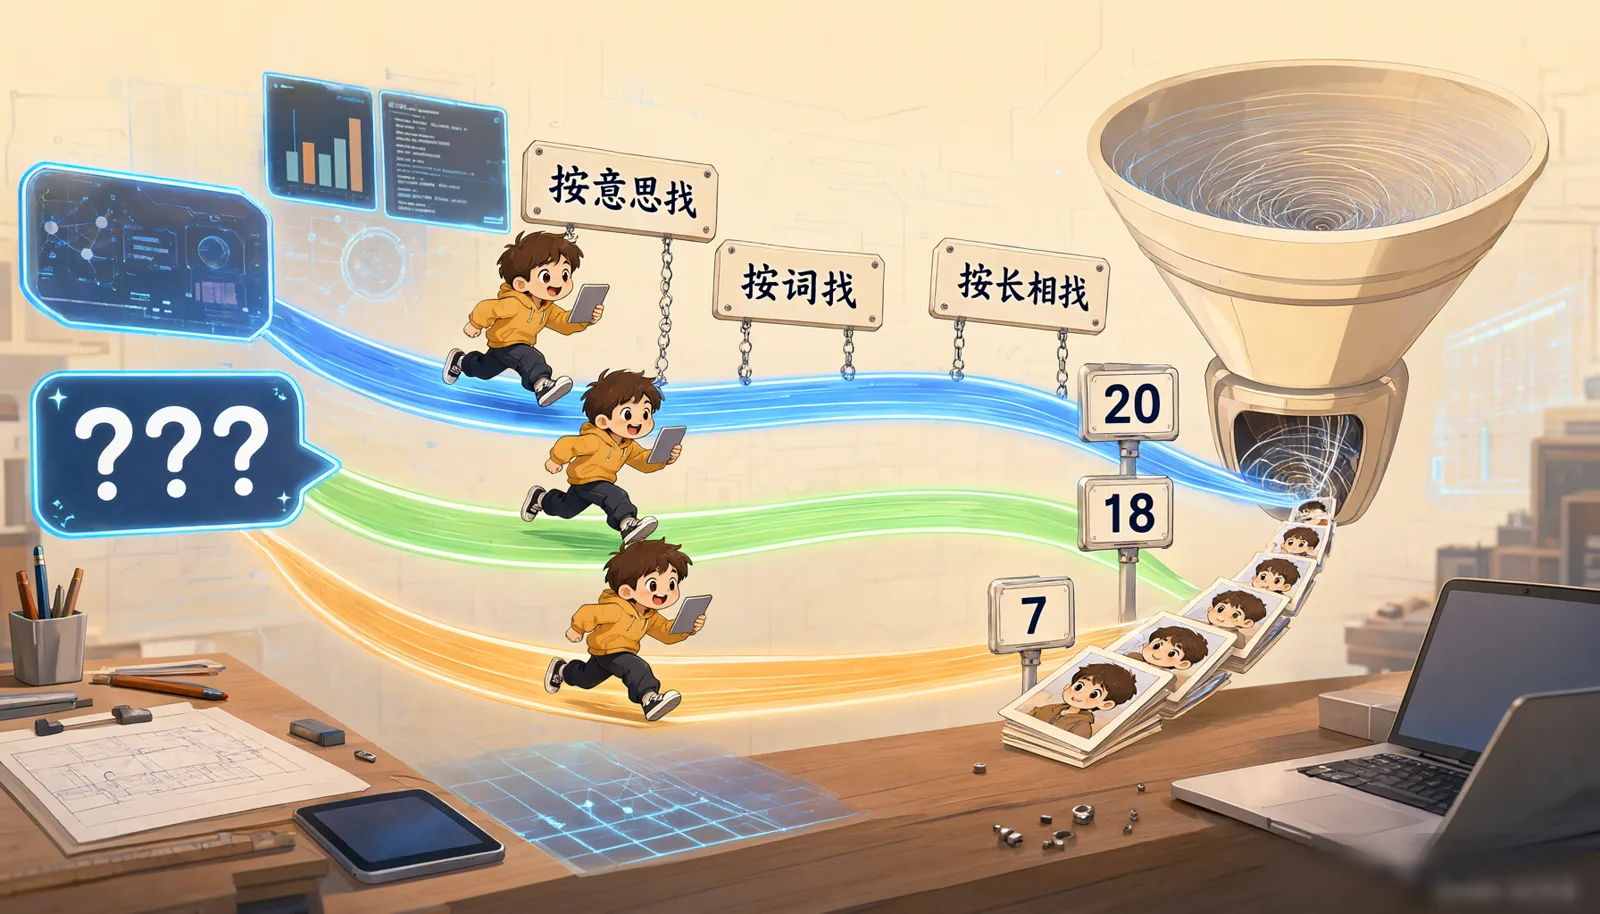
三路的代码:并行,各走各的
问题向量 ← 向量模型.embed(检索用文本)

同时发起三路(各占一个线程,互不等待):
    路1 ← 按向量找(问题向量, kbIds, 取前 20 条)
    路2 ← 按词找(原始问题,   kbIds, 取前 20 条)
    路3 ← 开一个只读事务:
              设置本次事务的相似度阈值 = 0.2      # ← 必须和下面的查询同事务
              按长相找(原始问题, kbIds, 取前 10 条)
注意模糊那路的 readOnlyTx:SET LOCAL pg_trgm.similarity_threshold 只在当前事务内生效,所以 SET 和 SELECT 必须共用同一个数据库连接。用事务模板包起来就是为了保证这点。
二、三路 SQL 逐句拆解
通道 1:向量检索(按意思)
在子块表里,找出向量距离最小的 20 条;只算有向量、且所属文档已完成的那些。
SELECT c.id, c.parent_id, c.document_id, c.seq, c.content, c.token_count, c.meta,
       1 - (c.embedding <=> #{queryVector}::vector) AS raw_score
FROM child_chunks c
WHERE 1 = 1
  AND c.embedding IS NOT NULL
  AND EXISTS (SELECT 1 FROM documents d
              WHERE d.id = c.document_id AND d.status = 'COMPLETED')
  /* kbIds 非空时下推知识库过滤 */
ORDER BY c.embedding <=> #{queryVector}::vector ASC
LIMIT 20
三个关键点:
<=>是余弦距离运算符,值越小越相似。1 - 距离换算成"相似度分数",越大越好。ORDER BY ... ASC:距离小(相似)的排前面。LIMIT 20:由kb.search.vector-top-k控制。
通道 2:中文全文检索(按词)
把问题切成中文词,在自带的分词索引里找命中的子块,按相关度排序取前 20 条。
SELECT ..., ts_rank_cd(c.search_content, q.query) AS raw_score
FROM child_chunks c,
     websearch_to_tsquery('zh_cfg', #{rawQuery}) q(query)
WHERE c.search_content @@ q.query
  AND c.embedding IS NOT NULL
  /* 同上:文档必须 COMPLETED */
ORDER BY raw_score DESC
LIMIT 20
用 websearch_to_tsquery 而不是 to_tsquery,是因为用户的问题里常有问号、括号、引号这些特殊字符。to_tsquery 遇到它们会直接报语法错误,websearch_to_tsquery 会自动忽略,这一个选择就省掉了一整类线上报错。
通道 3:模糊匹配(按长相)
不分词、不比语义,只看字面上像不像,错别字、型号、缩写全靠它兜底。先把阈值调到 0.2,再取最像的 10 条。
-- 前置:同事务内调低阈值(中文密度高,默认 0.3 太严)
SET LOCAL pg_trgm.similarity_threshold = 0.2;

SELECT ..., similarity(c.content, #{rawQuery}) AS raw_score
FROM child_chunks c
WHERE c.content % #{rawQuery}
  AND c.embedding IS NOT NULL
  /* 同上 */
ORDER BY c.content <-> #{rawQuery} ASC
LIMIT 10
⚠️ 一个会让你的数据库变慢 10 倍的坑:
WHERE 里必须写 content % 查询词(用运算符),才能命中 gin_trgm_ops 索引。
如果你写成 WHERE similarity(content, 查询词) >= 0.2,索引直接失效,退化成全表扫描。
WHERE c.content % '支付网关'                      -- ✅ 走索引
WHERE similarity(c.content, '支付网关') >= 0.2    -- ❌ 全表扫描
两道公共过滤(非常重要)
三路 SQL 都带这两段,它们是同一个 <sql> 片段。
① 只认"已经有向量 + 文档已完成"的子块;② 如果指定了知识库,就把范围限定在这些知识库的文档里。
-- ① 只有真完成的才参与
AND c.embedding IS NOT NULL
AND EXISTS (SELECT 1 FROM documents d
            WHERE d.id = c.document_id AND d.status = 'COMPLETED')

-- ② 知识库过滤下推
AND c.document_id IN (
    SELECT dkb.document_id FROM document_knowledge_bases dkb
    WHERE dkb.knowledge_base_id IN (...)
)
知识库过滤下推到 SQL 层,而不是先全库检索再在内存里筛,数据量一大,这个差别就是 100ms 和 3 秒的区别。
三、降级:单路失败只丢一路
遍历 每一路的结果:
    尝试:
        命中列表 ← 取回这一路的结果
        如果 命中列表 非空:
            加入待融合列表
    捕获异常:
        记日志("这一路失败,降级")
        # 单路失败只丢这一路,绝不整体失败
这是"可用性优先"的设计:三路里挂掉一路,剩下两路照样能给出答案。用户感知到的只是"好像漏了点什么",而不是"系统报错了"。
预期日志(字段与真实日志一致,数值为示例):
retrieval channel=vector   queryId=a3f2 hits=20 topK=20 topScore=0.81 elapsedMs=42
retrieval channel=fulltext queryId=a3f2 hits=18 topK=20 topScore=0.94 elapsedMs=28
retrieval channel=fuzzy    queryId=a3f2 failed, degraded: 连接超时
retrieval stage=recall     queryId=a3f2 channels=2 hits=38 elapsedMs=47
看到 channels=2 说明模糊那路挂了,但检索继续。 这是正常的降级行为,不是 bug。
四、RRF 融合:不看分数,看名次
问题:三路的分数没法直接比
- 向量分数:0 ~ 1 的余弦相似度
- 全文分数:
ts_rank_cd输出,可能是 0.06 这种小数 - 模糊分数:0 ~ 1 的相似度
直接相加毫无意义,全文那路的 0.06 会被向量的 0.8 完全淹没,哪怕全文那路把它排在第一名。
解法:只看名次,不看分数
RRF(Reciprocal Rank Fusion,倒数秩融合):
某个文档的最终分 = Σ 各路排名贡献

某一路的贡献 = 1 / (k + 该文档在这一路的名次)
其中 k 是平滑常数,我们取 60。
举个例子
假设某子块在三路的名次是:向量第 1 名、全文第 3 名、模糊没进榜。
向量贡献 = 1 / (60 + 1) = 0.01639
全文贡献 = 1 / (60 + 3) = 0.01587
--------------------------------
最终分   = 0.03226
另一个子块:只在向量第 2 名。
向量贡献 = 1 / (60 + 2) = 0.01613
--------------------------------
最终分   = 0.01613
结果:第一个块(被两路同时找到)赢了,尽管它在某一路不是第一。
RRF 想表达的就是这件事:多路都认可的结果,比单路的高分更可信。
代码(短得出奇)
遍历 每一路的命中列表:
    遍历 该列表中的每个子块(下标从 0 开始):
        名次 ← 下标 + 1                     # ← 排名从 1 开始,别写错
        总分表[子块ID] ← 累加 1 ÷ (60 + 名次)

按 总分 从高到低排序
取前 50 个送去重排融合宽度:rrf-top-n: 50。三路最多召回 20+20+10=50 条,去重后取前 50 送去重排,去重只会让条数变少,融合结果不可能超过三路命中总数。
五、Rerank:让模型再审一遍卷子
RRF 很快、很稳,但它只看名次,不理解语义。需要最后一道精排。
调用云端重排模型
请求体 ← {
    model:     "qwen3-rerank",
    query:     原始问题,
    documents: 候选子块的正文列表,
    top_n:     15
}

响应 ← 发送 POST 到  /reranks
# 超时设置:连接 5 秒、读取 30 秒
超时设置很关键:连接 5 秒、读取 30 秒。重排是串行阻塞的,超时会拖垮整个问答。
⚠️ 端点前缀别写错:
kb:
  embedding:
    base-url: https://dashscope.aliyuncs.com/compatible-mode     # 向量化
  rerank:
base-url: https://dashscope.aliyuncs.com/compatible-api/v1 # 重排这两个前缀不一样(compatible-mode vs compatible-api/v1),不能混用。 写错会得到 404,而且容易误以为是密钥问题。
解析结果:注意用 index 回查
遍历 响应里的 results 数组:
    序号 ← 该项的 index            # 指向候选数组的下标
    子块 ← 候选列表[序号]
    子块.分数 ← 该项的 relevance_score
    加入结果列表
重排服务只返回"第几个候选、多少分",不返回内容。 必须用 index 回查候选列表。
失败降级:这是必须做的
尝试:
    重排结果 ← 重排服务.重排(问题, 融合结果, 取前 15)
捕获异常:
    记日志("重排失败,降级为融合结果的前 N 条")
    重排结果 ← 融合结果的前 15 条
    父块命中加分权重 ← 0            # ← 降级时关掉加分
重排服务挂了,直接用 RRF 的前 15 条继续。 用户拿到的是"未经精排"的答案,比"没有答案"强得多。
一次完整的检索日志
以下为示意输出:字段与真实日志一致,数值为示例。注意
hits是三路命中数之和,fused是去重后的条数,所以fused一定不大于hits。
retrieval start             queryId=a3f2 questionLength=8 kbCount=2 hyde=false
retrieval stage=embed.query queryId=a3f2 dimensions=1024 elapsedMs=95
retrieval stage=recall      queryId=a3f2 channels=3 hits=45 elapsedMs=132
retrieval stage=rrf         queryId=a3f2 fused=41 topScore=0.0326
retrieval stage=rerank.done queryId=a3f2 returned=15 elapsedMs=310 topScore=0.912
retrieval stage=aggregate   queryId=a3f2 segments=6 budget=4790 usedTokens=4210 totalMs=561
retrieval done              queryId=a3f2 recallMs=132 rerankMs=310 totalMs=561
561 毫秒完成一次完整检索。三段耗时(embed / recall / rerank)分开打点,哪里慢一眼看到。
⚠️ 常见错误与排错
Q1:检索 hits=0,什么都找不到?
按顺序排查:
- 文档状态是
COMPLETED吗?(第 5 篇的头号坑) - 子块
embedding有值吗?SELECT count(*) - count(embedding) FROM child_chunks WHERE document_id='...',必须等于 0。 - 知识库绑对了吗? 提问时选了知识库 A,但文档绑在库 B → 全部过滤掉。
- 中文全文那路是不是
zh_cfg配置缺失? 手动跑SELECT to_tsvector('zh_cfg','支付')验证。
Q2:向量检索很慢?
三个排查点:
- HNSW 索引建了吗?
SELECT indexname FROM pg_indexes WHERE tablename='child_chunks',必须有idx_child_embedding。 - 索引后缀是
vector_cosine_ops吗? 写错会导致索引不生效。 - 数据量大了没调
ef_search? HNSW 的召回率靠ef_search控制,默认偏保守,可以调大。
Q3:模糊那路永远返回 0 条?
检查阈值设置:
SHOW pg_trgm.similarity_threshold; -- 默认是 0.3我们在检索时动态调到 0.2(中文密度高,0.3 太严)。如果你直接手动跑 SQL 忘了 SET LOCAL,就会用默认的 0.3,中文基本匹配不上。
Q4:重排一直报错 404?
99% 是 base-url 前缀写错了。 确认是 compatible-api/v1 不是 compatible-mode。
Q5:开启 HyDE 会更准吗?
HyDE(先让模型写一段"假设性答案",再用它去检索)在长问句、口语化提问上有帮助,但会多一次大模型调用,首字延迟明显增加。
默认关闭。开启:
kb:
  search:
    hyde-enabled: true
建议先不开,等基础检索调稳了再评估。
Q6:三路里有一路老是失败,能关掉吗?
代码里没有直接开关,但它失败时会自动降级,效果等同于关掉。如果你想彻底不查某一路,改对应 SQL 的 LIMIT 为 0 即可(不推荐,先排查为什么失败)。
本篇小结
- 三路互补:向量按意思、全文按词、模糊按长相,单独用任何一路都会漏。
websearch_to_tsquery能忽略问号括号,比to_tsquery省掉一整类报错。- 模糊匹配
WHERE必须写%运算符,写成similarity(...) >= x会让索引失效、全表扫描。 - 知识库过滤下推到 SQL,不要捞全库再内存筛。
- 单路失败只降级不失败,日志里看到
channels=2是正常的降级行为。 - RRF 只看名次不看分数,公式
1/(k+名次),k=60,天然解决了三路分数量纲不同的问题。 - Rerank 失败自动降级为 RRF 前 15,用户拿到"没精排"的答案,好过没有答案。
下一篇预告
现在我们手上有 15 个精排后的子块,每个约 300 Token。
但直接把这 15 个小碎片丢给模型,它答不好,因为它看不到上下文。
下一篇讲怎么把这些小碎片"上卷"回它们的大父块,以及父块太大装不下时怎么降级。
顺带解决一个很现实的问题:大模型的"书包"就那么大,装不下的内容怎么办?
下一篇预告:小磁铁被吸回大铁块,旁边是那个装不下的小书包。
课程章节
06|检索:三路召回 + 两轮排序(本篇最长,也最值)
正在检查解锁状态…