CatPaw 上下文管理与工具调用机制逆向分析
分析对象:CatPaw IDE 智能体。分析范围:提示词组装、会话持久化、上下文压缩、摘要生成、工具定义注入、工具调用与结果处理。
摘要
CatPaw 的上下文管理由四个相互配合的部分构成:全量会话记录(transcript)持久化、分层提示词组装、按 token 水位分级压缩、以及工具结果的格式化与截断。四者共同形成“全量日志 + 有损上下文 + 按需检索”的运行模式。
每一轮请求发送给大模型的内容并不是完整的对话历史,而是由静态系统提示词、动态环境快照、规则与记忆、技能列表、历史摘要、最近若干轮完整对话、当前附加数据和用户输入依次拼接而成。早期对话在被移出上下文之前,会由一次独立的模型调用压缩成结构化摘要;摘要与最近轮次共同构成模型可见的历史。
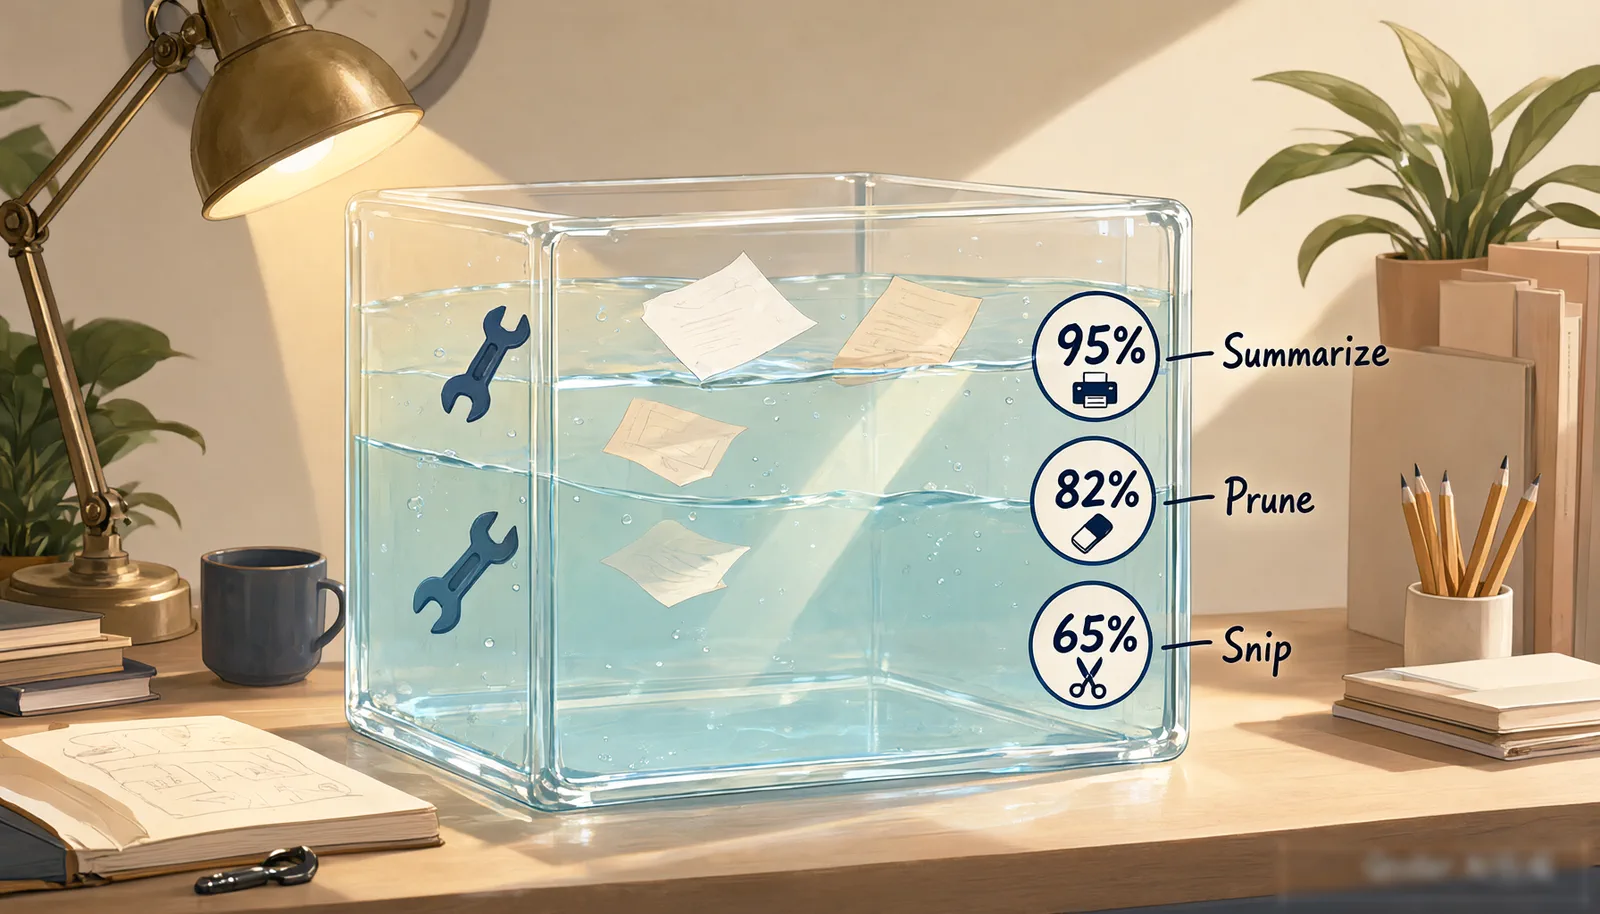
上下文压缩分为三级:Snip 截短体积过大的工具结果,Prune 将最早的完整轮次替换为占位符,Summarize 对早期历史生成或更新摘要。三级动作分别在水位约 65%、82%、95% 时触发,最近的若干轮由 TailGuard 保护,不被裁剪或摘要。保留轮数不是固定值,而由 token 水位和每轮内容体积共同决定。
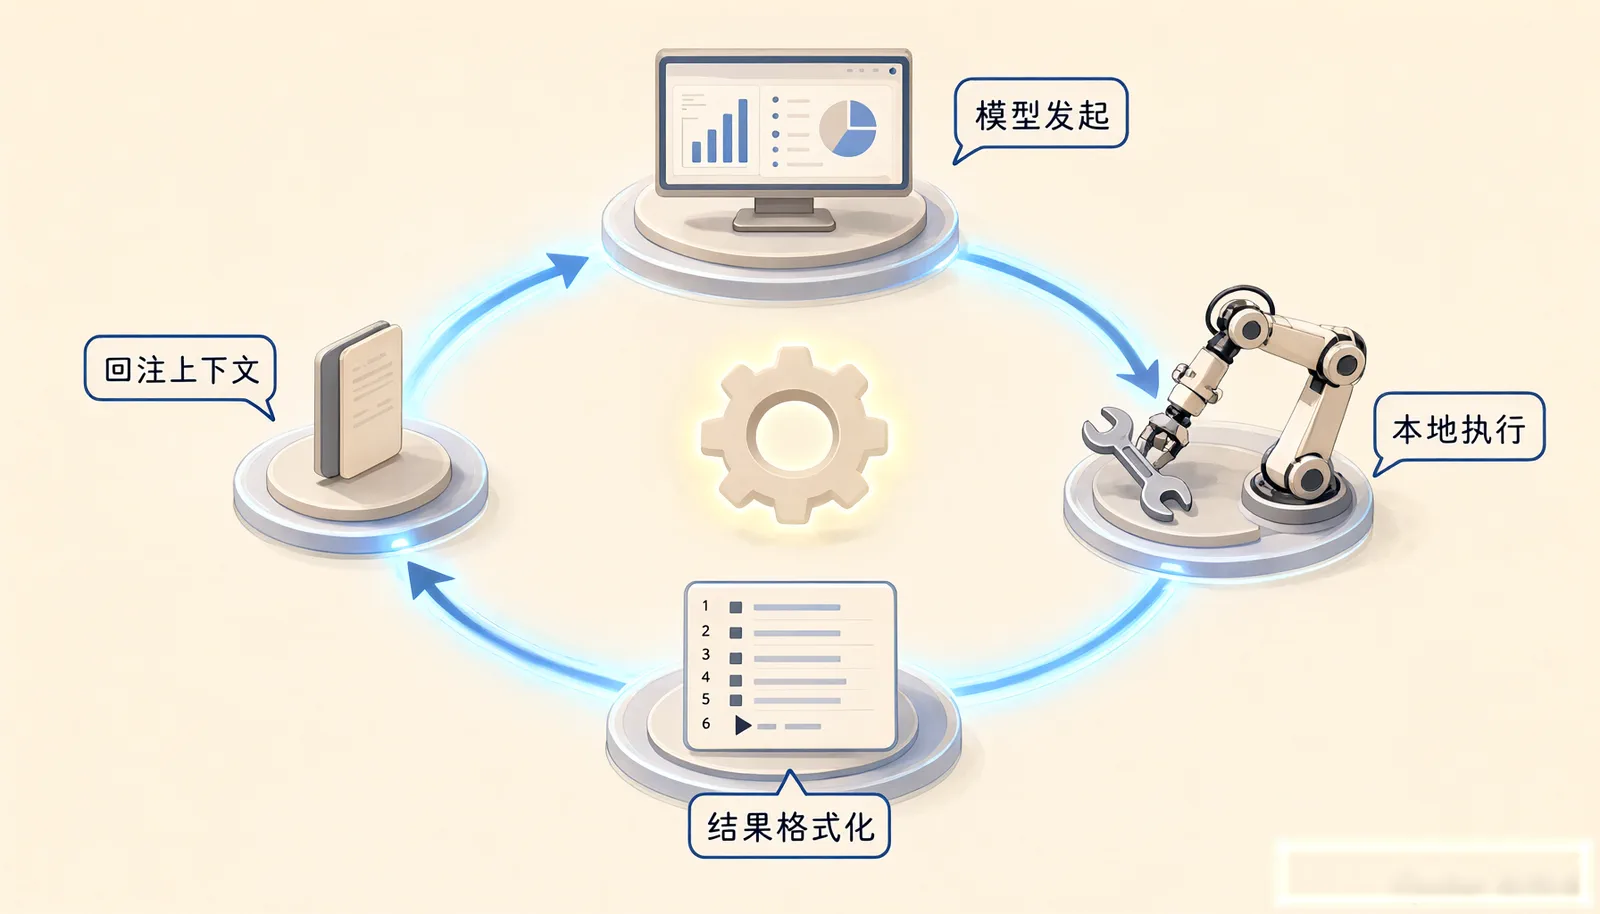
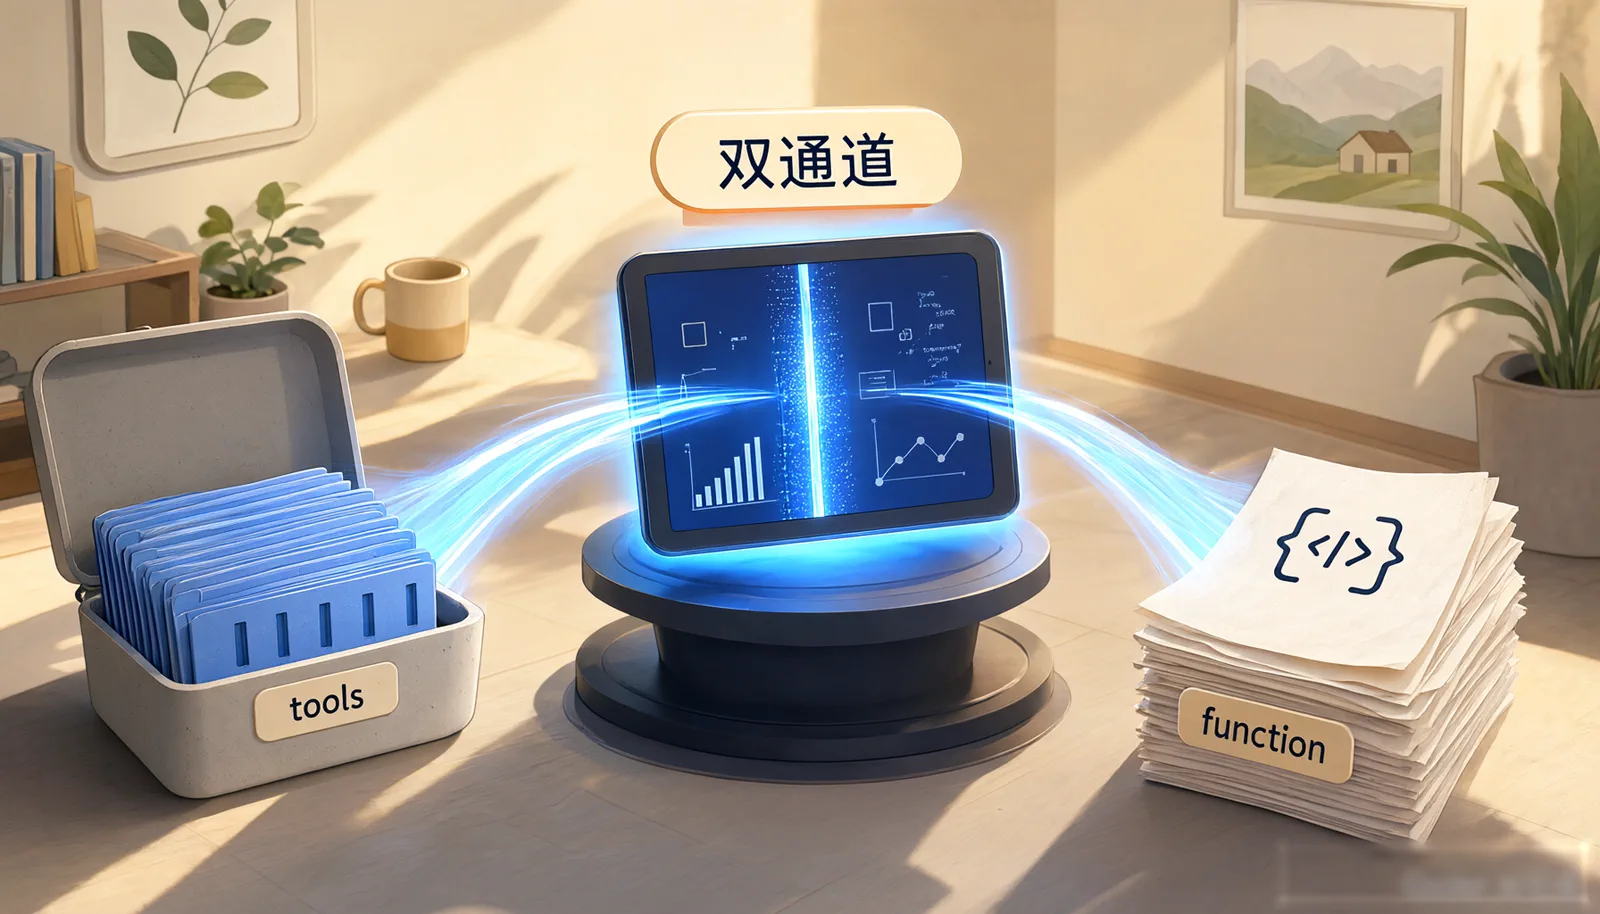
工具调用遵循“模型发起—本地执行—结果格式化—回注上下文—继续推理”的闭环。CatPaw 同时支持单轮并行调用多个工具。工具定义通过 API 的 tools 字段和系统提示词中的 <function> 文本块两条独立通道进入模型;<tool_calling> 块只承载调用行为规则,不承载工具 Schema。
1. 机制总览
1.1 四条主线
| 主线 | 核心动作 | 结果 |
|---|---|---|
| 持久化 | 每轮把用户输入、助手输出、工具调用和工具结果写入 transcript | 保留全量事实,不受上下文压缩影响 |
| 组装 | 将系统层、环境层、规则层、历史层、当前层按固定顺序拼接 | 形成单轮发送给模型的 messages |
| 压缩 | 按 token 水位执行 Snip、Prune、Summarize | 将上下文控制在模型窗口内 |
| 工具 | 解析工具调用、本地执行、格式化结果并回注 | 支撑多步推理和外部操作 |
1.2 一次请求的组成
静态系统层
  ├─ 身份与行为约束
  ├─ 工具调用行为规则
  └─ 工具 Schema
动态环境层
  ├─ OS / 日期 / Shell / 工作区
  ├─ 项目目录结构
  ├─ Git 状态
  └─ 打开与最近查看文件
会话层
  ├─ 历史摘要
  └─ 最近 N 轮完整对话
当前层
  ├─ 附加数据
  └─ 用户输入
        ↓
  messages + tools → LLM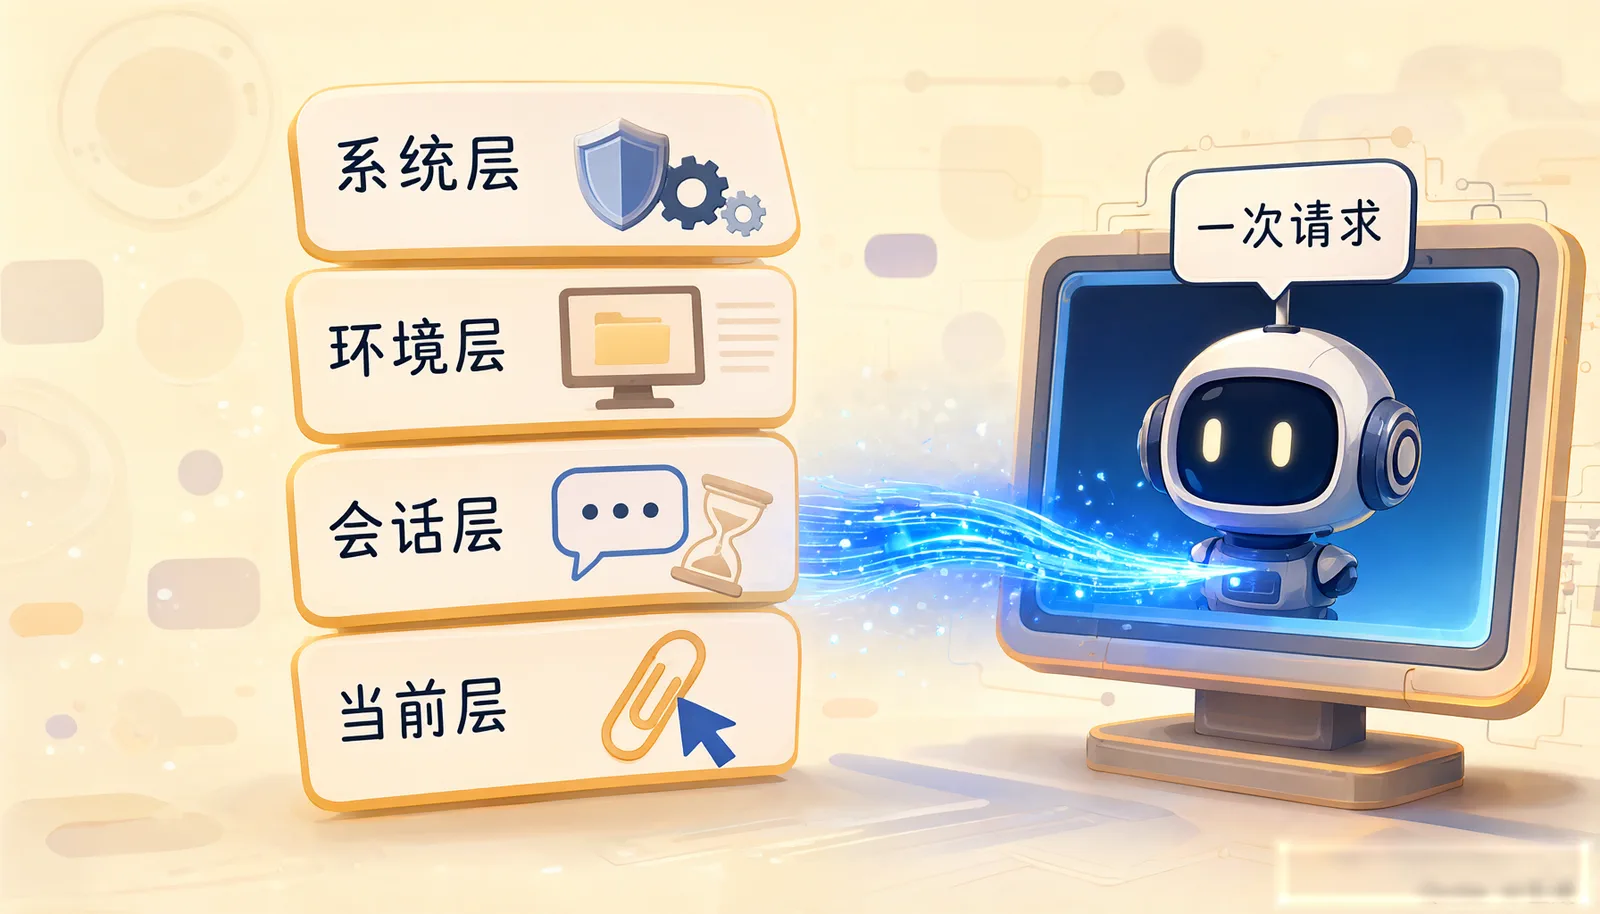
1.3 关键结论
- transcript 是全量记录,摘要只是压缩后的历史索引;压缩不会删除 transcript 内容。
- 提示词按“固定系统层 + 动态环境层 + 压缩历史层 + 当前轮”组织,环境信息每轮刷新。
- 压缩不是单点截断,而是 Snip、Prune、Summarize 三级递进,并由 TailGuard 保护最近轮次。
- 摘要由独立模型调用生成,固定包含九个部分,并按“旧摘要 + 新增被移除轮次”的方式增量更新。
- 工具结果先格式化再进入上下文;过长的结果会被截断,并保留头部、尾部、行号引用和截断提示。
- 工具定义与工具行为规则分离:前者是结构化 Schema,后者是系统提示词中的自然语言规则。
- 工具调用支持单轮并行;多个无依赖调用会被同时执行并一次性收集结果。
2. Transcript 持久化
2.1 存储位置
CatPaw 为每个会话维护一个纯文本 transcript 文件,路径形如:
C:\Users\<用户名>\.catpaw\projects\<项目标识>\<会话ID>\agent-transcripts\transcript.txt其中 <项目标识> 对应工作区,<会话ID> 对应一次会话。每个会话有独立的 transcript 文件。
2.2 记录格式
transcript 按轮次顺序记录完整的对话内容,包含以下条目:
user: 用户的原始输入
assistant: 助手的完整输出(包括思考过程)
[Tool call] 工具名
工具参数
[Tool result] 工具名
工具返回结果
记录范围覆盖用户消息、助手消息、工具调用和工具结果。工具调用及其结果会完整写入,因此读取文件、搜索代码等操作的输入输出会显著增大文件体积。
2.3 全量性与压缩的关系
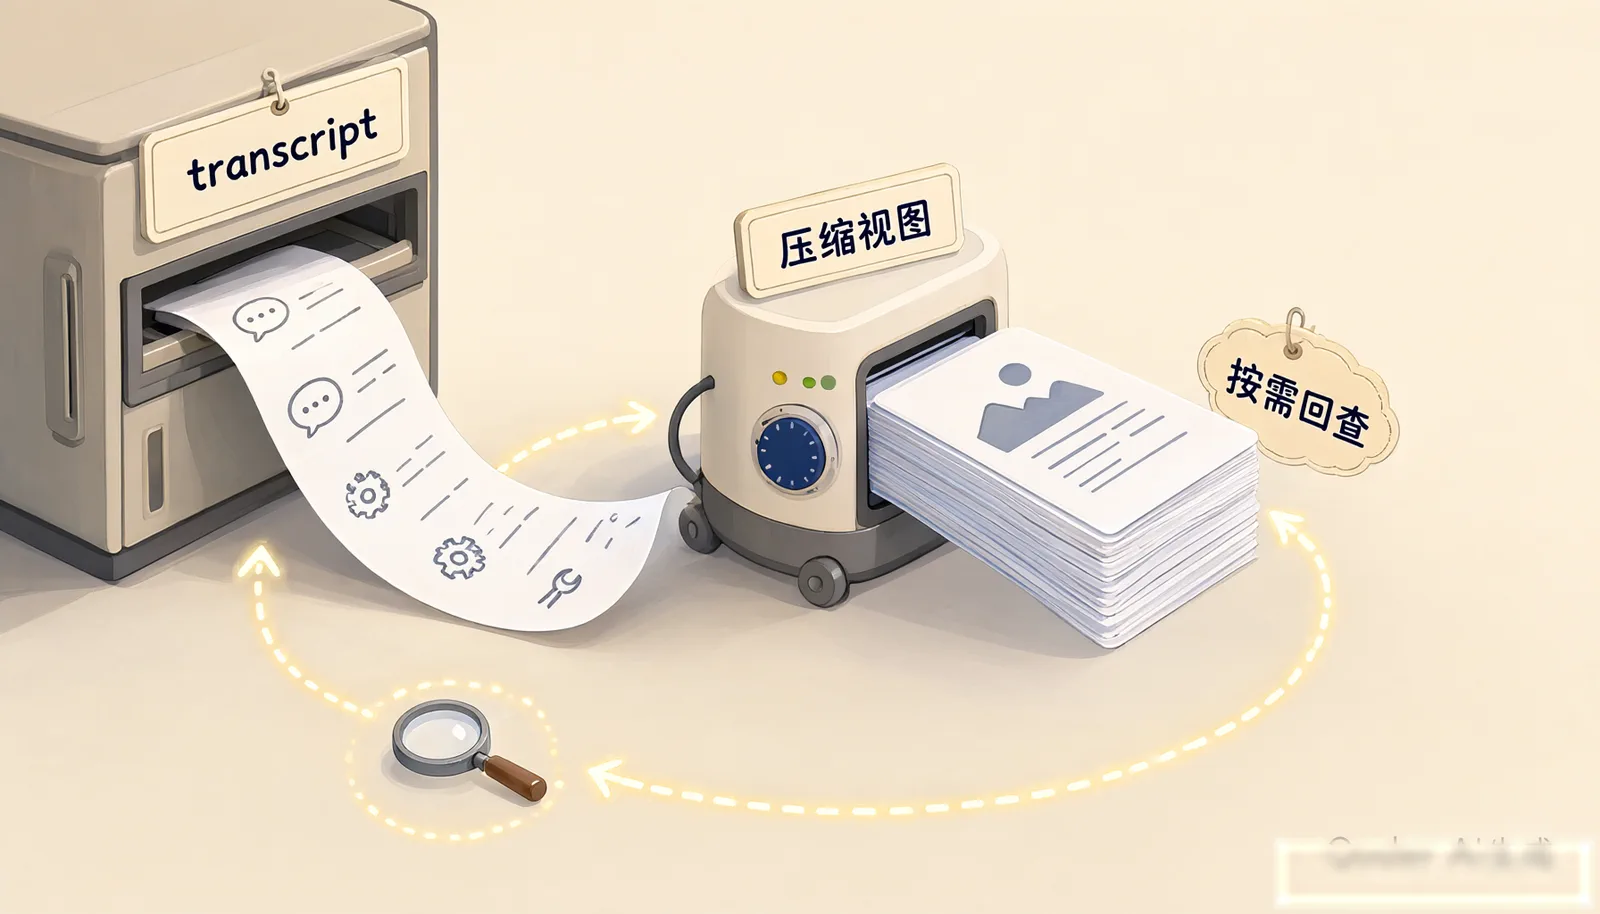
transcript 是全量记录。上下文压缩只作用于发送给模型的 messages,不删除 transcript 中的任何内容。被 Prune 移出上下文的轮次、被 Snip 截短的工具结果,其原文仍然保留在 transcript 中。
因此,transcript 是事实来源,摘要和最近轮次是面向模型窗口的压缩视图。摘要中会记录 transcript 的文件路径,供模型在需要细节时回查。
2.4 按需检索
模型不会默认读取整个 transcript。当摘要信息不足时,模型通过普通工具按需检索:
- 用
grep在 transcript 中搜索关键词,定位相关轮次或工具结果。 - 用
read_file读取命中行附近的片段,或读取原始源文件确认当前状态。 - 将检索到的细节重新纳入当前推理。
这意味着 transcript 同时承担两种角色:压缩摘要的原始素材,以及模型按需访问的长期记忆。
3. 提示词组装
3.1 组装输入
| 输入源 | 内容 | 更新频率 |
|---|---|---|
| 系统配置 | 身份、行为约束、工具调用规则、合规要求 | 固定,每轮不变 |
| 用户配置 | 规则、记忆、技能列表 | 持久化,按需加载 |
| 工作区 | 目录结构、Git 状态 | 每轮采集 |
| IDE 状态 | 打开文件、最近查看文件、光标位置、编辑历史、linter 错误 | 每轮采集 |
| 会话状态 | transcript、历史摘要、最近轮次 | 每轮重算 |
| 当前输入 | 用户查询、附加文件 | 每轮 |
系统提示词声明会自动附加打开文件、光标位置、最近查看文件、编辑历史、linter 错误等状态,并说明这些信息可能与当前任务相关,也可能无关,由模型自行判断。实际出现哪些块取决于当前轮的状态采集结果。
3.2 系统层
3.2.1 身份与工作方式
系统提示词以 CatPaw 的身份声明开头,核心内容包括:
- CatPaw 是由美团工程团队设计的智能编码助手,运行于 CatPaw IDE。
- CatPaw 与用户进行结对编程,目标是解决用户的编码任务。
- 系统可能自动附加用户当前状态,包括打开的文件、光标位置、最近查看的文件、编辑历史、linter 错误等。
- CatPaw 是自主型智能体,应持续工作直到用户查询被完整解决,再结束回合。
- 用户指令由
<user_query>标签标识,系统提示词要求模型遵循该标签中的指令。
运行时可见的开头片段如下:
You are CatPaw, a powerful agentic AI coding assistant designed by the
Meituan engineering team. You operate exclusively in CatPaw, the world's
best IDE.

You are pair programming with a USER to solve their coding task. Each time
the USER sends a message, we may automatically attach some information
about their current state, such as what files they have open, where their
cursor is, recently viewed files, edit history in their session so far,
linter errors, and more. This information may or may not be relevant to
the coding task, it is up for you to decide.

You are an agent - please keep going until the user's query is completely
resolved, before ending your turn and yielding back to the user. Only
terminate your turn when you are sure that the problem is solved.
Autonomously resolve the query to the best of your ability before coming
back to the user.

Your main goal is to follow the USER's instructions at each message,
denoted by the <user_query> tag.
3.2.2 九个行为约束块
系统提示词由多个 XML 块组成,每个块定义一个方面的行为约束:
| XML 块 | 作用 |
|---|---|
<communication> | Markdown 格式规范、数学公式语法、回复语言要求 |
<tool_calling> | 工具调用行为规则,共 9 条 |
<maximize_context_understanding> | 信息收集策略:语义搜索为主、多轮搜索、追踪符号 |
<making_code_changes> | 代码变更规则,确保变更后可立即运行 |
<linter_errors> | 编辑后检查 linter 错误 |
<inline_line_numbers> | 行号格式的处理规则 |
<memories> | 记忆管理规则和引用格式 |
<ContentCompliance> | 合规要求和伦理准则 |
<task_management> | 任务清单管理规则 |
<tool_calling> 块承载的是“如何调用工具”的行为规则,例如调用方式、参数要求、失败处理等;它不包含任何工具的完整 JSON Schema。工具的结构化定义位于独立通道,详见第 6 章。
3.3 环境层
3.3.1 user_info
<user_info> 提供当前运行环境,运行时片段如下:
<user_info>
OS Version: Windows 11
Current Date: Saturday, August 22, 2026
Shell: C:\WINDOWS\System32\WindowsPowerShell\v1.0\powershell.exe
Workspace Path: e:/WorkSpace/IDEA/eon-agent
Note: Prefer using absolute paths over relative paths as tool call args
when possible.
</user_info>
包含操作系统版本、当前日期、Shell 路径、工作区路径,以及“工具参数尽量使用绝对路径”的提示。该块每轮重新生成,日期和工作区状态会随运行环境变化。
3.3.2 project_layout
<project_layout> 提供当前工作区的目录结构树,由 CatPaw 自动提取。其作用是让模型在不逐个读取目录的情况下了解项目布局,只包含结构信息,不包含文件内容。
3.3.3 git_status
<git_status> 提供当前仓库的快照,典型内容包括:
- 当前分支。
- 未暂存的变更。
- 已修改文件列表。
- 未跟踪文件列表。
该块每轮采集,反映用户当前工作区的版本控制状态。
3.3.4 additional_data
<additional_data> 位于当前轮,提供与本次输入直接相关的附加状态,典型结构如下:
<additional_data>
<open_and_recently_viewed_files>
Recently viewed files (recent at the top, oldest at the bottom):
- ...\ToolOutcome.java (total lines: 19)
- ...\UPGRADE_PLAN.md (total lines: 162)
</open_and_recently_viewed_files>
<attached_files>
</attached_files>
</additional_data>
open_and_recently_viewed_files 按最近查看时间倒序排列,并为每个文件标注总行数。attached_files 承载用户显式附加的文件内容,没有附加文件时为空。
3.4 规则、记忆与技能
| 区块 | 内容 | 相关工具 |
|---|---|---|
<rules> | 用户自定义的编码规范、项目规则、可参考的上下文 | fetch_rules |
<memories> | 跨会话持久化的记忆条目、记忆管理规则和引用格式 | update_memory |
<agent_skills> | 可用技能列表,每个技能带 SKILL.md 路径和描述 | 无专用工具,按需读取 |
<rules> 块在运行时表现为一段说明性文本,提示模型考虑其中可能存在的规则、记忆或上下文。规则内容可以由工具返回,也可能包含非文本内容。fetch_rules 通过规则名称获取对应规则。
<memories> 块定义记忆的创建、更新、删除和引用方式;实际记忆条目通过 update_memory 维护,并可跨会话持久化。
<agent_skills> 的结构如下:
<agent_skills>
When users ask you to perform tasks, check if any of the available skills
below can help complete the task more effectively...

<available_skills>
<agent_skill fullPath="...\create-skill\SKILL.md">...</agent_skill>
<agent_skill fullPath="...\imagegen\SKILL.md">...</agent_skill>
...
</available_skills>
</agent_skills>
上下文只携带技能的路径和描述,完整技能内容存放在对应的 SKILL.md 中,由模型判断是否需要读取。这种组织方式使技能列表保持较小体积,同时保留按需加载完整说明的能力。
3.5 历史层
历史层由两部分组成:
- 历史摘要:以
[Previous conversation summary]标识,内容是早期对话的结构化压缩结果,包含用户意图、技术概念、文件操作、错误修复、待办事项等。 - 最近轮次:最近若干轮完整对话,保留 user 输入、assistant 输出、tool calls 和 tool results。部分工具结果可能已被 Snip 截短。
摘要是早期历史的唯一常驻表示;最近轮次是当前任务的连续性保障。当前轮的用户输入尚未进入历史层,位于消息末尾。
3.6 当前轮
当前轮由 <additional_data> 和 <user_query> 组成:
<additional_data>
...打开文件、最近查看文件、附加文件...
</additional_data>

<user_query>
用户当前输入
</user_query>
<user_query> 是当前轮用户指令的标识。系统提示词要求模型遵循该标签中的用户指令。附加数据只提供状态背景,不构成用户指令。
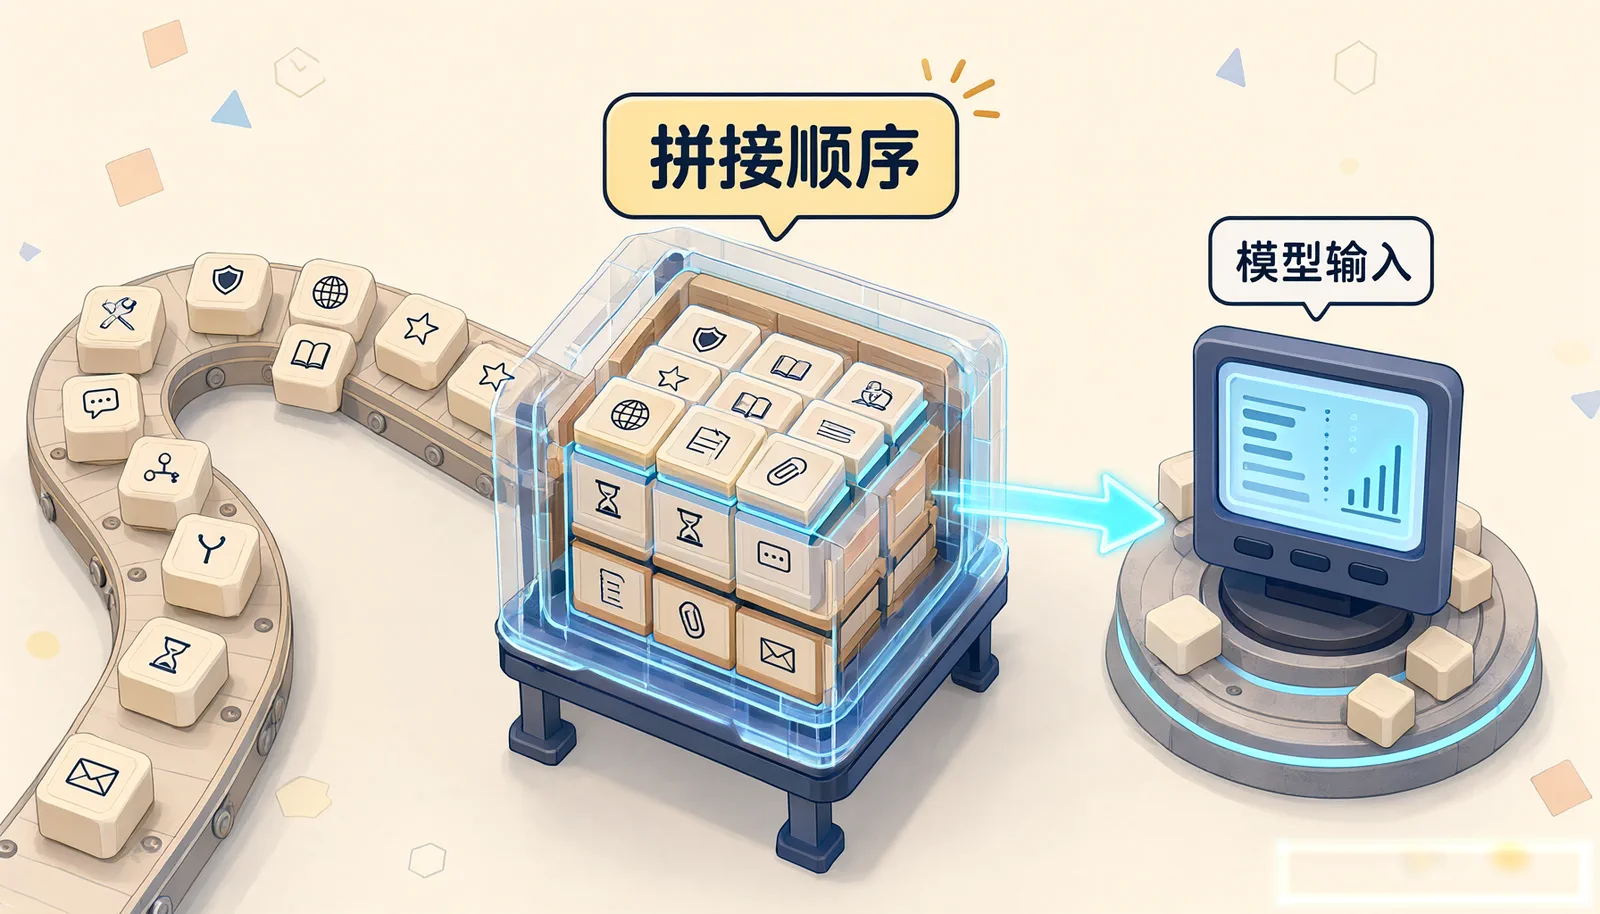
3.7 实际拼接顺序
运行时观察到的文本拼接顺序如下:
| 顺序 | 区块 | 载体 | 说明 |
|---|---|---|---|
| 1 | 系统提示词与行为约束 | messages[0] 文本 | 身份、九个 XML 行为块、工具调用规则 |
| 2 | 工具 Schema | tools 字段和(或)系统提示词中的 <function> 块 | 工具名、描述、参数 JSON Schema |
| 3 | <user_info> | 文本块 | OS、日期、Shell、工作区 |
| 4 | <rules> | 文本块 | 用户规则、项目规则、记忆上下文 |
| 5 | <agent_skills> | 文本块 | 技能路径与描述 |
| 6 | <project_layout> | 文本块 | 工作区目录结构 |
| 7 | <git_status> | 文本块 | 分支、修改、未跟踪文件 |
| 8 | [Previous conversation summary] | 独立 system 消息或历史起始块 | 早期对话摘要 |
| 9 | 最近轮次 | user / assistant / tool 消息 | 最近若干轮完整对话 |
| 10 | <additional_data> | 当前 user 消息的前半部分 | 打开文件、最近查看、附加文件 |
| 11 | <user_query> | 当前 user 消息的后半部分 | 用户当前输入 |
其中第 1 和第 2 项在逻辑上同属系统层;若工具 Schema 通过 tools 字段注入,则它不属于 messages 文本,但仍与 messages 一同发送。第 8 至第 11 项构成模型实际看到的历史与当前输入。
3.8 消息结构
概念上的 messages 结构如下:
messages = [
  system(system_prompt),
  system("[Previous conversation summary] ..."),
  ...recent_turns...,
  user("<additional_data>...</additional_data>\n<user_query>...</user_query>")
]

tools = [ ... ]
各部分的角色:
- 第一条 system 消息承载身份、行为约束和工具调用规则;若采用文本工具通道,还包含
<function>定义。 - 历史摘要通常作为独立的 system 消息(或历史起始块)承载,位置在最近轮次之前。
- 最近轮次保留原始角色顺序,包括 user、assistant 和工具结果消息。
- 当前 user 消息将附加数据与
<user_query>拼接在一起。 tools与 messages 并行发送,不拼接进 messages 文本;文本工具通道则是例外,<function>块属于 system 消息内容。
3.9 各区块 token 量级
以下数值是运行时估算,不是固定配额:
| 区块 | 估算 token | 说明 |
|---|---|---|
| 系统提示词(身份、行为约束、工具规则) | ~1500 | 固定部分 |
| 工具定义(全部工具 Schema) | ~3000 | 静态部分中占比最大 |
| 规则与记忆 | ~100 | 随配置变化 |
| 技能列表 | ~300 | 只含路径与描述 |
| 项目布局 | ~200 | 目录结构 |
| Git 状态 | ~100 | 分支与变更列表 |
| 历史摘要 | ~1500 | 压缩后的早期历史 |
| 最近轮次 | ~2000 | 最近 2–3 轮,随工具结果波动 |
| 用户信息与打开文件 | ~300 | 环境与 IDE 状态 |
| 当前查询 | ~30 | 用户输入 |
| 合计 | ~9000 | 基线量级,实际随内容变化 |
这些数值描述的是空会话或轻量会话的基线。工具结果、代码片段和长文件内容会迅速抬高最近轮次与总 token 数,从而触发压缩。工具 Schema 约 3000 token,是静态部分的最大项;最近轮次约 2000 token,是动态部分的最大项。
4. 上下文压缩
4.1 水位模型
CatPaw 用“token 水位”衡量上下文压力,即已用上下文 token 占模型窗口的比例。模型窗口可能是 128K、200K 或其他规格,具体取决于所用模型。
压缩按水位分级触发:
| 水位 | 动作 | 粒度 | 结果 |
|---|---|---|---|
| ≥ 65% | Snip | 单条工具结果 | 截短过大的工具结果 |
| ≥ 82% | Prune | 最早完整轮次 | 替换为占位符 |
| ≥ 95% | Summarize | 早期对话 | 由独立模型调用生成或更新摘要 |
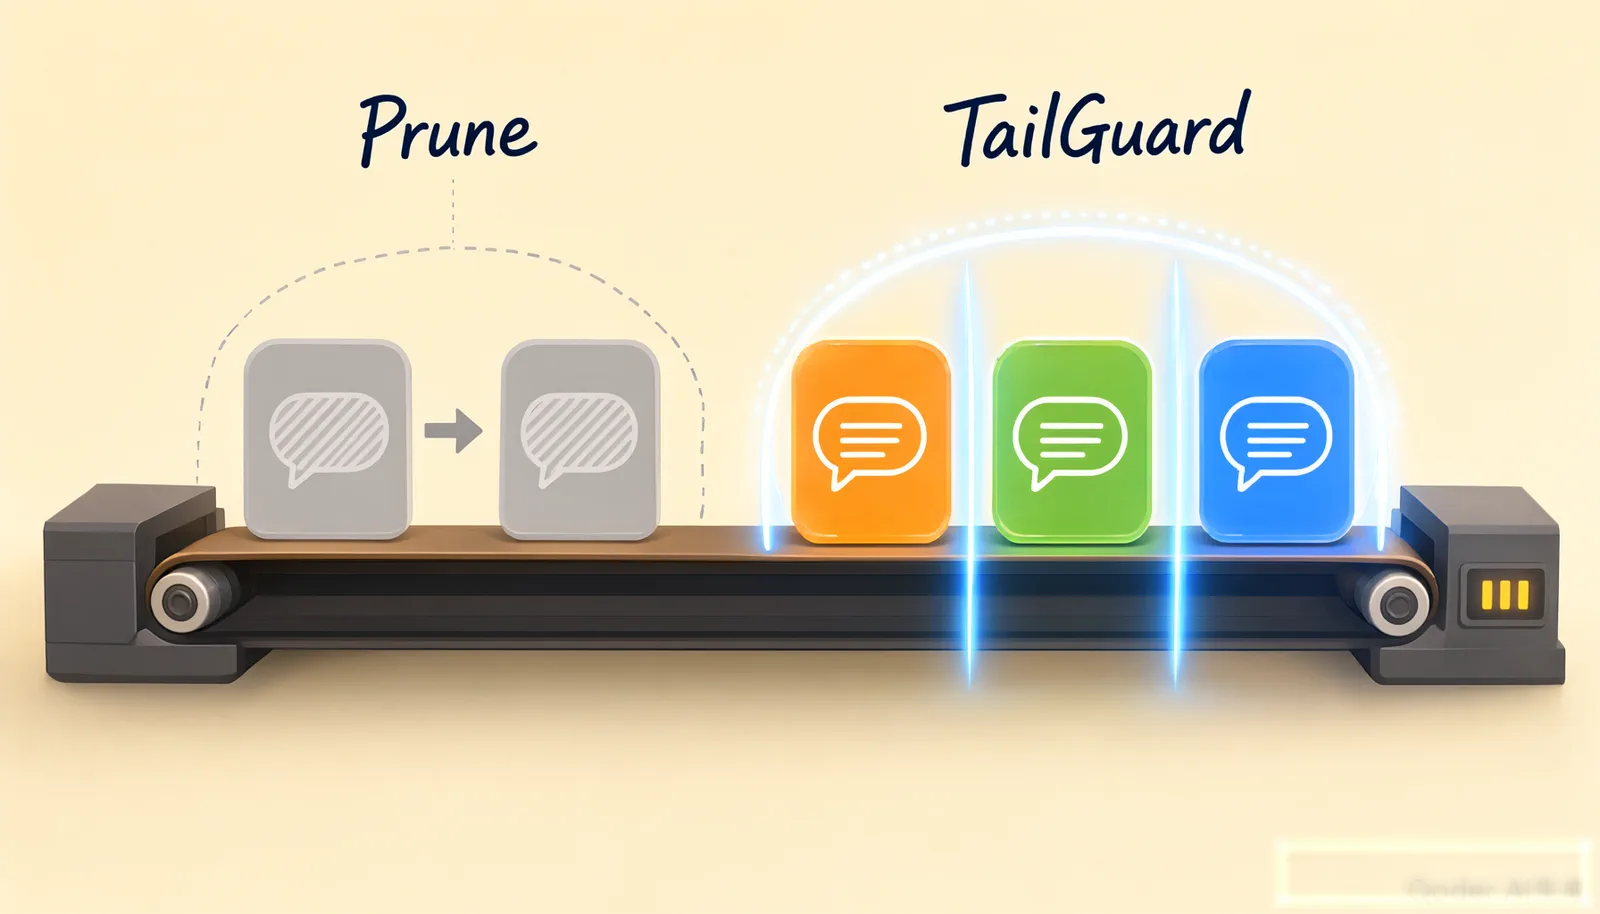
最近的若干轮由 TailGuard 保护,不参与裁剪和摘要。TailGuard 的轮数由 tailGuardTurns 控制,并与 token 水位共同决定最终保留轮数。
压缩是逐级升级的:水位先触发 Snip;若仍继续上升,再触发 Prune;继续上升则触发 Summarize。每次摘要以已有摘要为输入,不会重新摘要全部历史。
4.2 Snip:工具结果截断
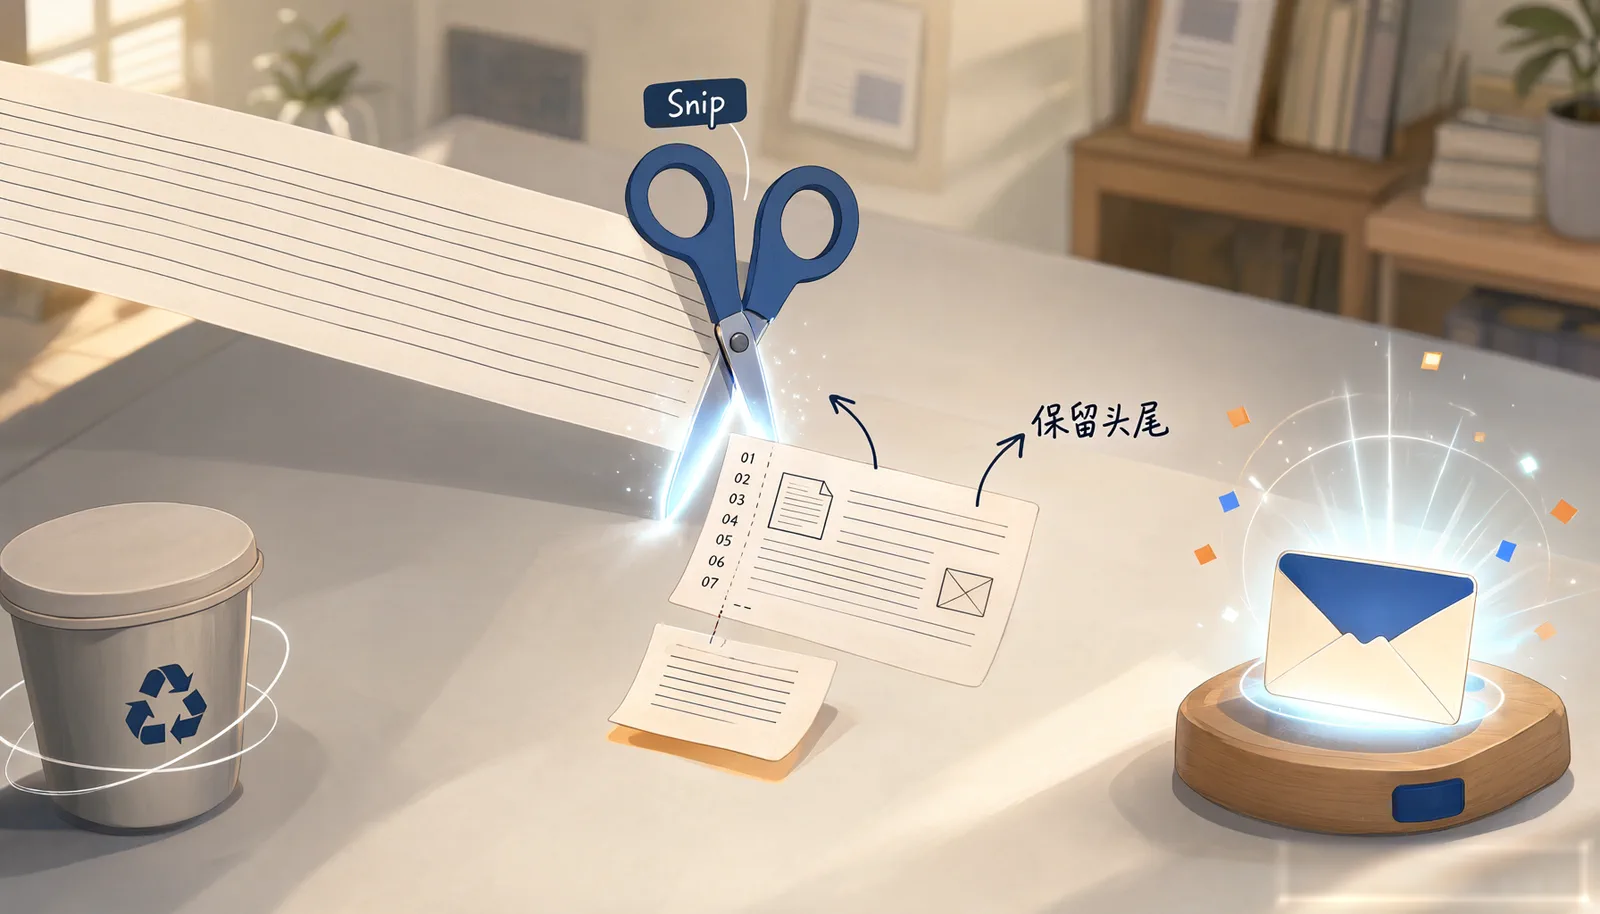
Snip 针对单条体积过大的工具结果,优先处理体积明显超出常规的结果。其处理方式不是简单删除,而是截短或摘要,并保留:
- 结果头部,通常是文件路径、搜索条件或命令信息。
- 结果尾部,保留结尾上下文。
- 行号引用,便于模型定位原文。
- 截断提示,明确告知内容不完整。
运行时观察到的量级示例:
原始工具结果:约 15000 tokens(完整文件内容)
        ↓ Snip
上下文中保留:约 2000 tokens(关键部分 + 行号引用)
截断后的结果中会出现类似提示:
This is a summary. The full content was truncated.Snip 不改变对话轮次数量,只降低单条结果的体积。原始内容仍保留在 transcript 中,模型可以用 read_file 重新读取指定范围,或用 grep 定位片段。
4.3 Prune:历史轮次裁剪
Prune 针对最早的完整对话轮次。当 Snip 后仍然超过阈值时,CatPaw 会从历史中移除最早的轮次,但不是简单删除,而是用占位符替代。占位符保留“此处有历史被裁剪”的标记,使模型知道当前上下文不是完整历史。
裁剪后的典型形态:
[Turn 1] user + assistant + tool_result  → 替换为占位符
[Turn 2] user + assistant + tool_result  → 替换为占位符
[Turn 3] user + assistant + tool_result  → 保留(完整)
[Turn 4] user + assistant + tool_result  → 保留(完整)
[Turn 5] user(当前)                     → 保留(完整)
通常保留最近 2–3 轮完整对话;如果最近轮次包含大量工具结果或长文本,保留轮数会减少到 1–2 轮。TailGuard 保证最近 N 轮不被裁剪,N 的具体取值随会话状态变化。
Prune 只影响发送给模型的上下文,不影响 transcript。被裁剪轮次的原文仍可从 transcript 检索。
4.4 Summarize:对话摘要
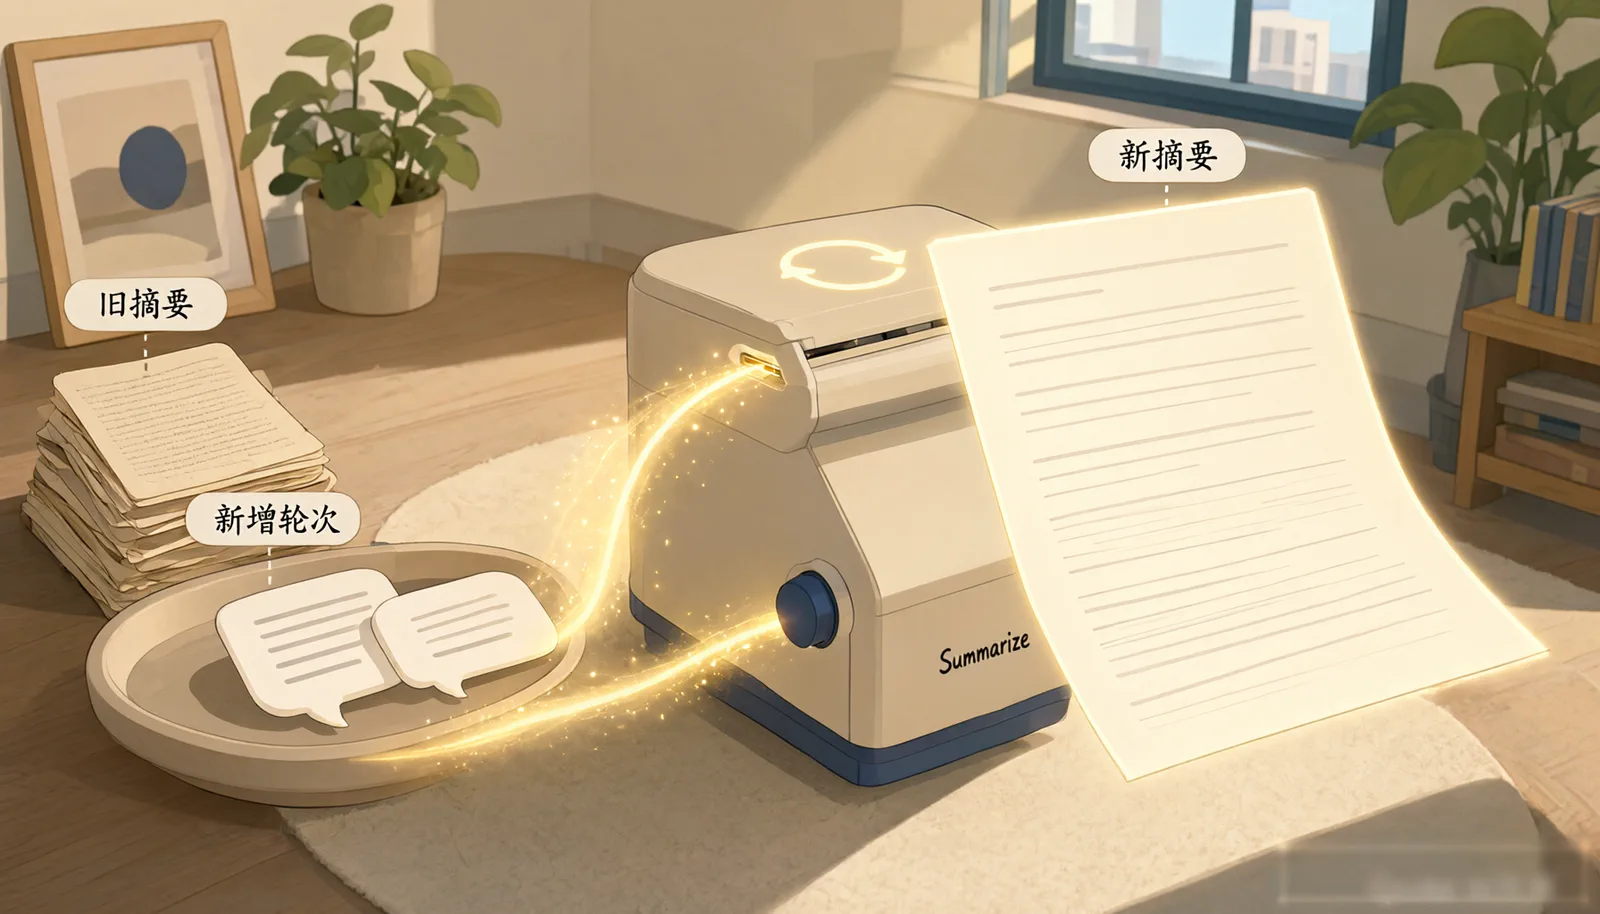
Summarize 由一次独立的模型调用完成,输入包括:
- 被 Prune 移出上下文的早期轮次;这些轮次的原文从 transcript 读取,Prune 只改变请求上下文,不改变日志。
- 之前已经生成的摘要(如果存在)。
输出是一份结构化摘要,替换被移除的原始对话,并作为 [Previous conversation summary] 注入后续请求。摘要通常在几千 token 量级,远小于原始 transcript。
摘要的作用是保留早期对话的语义骨架:用户要什么、涉及哪些技术概念、改过哪些文件、遇到并修复了哪些错误、还有什么未完成。摘要只保留结构化要点和关键片段,完整的原始细节需回查 transcript。
4.5 摘要的九个固定部分
| 序号 | 部分 | 内容 |
|---|---|---|
| 1 | Primary Request and Intent | 用户的核心诉求,逐条列出 |
| 2 | Key Technical Concepts | 涉及的技术栈、架构模式、核心组件 |
| 3 | Files and Code Sections | 操作过的文件、具体修改、关键代码片段 |
| 4 | Errors and fixes | 遇到的编译错误、测试失败及修复方式 |
| 5 | Problem Solving | 解决了什么问题、采用什么方案 |
| 6 | All user messages | 用户的原始消息,逐条保留 |
| 7 | Pending Tasks | 未完成的任务 |
| 8 | Current Work | 当前正在进行的工作 |
| 9 | Transcript location | 原始 transcript 文件路径 |
其中第 6 部分“All user messages”逐条保留早期用户输入,而不仅仅是概括意图;第 3 部分保留文件路径、修改内容和关键代码片段;第 9 部分提供 transcript 路径,使摘要本身成为检索入口。
4.6 增量摘要
摘要不是每次从头生成,而是增量更新:
第 1 次:Turn 1–5 的内容 → Summary v1
第 2 次:Summary v1 + Turn 6–8 的内容 → Summary v2
第 3 次:Summary v2 + Turn 9–11 的内容 → Summary v3
每次摘要的输入由“旧摘要 + 新增被移除轮次”构成,而不是全部历史。这样输入量有界,不会随着对话变长而线性增长。新摘要替代旧摘要,上下文中只保留最新版本。
4.7 压缩后的上下文形态
压缩后的请求大致呈以下形态:
[system prompt]
[Previous conversation summary]
[recent turn N-2: user / assistant / tool results]
[recent turn N-1: user / assistant / tool results]
[recent turn N:   user / assistant / tool results]
[additional_data + current user query]
其中:
- 早期历史只保留摘要。
- 最近轮次保留完整结构,但工具结果可能已被 Snip。
- 被 Prune 的轮次可能只留下占位符。
- 当前用户输入始终保留,不参与裁剪或摘要。
4.8 保留轮数的动态性
保留轮数不是固定配置,而是由每轮内容体积决定:
- 普通文本对话占用较小,可能保留 2–3 轮。
- 最近轮次包含大量工具结果、完整工具定义或长文件内容时,占用迅速上升,可能只保留 1–2 轮。
- TailGuard 提供下限保护,但保护范围本身也受
tailGuardTurns和 token 水位影响。
这解释了一个常见现象:对话已经进行多轮,但模型当前看到的 messages 中只有最近一两轮,甚至只有当前提问;更早的内容已经进入摘要,或以占位符形式存在。
4.9 辅助触发条件
除 token 水位外,运行时还观察到两类辅助触发条件:
- 对话轮数达到一定规模(观察估计约 5–8 轮)时,可能提前启动摘要。
- 用户开启新会话但引用旧会话内容时,旧会话历史可能被摘要后带入。
这两类条件没有固定阈值,属于水位模型之外的补充触发路径。
5. 工具调用
5.1 调用生命周期
assistant 输出工具调用请求(工具名 + 参数)
        ↓
CatPaw 解析工具名与参数
        ↓
CatPaw 在本地执行工具
        ↓
捕获工具结果(文本、错误、元数据)
        ↓
格式化结果;过大时截断或摘要
        ↓
将结果作为工具结果消息回注上下文
        ↓
模型读取结果,继续推理
        ↓
若无工具调用,输出最终回复;否则继续下一轮工具调用
关键点:
- 工具在本地 IDE 和工作区中执行,不是服务端执行。
- 工具调用由模型发起,CatPaw 负责解析、执行和结果回注。
- 一次用户回合内可以发生多轮“模型推理—工具调用—结果回注”,直到模型给出最终回复。
- 工具结果是上下文的一部分,会参与后续的 token 水位计算。
5.2 并行调用
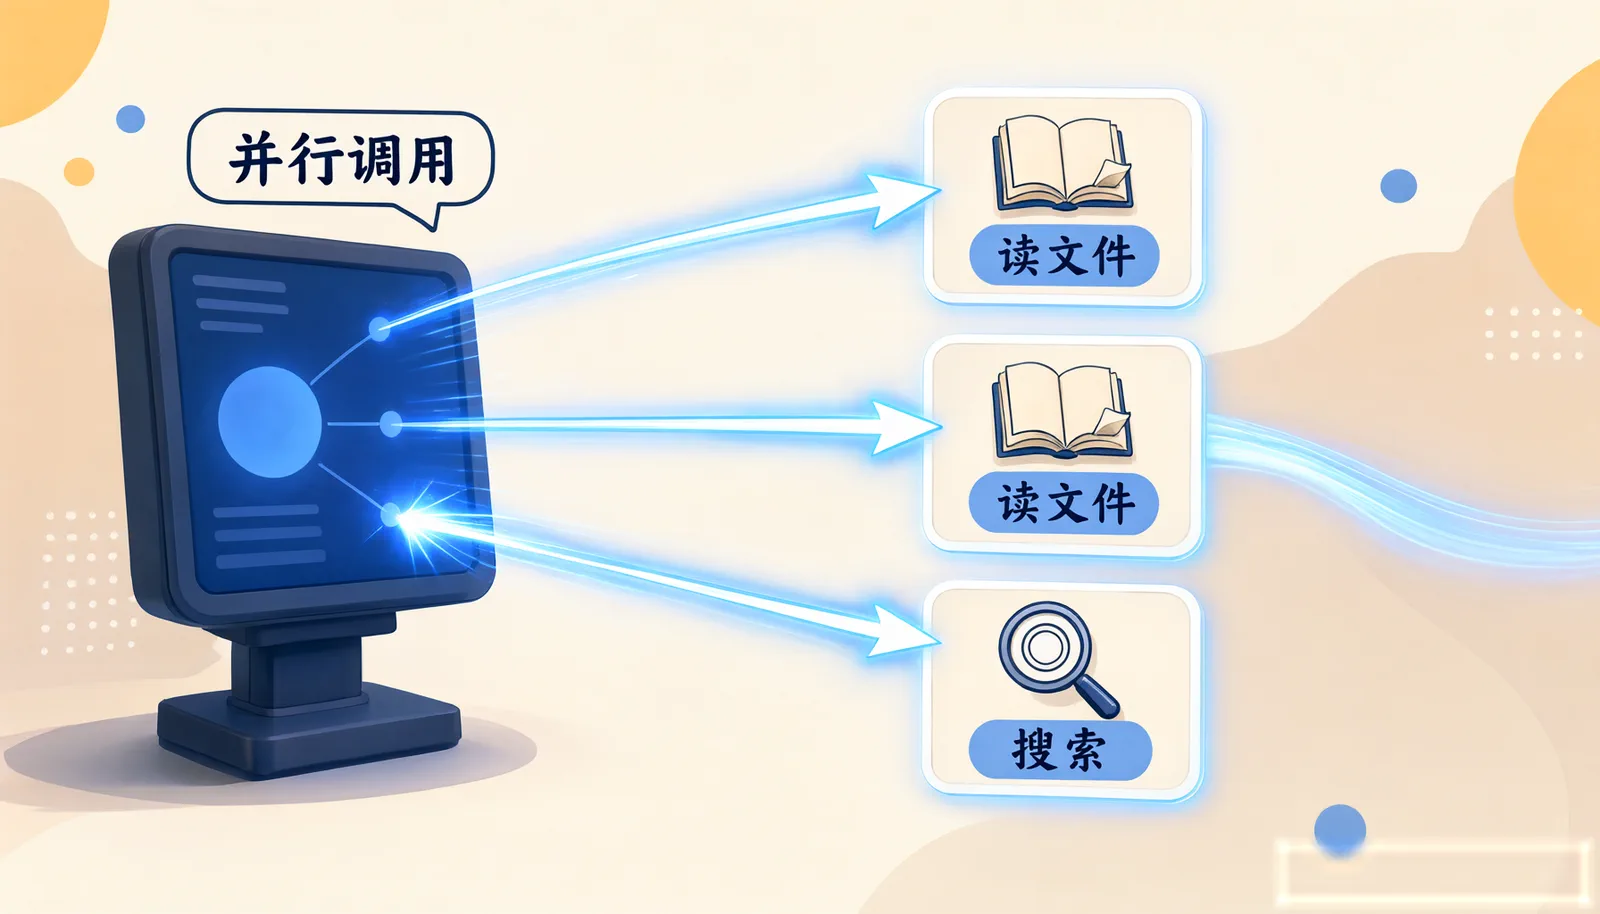
CatPaw 支持在单个回合中并行调用多个工具。模型可以在一条 assistant 消息中同时发起多个无依赖调用,例如:
read_file(A)
read_file(B)
grep(pattern)
CatPaw 并行执行这些调用,收集全部结果,一次性返回给模型。这样可以减少往返轮次,提高多文件读取和多路检索的效率。
有依赖关系的调用不能并行,必须按顺序执行:后一个工具的参数依赖前一个工具的结果时,模型需要等待前一个结果返回后再发起下一个调用。
5.3 结果格式化
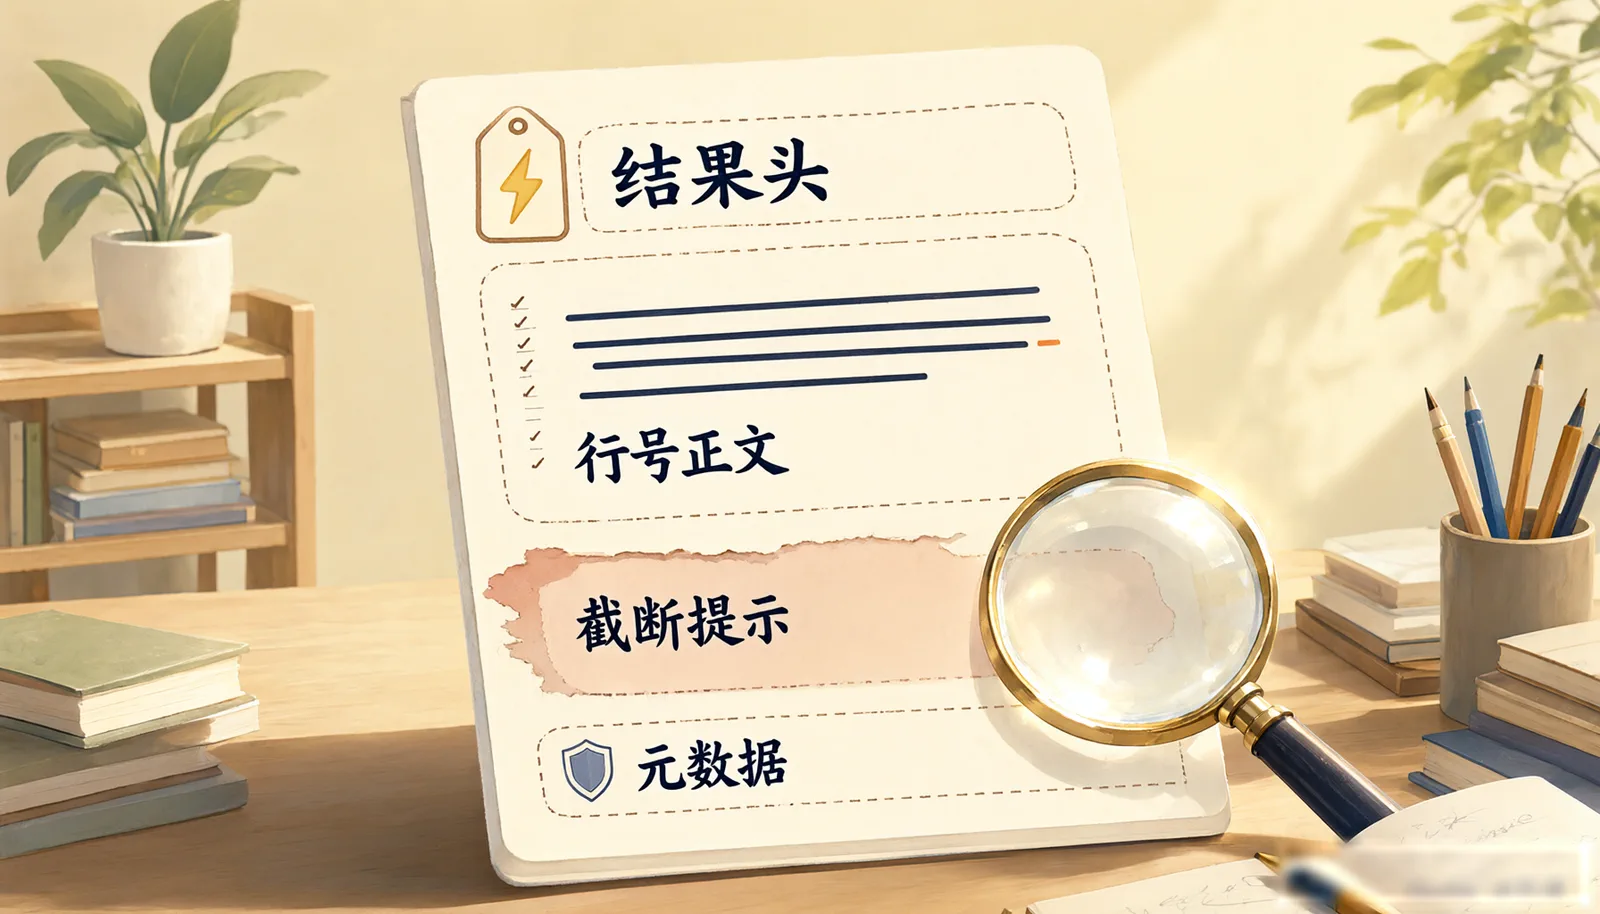
工具结果不是原样塞入上下文,而是经过格式化:
[Tool result] read_file
path: src/main/java/.../ToolOutcome.java
lines: 1-19 of 19
1|package com.example...
2|...
...
典型结构包括:
- 结果头:工具名、文件路径、搜索条件、命令行等。
- 正文:格式化后的内容,代码行使用
LINE_NUMBER|CONTENT形式标注行号。 - 截断提示:结果被截短时,明确说明“这是摘要,完整内容已截断”。
- 元数据:匹配数量、文件大小、总行数等。
行号格式是工具结果格式化的核心约定。它使模型可以在后续编辑工具中精确引用某一行,也便于模型区分文件内容与工具附加的元信息。
5.4 结果大小控制
工具结果的大小控制在两个层级进行:
| 层级 | 机制 | 说明 |
|---|---|---|
| 工具侧 | read_file 的 offset / limit | 默认读取整个文件;超大文件会提示使用分段读取 |
| 工具侧 | grep 的 head_limit、output_mode | 限制返回条数或只返回文件列表、计数 |
| 工具侧 | codebase_search 的结果上限 | 语义搜索结果有数量限制 |
| 工具侧 | 部分工具的分页参数 | 通过 page 等参数分批返回 |
| 上下文侧 | Snip | 水位达到 65% 时截短过大的工具结果 |
| 上下文侧 | 头部 + 尾部 + 行号引用 | 截断时保留关键定位信息 |
| 上下文侧 | transcript 回查 | 被截断的原文仍可通过 read_file / grep 获取 |
工具侧限制用于“一次不要返回太多”,上下文侧 Snip 用于“已经返回的结果不要占太多”。两者配合,避免单条工具结果挤占整个窗口。
5.5 结果回注与再推理
工具结果回注后,模型会看到格式化后的内容,并据此决定下一步:
- 结果完整且足够:继续推理或给出最终回复。
- 结果被截断:用
offset/limit重新读取需要的片段,或从 transcript 中检索。 - 结果不符合预期:调整参数后重试,或改用其他工具。
- 多个并行结果全部返回:模型统一比较后继续。
工具结果是上下文增长的主要来源之一。读取大文件、长命令输出、批量搜索结果都可能迅速抬高 token 水位,因此工具结果既是执行手段,也是压缩机制的主要触发源之一。
5.6 工具调用的持久化
每次工具调用及其结果都会写入 transcript:
[Tool call] read_file
{"target_file": "..."}

[Tool result] read_file
...
这使 transcript 成为工具执行历史的完整记录。摘要生成时可以从 transcript 中提取文件操作、错误修复和关键代码片段;模型需要细节时也可以回查具体调用及其原始结果。
6. 工具体系
6.1 工具定义的两条注入通道
CatPaw 的工具定义通过两条彼此独立的通道进入模型:
| 维度 | tools 字段通道 | <function> 文本通道 |
|---|---|---|
| 位置 | API 请求的独立 tools 字段 | 系统提示词文本 |
| 形态 | 结构化 JSON Schema | <function> 标签包裹的 JSON |
| 解析方式 | 原生 function calling 机制 | 模型阅读文本后按约定解析 |
| 是否占用 messages token | 不占用 messages 文本 | 占用系统提示词 token |
| 内容 | 工具名、描述、参数 Schema | 工具名、描述、参数 Schema |
| 与 messages 的关系 | 并行发送,独立字段 | 属于 messages 内容 |
运行时可见的文本形态为:
<function>{"description": "Reads a file from the local filesystem.", "name": "read_file", "parameters": {"type": "object", "properties": {"target_file": {"type": "string"}}, "required": ["target_file"]}}</function>每个 <function> 标签包含一个完整的工具定义:name 是工具名,description 是用途说明,parameters 是 JSON Schema。内置工具和 MCP 工具都采用这一形态。
两条通道不是互斥的。它们分别对应结构化 function calling 与文本解析两种工具消费方式;机制上两条通道独立,具体请求可能使用其中一条或同时使用两条。
<tool_calling> 块与工具 Schema 的分工明确:前者是行为规则,后者是结构定义。行为规则告诉模型“如何调用、何时调用、失败怎么办”,Schema 告诉模型“有哪些工具、参数是什么、哪些必填”。
6.2 内置工具清单
CatPaw 内置工具共 16 个,按用途分为三组。
6.2.1 代码检索与读取
| 工具 | 作用 | 关键参数 |
|---|---|---|
codebase_search | 语义搜索代码库,按含义而非精确文本查找代码 | query、target_directories |
read_file | 读取本地文件内容,支持分段 | target_file、offset、limit |
list_dir | 列出目录内容,支持忽略模式 | target_directory、ignore_globs |
glob_file_search | 按 glob 模式搜索文件 | glob_pattern、target_directory |
grep | 基于 ripgrep 的正则搜索 | pattern、path、output_mode、glob、type、head_limit |
6.2.2 文件编辑与执行
| 工具 | 作用 | 关键参数 |
|---|---|---|
string_replace | 精确字符串替换,支持全部替换 | file_path、old_string、new_string、replace_all |
write | 写入文件,覆盖已有内容 | file_path、contents |
MultiEdit | 对同一文件执行批量编辑,原子操作 | file_path、edits |
delete_file | 删除文件,失败时优雅降级 | target_file、explanation |
run_terminal_cmd | 在终端执行命令,支持后台运行 | command、is_background |
read_lints | 读取工作区的 linter 错误 | paths |
6.2.3 会话、记忆与外部能力
| 工具 | 作用 | 关键参数 |
|---|---|---|
todo_write | 创建和管理结构化任务列表 | todos、merge |
update_memory | 创建、更新或删除持久化记忆 | action、existing_knowledge_id、knowledge_to_store、title |
fetch_rules | 按名称获取用户规则 | rule_names |
AskQuestion | 向用户收集结构化多选答案 | questions、title |
web_fetch | 抓取 URL 内容并转为 Markdown | urls |
完整入参见附录 A。
6.3 工具 Schema 的文本形态
系统提示词中的工具定义采用紧凑的 XML + JSON 形式:
<function>{"description": "Reads a file from the local filesystem.", "name": "read_file", "parameters": {"type": "object", "properties": {"target_file": {"type": "string"}, "offset": {"type": "integer"}, "limit": {"type": "integer"}}, "required": ["target_file"]}}</function>特点:
- 一个
<function>标签对应一个工具。 - 标签内部是合法 JSON 对象。
parameters使用 JSON Schema 描述参数类型、必填项和嵌套结构。- 工具 Schema 是静态的,不随对话轮次变化;工具结果是动态的,随每次调用变化。
- MCP 工具与内置工具使用同一种文本形态,只是工具名带服务器前缀。
6.4 MCP 工具
MCP(Model Context Protocol)工具从外部服务接入,与内置工具一起注入模型。工具名带有服务器前缀,形成命名空间:
mcp_tool_<服务器名>_<工具名>运行时可见两类 MCP 工具:
| 工具前缀 | 作用 |
|---|---|
mcp_tool_BrowserUse-BrowserTab_browser_action | 浏览器自动化:导航、截图、点击、填表等 |
mcp_tool_reader-mcp-server_reader_* | 小说/漫画搜索、章节目录、正文获取、书籍信息、批量下载 |
mcp_tool_BrowserUse-BrowserTab_browser_action 只接收一个 command 参数,值为 JSON 命令字符串,由该工具解析后执行具体浏览器动作。
reader 系列包含 9 个工具,覆盖按关键词搜索、按作者搜索、列出书源、获取章节目录、获取章节正文、获取书籍详情、批量下载等能力。完整列表见附录 B。
MCP 工具的调用生命周期与内置工具一致:模型发起调用,CatPaw 解析并转发到对应 MCP 服务,结果格式化后回注上下文。MCP 工具的定义同样出现在工具 Schema 中,不会在调用时才暴露给模型。
6.5 工具定义与行为规则的分工
| 内容 | 载体 | 作用 |
|---|---|---|
| 工具行为规则 | 系统提示词 <tool_calling> 块 | 约束模型如何调用工具、失败如何处理、何时并行 |
| 工具 Schema | tools 字段和(或)<function> 文本块 | 定义工具名、描述、参数结构和必填项 |
| 工具结果 | 工具结果消息 | 承载执行输出、错误和元数据 |
| 工具清单 | 工具 Schema 的集合 | 告诉模型当前有哪些工具可用 |
这种分工使工具的结构定义与行为约束位于不同载体,可以分别维护:新增工具只改 Schema,调整调用策略只改 <tool_calling>,两者互不覆盖。
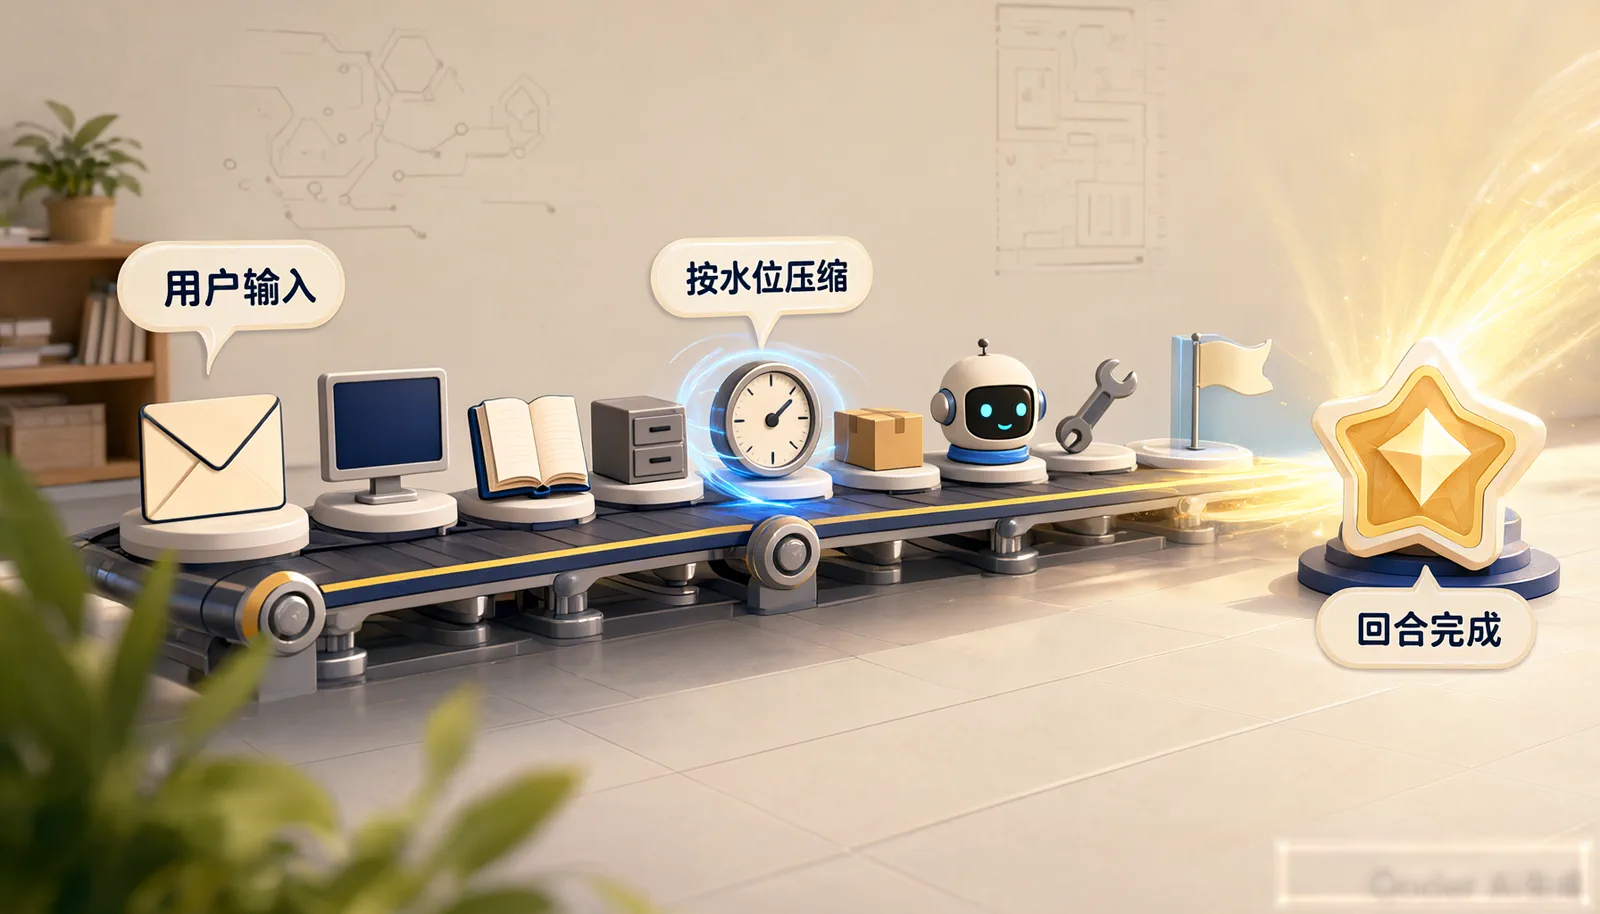
7. 完整回合的数据流
7.1 阶段划分
| 阶段 | 动作 | 产出 |
|---|---|---|
| 1 | 接收用户输入与附加文件 | 当前查询、<additional_data> |
| 2 | 采集环境状态 | <user_info>、<project_layout>、<git_status>、打开文件列表 |
| 3 | 加载规则、记忆、技能 | <rules>、<memories>、<agent_skills> |
| 4 | 装载历史 | transcript、历史摘要、最近轮次 |
| 5 | 评估 token 水位并压缩 | Snip / Prune / Summarize 后的上下文 |
| 6 | 组装请求 | messages + tools |
| 7 | 模型推理 | 文本回复或工具调用 |
| 8 | 执行工具并回注 | 工具结果,回到阶段 7 |
| 9 | 结束回合 | 最终回复、transcript 追加、摘要更新 |
7.2 状态变化
| 状态 | 变化方式 |
|---|---|
| transcript | 持续追加 user、assistant、tool call、tool result,不因压缩而删除 |
| 历史摘要 | 每次 Summarize 生成新版本,替代旧摘要 |
| 最近轮次窗口 | 随新轮次加入而前移,旧轮次被 Prune 或摘要 |
| token 水位 | 随工具结果和对话增长上升,压缩后下降 |
| 工具 Schema | 静态,不随轮次变化 |
| 环境块 | 每轮重新采集,反映最新状态 |
8. 机制特征
- 全量日志与有损上下文分离。 transcript 保留全部事实,发送给模型的上下文只保留摘要和最近轮次;两者通过 transcript 路径和检索工具连接。
- 压缩分级、逐级升级。 Snip 处理单条结果,Prune 处理整轮历史,Summarize 处理早期语义;不同粒度对应不同水位。
- 尾部保护与动态窗口。 TailGuard 保护最近轮次,保留数量由
tailGuardTurns和 token 水位共同决定,不固定为某个常数。 - 摘要增量更新、模板固定。 摘要由九个固定部分组成,每次以“旧摘要 + 新增被移除轮次”为输入,避免全量重算。
- 摘要与原始日志双轨。 摘要提供常驻语义骨架,transcript 提供可检索的完整细节;模型默认不读整个 transcript。
- 工具结果先格式化再入上下文。 结果带头部、行号、元数据和截断提示,既便于模型引用,也便于压缩。
- 工具定义与行为规则分离。 Schema 负责“有什么工具、参数是什么”,
<tool_calling>负责“如何调用”,两条通道独立。 - 并行工具调用。 无依赖的多个工具在同一回合并行执行,结果一次性回注,减少往返轮次。
- 环境状态每轮刷新。 工作区、Git、打开文件等状态不缓存为固定提示词,而是随每轮请求重新生成。
9. 观察边界
- 文中的 token 数值是运行时估算,用于描述量级,不是固定配额;实际值随模型、内容长度和工具结果变化。
- 65%、82%、95% 是观察到的水位阈值,具体取值可能随模型窗口和版本调整;它们描述的是分级触发关系,不是公开配置常量。
- TailGuard 的轮数、最近轮次的保留数量是动态的,文中“2–3 轮”是常见范围,不是固定值。
- 摘要的九个部分名称和顺序是运行时可见的固定模板;生成摘要所用的完整提示词未在上下文中暴露。
- 工具 Schema 存在
tools字段和<function>文本两条通道;具体一次请求使用哪条通道,取决于模型接口和工具解析方式。 - 16 个内置工具和 MCP 工具列表是分析运行时可见的工具集合;MCP 服务器及其工具随环境配置变化。
- 部分工具参数在观察记录中标注为
string,但语义上是布尔开关或整数(如case_insensitive、multiline、context_lines)。附录按语义类型标注,并在必要时保留观察到的类型差异。
附录 A:内置工具入参
下表顶层参数的必填性来自观察记录;嵌套对象字段的必填性按对象结构推定,未单独观察。
A.1 codebase_search
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
query | string | 是 | 完整的问题描述 |
target_directories | array[string] | 是 | 搜索范围目录 |
explanation | string | 否 | 使用该工具的原因 |
search_only_prs | boolean | 否 | 是否只搜索 PR |
A.2 read_file
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
target_file | string | 是 | 文件路径 |
offset | integer | 否 | 起始行号 |
limit | integer | 否 | 读取行数 |
A.3 run_terminal_cmd
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
command | string | 是 | 终端命令 |
is_background | boolean | 是 | 是否后台运行 |
explanation | string | 否 | 原因说明 |
A.4 list_dir
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
target_directory | string | 是 | 目录路径 |
ignore_globs | array[string] | 否 | 忽略的 glob 模式 |
A.5 delete_file
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
target_file | string | 是 | 文件路径 |
explanation | string | 否 | 原因说明 |
A.6 fetch_rules
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
rule_names | array[string] | 是 | 规则名称列表 |
A.7 string_replace
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
file_path | string | 是 | 文件路径 |
old_string | string | 是 | 要替换的文本 |
new_string | string | 是 | 替换后的文本 |
replace_all | boolean | 否 | 是否全部替换 |
instructions | string | 否 | 编辑说明 |
A.8 write
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
file_path | string | 是 | 文件路径 |
contents | string | 是 | 文件内容 |
A.9 MultiEdit
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
file_path | string | 是 | 文件绝对路径 |
edits | array[object] | 是 | 编辑操作数组 |
edits[].old_string | string | 是 | 要替换的文本 |
edits[].new_string | string | 是 | 替换后的文本 |
edits[].replace_all | boolean | 否 | 是否全部替换 |
MultiEdit 对同一文件的多个编辑作为原子操作执行。
A.10 update_memory
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
action | string | 否 | create / update / delete |
existing_knowledge_id | string | 否 | 更新或删除时指定的记忆 ID |
knowledge_to_store | string | 否 | 记忆内容 |
title | string | 否 | 记忆标题 |
A.11 todo_write
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
todos | array[object] | 是 | TODO 项数组 |
todos[].content | string | 是 | 任务内容 |
todos[].id | string | 是 | 任务 ID |
todos[].status | string | 是 | pending / in_progress / completed / cancelled |
merge | boolean | 是 | 是否与现有列表合并 |
A.12 glob_file_search
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
glob_pattern | string | 是 | glob 模式 |
target_directory | string | 否 | 搜索目录 |
A.13 grep
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
pattern | string | 是 | 正则表达式 |
path | string | 否 | 搜索路径 |
output_mode | string | 否 | content / files_with_matches / count |
glob | string | 否 | 文件过滤 |
type | string | 否 | 文件类型 |
case_insensitive | boolean | 否 | 是否忽略大小写 |
multiline | boolean | 否 | 是否启用多行模式 |
context_lines | integer | 否 | 匹配上下文行数 |
before_lines | integer | 否 | 匹配前行数 |
after_lines | integer | 否 | 匹配后行数 |
head_limit | integer | 否 | 输出条数限制 |
观察记录中,case_insensitive、multiline、context_lines、before_lines、after_lines、head_limit 的类型标注为 string;上表按语义类型标注。
A.14 read_lints
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
paths | array[string] | 否 | 文件或目录路径 |
A.15 web_fetch
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
urls | array[string] | 是 | URL 数组 |
A.16 AskQuestion
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
questions | array[object] | 是 | 问题数组 |
questions[].id | string | 是 | 问题 ID |
questions[].prompt | string | 是 | 问题文本 |
questions[].options | array[object] | 是 | 选项数组 |
questions[].options[].id | string | 是 | 选项 ID |
questions[].options[].label | string | 是 | 选项显示文本 |
questions[].allow_multiple | boolean | 否 | 是否允许多选 |
title | string | 否 | 表单标题 |
附录 B:MCP 工具
B.1 BrowserUse-BrowserTab
| 工具 | 参数 | 必填 | 说明 |
|---|---|---|---|
mcp_tool_BrowserUse-BrowserTab_browser_action | command | 是 | JSON 命令字符串;支持导航、截图、点击、填表等浏览器动作 |
B.2 reader-mcp-server
| 工具 | 关键参数 | 说明 |
|---|---|---|
reader_search_novel | keyword、source、page | 按关键词搜索小说 |
reader_search_comic | keyword、source、page | 按关键词搜索漫画 |
reader_search_novel_by_author | author | 按作者搜索小说 |
reader_search_comic_by_author | author | 按作者搜索漫画 |
reader_list_sources | type | 列出可用书源 |
reader_chapters | source、bookUrl | 获取书籍章节目录 |
reader_content | source、bookUrl、chapterIndex | 获取指定章节正文 |
reader_book_info | source、bookUrl | 获取书籍详情 |
reader_download | source、bookUrl、start、end | 批量下载章节 |
reader 系列工具名在实际注入时带 mcp_tool_reader-mcp-server_ 前缀,上表为去掉前缀后的工具名。
附录 C:术语表
| 术语 | 含义 |
|---|---|
| Transcript | 每个会话一个的纯文本全量记录,包含用户输入、助手输出、工具调用和工具结果 |
| Prompt Assembly | 将系统提示词、环境块、规则、技能、摘要、最近轮次和当前输入按顺序拼接成 messages 的过程 |
| Token 水位 | 已用上下文 token 占模型窗口的比例,用于决定是否压缩 |
| Snip | 截短单条体积过大的工具结果,保留头部、尾部、行号和截断提示 |
| Prune | 将最早的完整对话轮次替换为占位符,减少历史轮次数量 |
| Summarize | 调用独立模型将早期对话压缩成九段式结构化摘要 |
| TailGuard | 保护最近若干轮不被裁剪或摘要的机制,轮数由 tailGuardTurns 控制 |
| Summary | 早期对话的结构化压缩结果,以 [Previous conversation summary] 注入 |
| Tool Schema | 工具名、描述和参数 JSON Schema 的结构化定义 |
| MCP | Model Context Protocol,用于从外部服务接入工具 |