实盘榜单大改版设计复盘:一条多维查询链路的九个设计决策
榜单需求看着只是查询加排序,真做起来,0 值筛选、默认榜与自定义榜、缓存、我的排名,每一处都可能变成客诉。这篇复盘一次实盘榜单大改版,拆开一条查询链路上的九个设计决策。
本篇你能学到
- 用 0 值置换处理「不限」这类筛选协议
- 判断哪些榜单该走缓存、哪些必须实时查库
- 把「我的排名」穷举成四种状态再写判定
- 用分界线思维规划多维榜单的表结构与扩展方式
- 一次榜单改版从数据到接口的完整推演顺序
一、为什么改:先用数据说服人
1. 榜单现状:点击集中在两三个榜
我们运营的实盘榜单日均 UV 千级、PV 数千,人均浏览约 7 次,用户群体较为稳定。近 30 日各维度榜单的点击分布:
- 短线榜点击量最多(约三成);
- 长线榜次之(约两成);
- 收益榜中年榜点击率最高,其次是月榜。
用户偏好上有个有意思的分裂:持股时长方面,用户更关注短期选股能力;账户收益率方面,用户更注重长期盈利能力。短线榜和收益年榜正好对应这两类诉求。
而「我的实盘」卡片(用户自己排名的卡片)日均点击 UV 仅两位数,高手在这个体系里的存在感很弱。数据摆在这里,改版不是拍脑袋,是现有结构和用户诉求已经错位。
2. 三个视角的问题
| 视角 | 问题 |
|---|---|
| 普通用户 | 榜单多年未更新,无法满足选高手的诉求 |
| 高手 | 上榜体验不足,缺乏获得感 |
| 榜单本身 | 视觉交互体验不佳,吸引力不足 |
普通用户嫌榜单旧,高手嫌没有获得感,榜单本身视觉交互也跟不上。三个视角指向同一个结论:榜单需要从一张收益排行,扩成一套多维高手发现体系。
3. 改造方向:加榜单、加维度、加人数
- 榜单优化:优化收益榜、短线榜、长线榜规则,去掉稳健榜和常胜榜;结合业务场景新增品类高手榜(ETF、港股通等);尝试单一赛道高手榜(黄金、ETF、金融等);
- 增加维度:所有榜单增加资产量级维度(≥1 万 / ≥10 万 / ≥100 万),提升高手可信度与影响力;
- 增加上榜人数:榜单数量从个位数扩至数十个,上榜高手从数百人扩至数千人。
4. 需求目标:定性、定量、具体项
- 定性:基于账户收益、市场热点、交易品种、操作风格挖掘高手,打造多维榜单,提升高手曝光度与形象丰富度;
- 定量:提高 PV / UV,做大粉丝量,进而提高跟投量;
- 具体:① 增加榜单维度(新增重仓赛道、品类榜单);② 增加筛选维度(多维筛选精准匹配);③ 增加标签露出(含组合异动标签);④ 优化高手体验(勋章体系、上榜自动提醒)。
预期结果是榜单从个位数扩到数十个,覆盖人群从数百扩到数千。同时把「我的实盘」从两位数 UV 的边角入口,变成高手运营的抓手。方向清楚了,接下来要回答接口和表怎么接。
二、接口与数据模型:三层表结构
1. 三个接口各管一段
改造涉及三个接口:
| 接口 | 说明 |
|---|---|
/option/feature/V1/queryRankTitleList | 查询榜单标题列表 |
/option/feature/V1/queryRankFilterItem | 查询榜单筛选项 |
/option/feature/V1/queryRankList | 查询榜单高手列表 |
三个接口按页面结构切开:标题列表决定导航,筛选项决定可选项,榜单列表才是真正的数据查询。其中 queryRankList 承担查询压力,另外两个只提供导航与筛选项,前端分三步拿数据,后端也就能分三段做缓存和降级。
2. 数据模型按三层组织
数据模型按三层组织:
| 分类 | 表名 | 说明 |
|---|---|---|
| 榜单配置类 | t_feature_rank_info | 特色榜单信息表 |
| 榜单配置类 | t_feature_filter_index | 特色榜单关联指标配置表 |
| 榜单配置类 | t_feature_rank_index_rel | 特色榜单默认配置表 |
| 用户数据类 | t_feature_user_rank_days | 用户在榜天数记录表 |
| 用户数据类 | t_feature_user_yield_info | 特色榜单高手收益指标详情表 |
| 用户数据类 | subscription | 用户订阅组合关系表 |
| 用户数据类 | group_info | 持仓组合详情表 |
| 展示辅助类 | t_group_movement_info | 组合异动信息表 |
| 展示辅助类 | t_group_label_config | 标签配置表 |
| 展示辅助类 | t_group_label_info | 标签详情表 |
这个三层划分对应三个问题:榜单怎么定义、谁在榜成绩如何、榜单上有哪些氛围信息。按这个分层规划表结构,后续扩展品类榜、赛道榜时只需要加配置数据,不用动表。
3. 为什么不是一张大表
如果把榜单定义、用户成绩、标签异动都塞进一张表,加一个榜单维度就要加列,加一个标签就要改表结构,字段很快失控。拆成配置类、用户数据类、展示辅助类之后,每类表只回答一个问题,改动也只落在一类表上。
预期结果是新增一个 ETF 榜或黄金赛道榜,只需要往 t_feature_rank_info 插入配置,再补对应的指标关联,不需要发版改表。表结构稳住了,九个查询决策才有地方落。
三、查询链路:九个设计决策
1. 入口三步:校验、0 值置换、品类过滤
参数校验是常规动作,检查榜单类型、收益区间、资产量级、筛选项、分页参数、用户身份参数。
接着是筛选项 0 值置换。筛选项中 0 代表不限,查询前需要把 0 置换为不参与筛选。
这是个前后端筛选协议的经典坑:下拉框第一项往往是不限,取值恰好是 0。查询侧若不做置换,0 会被当成真实筛选值参与条件判断,直接查不出数据。凡是筛选项含 0 值约定的接口,查询前都要做这一步。
ETF 榜单有固定筛选条件,需追加 ETF 相关过滤逻辑:ETF 持仓市值占比、ETF 持仓金额、ETF 品类收益区间。
设计原则是通用过滤加品类专属过滤的组合。品类榜的特殊逻辑按榜单类型独立判断追加,不混进主流程,否则主流程会随品类榜数量线性膨胀,越写越难维护。
2. 中段三步:默认榜、总数、缓存
排名(名次、收益率)仅在默认榜单显示;用户自定义筛选后的榜单不展示原榜单排名。
这条乍看奇怪,实则是客诉规避:用户自定义筛选得到的第一名,并不是官方榜单的第一名。如果继续展示第 1 名,歧义和客诉就来了。「默认榜显示排名、自定义榜不显示」是最省事的规避设计。
接下来先统计当前筛选条件下满足要求的高手总数,再限制最大返回数量,避免一次查询过多数据。多维筛选组合下满足条件的人可能非常多,不先 count、不限流,大分页深翻页会直接拖垮查询。
查数据时,有缓存读缓存,无缓存读库;默认榜单均有缓存,访问频率高、数据稳定,适合优先使用。
缓存分流的边界同样清晰:默认榜走缓存,自定义筛选走库。反过来想给自定义筛选加缓存,会被筛选组合的笛卡尔积打爆。
3. 出口三步:组装、个性化填充、个人排名
榜单列表的核心字段:
| 字段 | 说明 |
|---|---|
rankNum | 排名 |
yieldRate | 收益率 |
userId | 用户 ID |
groupId | 组合 ID |
groupName | 组合名称 |
movementContent | 组合异动内容 |
movementHref | 组合异动跳转链接 |
movementType | 组合异动类型 |
onRankDays | 在榜天数 |
在核心字段之外补充个性化展示信息:标签、头像、关注状态、组合名称、收益率、在榜天数、组合异动。
注意这一步与核心字段的分层:核心字段对所有用户一致,可以缓存;个性化字段因人而异,必须实时查。分层之后缓存边界天然清晰,缓存里放的是榜单本身,用户相关的信息永远新鲜。
填充昵称、头像之后,就是整条链路里最有意思的部分:用户排名状态判断,下一节单独展开。
4. 九步串起来看
把九个设计决策串起来,完整链路如下:
接口入参
  ↓
参数校验
  ↓
筛选项 0 值置换
  ↓
判断是否 ETF 榜单(品类榜追加过滤)
  ↓
判断是否默认榜单(决定是否展示排名)
  ↓
查询当前条件下高手总数
  ↓
限制最大返回数
  ↓
查询榜单数据
  ├─ 有缓存:读缓存
  └─ 无缓存:读库
  ↓
组装 result 数据
  ├─ rankNum / yieldRate
  ├─ userId / groupId / groupName
  ├─ movementContent / movementHref / movementType
  └─ onRankDays
  ↓
填充标签、头像、关注状态(个性化信息,不进缓存)
  ↓
填充用户个人信息(昵称、头像 + 排名状态机判定)
  ↓
返回榜单列表
配图
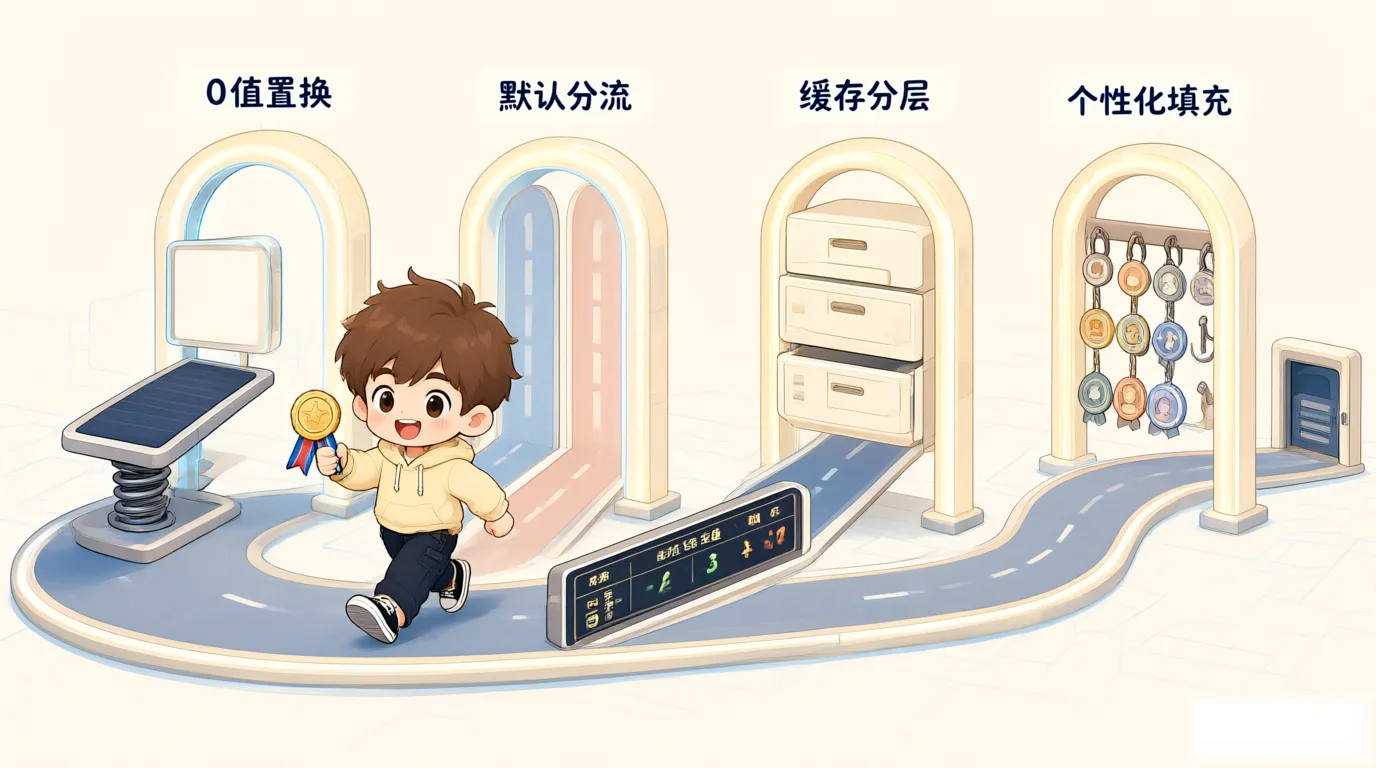
图 1:九步链路的四条分界线,0 值置换、默认分流、缓存分层、个性化填充
顺着这条链路看,每一步只解决一类问题:入口管协议和数据正确性,中段管数据量与缓存,出口管展示分层,最后一步才碰个人状态。九步走完,rankNum 是否为空、哪些字段来自缓存,都已经有明确答案。
四、我的排名:四种状态与判定优先级
1. 先穷举,再写判定
榜单页有「我的实盘」卡片,要展示当前用户自己的排名状态。如果直接在代码里堆 if/else,判定逻辑会散成一地鸡毛。正确做法是先把状态穷举出来:
| # | 判定条件 | 状态 | 展示规则 |
|---|---|---|---|
| 1 | 用户在当前页或完整 TOP100 榜单中 | RANKED_TOP_100 | 显示收益率;仅默认榜单显示排名 |
| 2 | 用户不在 TOP100,但收益表有记录 | RANKED_BELOW_100 | 仅显示收益率,不显示排名 |
| 3 | 收益表无记录,且(无记录或 userLevel = "1") | NOT_PUBLIC_REAL_ACCOUNT | 未公开实盘 |
| 4 | 收益表无记录,userLevel = "2",资产 ≥ 10,000 | RANKED_BELOW_100 | 同情况 2 |
| 5 | 收益表无记录,userLevel = "2",资产 < 10,000 | ASSET_INSUFFICIENT | 资产不足以上榜 |
判定优先级即表格行序:先看是否在 TOP100,再看收益表有无记录,无记录时按 userLevel 与资产兜底判定。顺序不能换,否则会把「资产不足」误判成「未公开实盘」。
配图
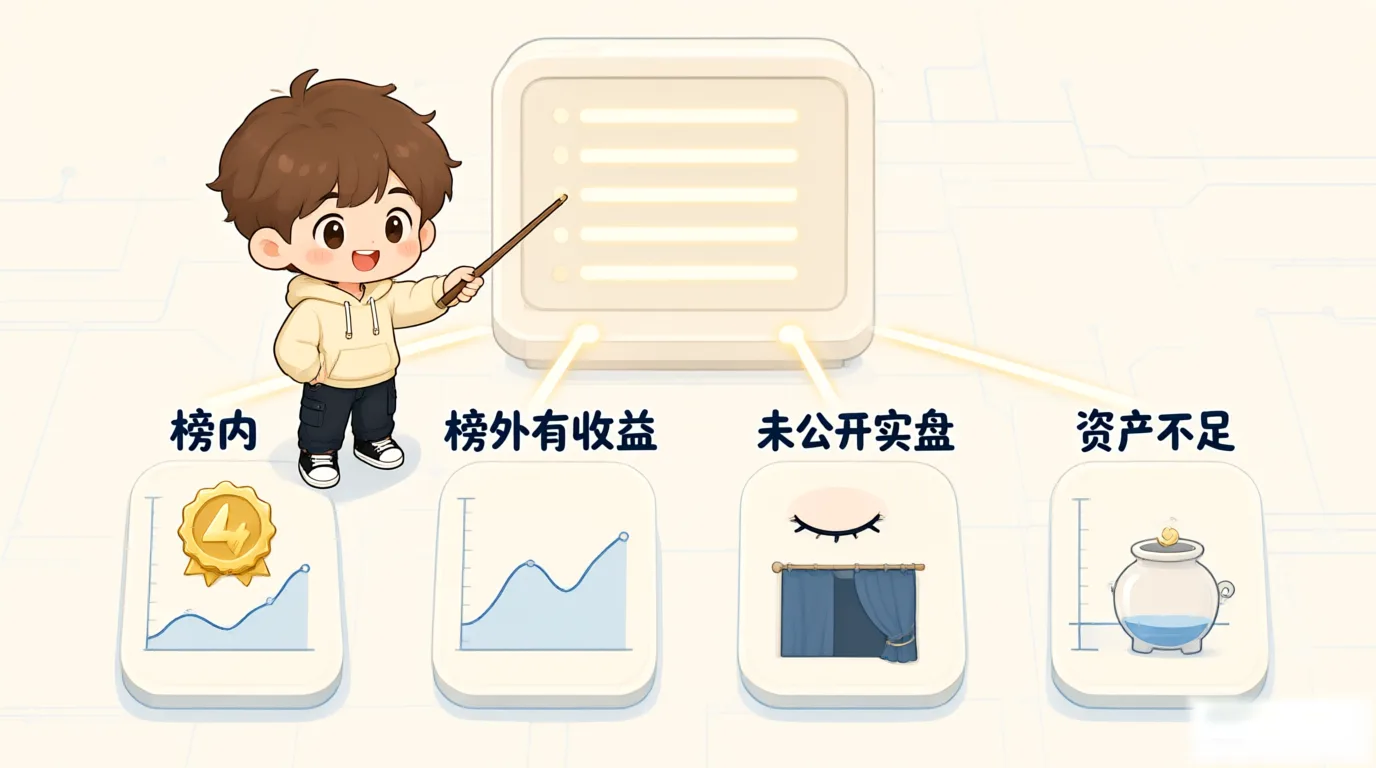
图 2:我的排名四状态,榜内、榜外有收益、未公开实盘、资产不足
2. 四种状态对应四种文案
四种状态对应四种前端展示与引导文案:在榜的显示排名,榜外有成绩的显示收益率,未公开实盘的引导用户公开,资产不足的提示上榜门槛。
先穷举状态、再写判定逻辑,后端只返回状态码、前端按状态渲染。这比在接口里拼好所有展示文案灵活得多,新增状态时也只需要加一行配置,而不是改一串嵌套 if。
3. 为什么值得单独做状态机
把一个卡片的状态拆成四种,看起来是多写了枚举,实际是把未来的分支提前收口。新增一种状态,只需补一个枚举和一段文案,判定顺序不动,老状态的展示也不受影响。
预期结果是后端返回稳定的状态码,前端按状态渲染。联调时不需要逐条对文案,测试也能按状态穷举用例,RANKED_BELOW_100 同时覆盖「榜外有成绩」和「有资产但无记录」两种情况。
常见错误与排错
- 现象:筛选项选「不限」后列表为空。原因:
0没有置换,被当成真实筛选值参与过滤。解法:查询前统一把0置换为不参与筛选,并补一条单测覆盖。 - 现象:用户自定义筛选后仍显示「第 1 名」,引来客诉。原因:排名展示没有和默认榜判断绑定。解法:只有默认榜返回
rankNum,自定义榜置空,前端按空值隐藏排名。 - 现象:自定义筛选把数据库打满。原因:给所有榜单都加了缓存,或者没先 count 就放开了分页。解法:自定义榜只走库,先统计总数再限制最大返回数。
- 现象:同一用户看到别人的标签或关注状态。原因:把个性化字段塞进了榜单缓存。解法:核心字段缓存,标签、头像、关注状态实时查。
- 现象:未公开实盘的用户被提示「资产不足」。原因:状态判定顺序反了,先判资产再看
userLevel。解法:严格按表格行序判定,先 TOP100,再收益记录,最后userLevel加资产。
本篇小结
- 0 值置换是筛选协议的数据正确性底线,查询前必须显式处理。
- 默认榜与自定义榜要在排名展示和缓存策略上同时分流,一条分界线解决两个问题。
- 核心字段与个性化字段分层填充,缓存里只放对所有用户一致的内容。
- 「我的排名」先穷举四种状态,再按优先级判定,后端只返回状态码。
- 四条分界线画在 0 值置换、默认与自定义分流、核心与个性化分层、排名状态机上,线画对了,加榜单只是加配置。