智能选品慢接口治理:从动态 SQL 到 ES 宽表
选品页勾满十几个指标,筛一次要等三五秒,高峰期直接超时。这篇文章复盘我们怎么把查询期的 JOIN、JSON 解析和行转列整体前移到写入期,用一张 ES 宽表把同一个接口压到百毫秒级。
本篇你能学到
- 判断一个慢查询该不该从数据库搬到 ES 的三条标准
- 用来源表分组加 VALUE_TYPE 设计 ES 宽表字段类型
- 把动态 SQL 生成器改写成 bool.filter DSL 生成器的完整映射
- 全量初始化、增量同步、对账与降级的落地顺序
- 用 250 交易日热窗口控制索引体量
一、问题现场:一个动态 SQL 撑起的选品页
1. 业务场景:条件完全动态的选品工作台
智能选品是产品评价体系下的选品工作台。用户在页面勾选筛选条件,包括组合类型、各类评分、各周期收益率、上线日期、主理人等,然后按任意指标排序并分页浏览。
这种页面有三个鲜明特点:
- 条件完全动态:指标条件由前端传入,理论上可任意组合,无法枚举优化;
- 指标多源:指标分散在多张业务表中,类型各异,范围值、多选值、字符串、日期都有;
- 读多写少:数据每日跑批计算一次,白天是高并发查询。
这三点决定了优化方向。条件无法枚举,就不能靠预建索引或缓存固定查询;数据每天只变一次,就有条件把计算挪到写入侧。摸清这个边界,后面的方案选型才有依据。
2. 接口与报文:一个 queryPage 承载全部组合
接口路径:/product/review/choose/queryPage。
请求结构(indexList 实际可达 10+ 项,各项结构相同):
queryPage 请求
├─ 分页:pageNo = 1、pageSize = 10
├─ 基础过滤:productCode = "P0001,P0002"(逗号分隔多值)
│             statDate = "2025-09-18"、productStatus = "0"
├─ 指标条件 indexList[]:每项含 indexCode / indexName / valueType,取值字段随 valueType 变化
│   ├─ 组合类型          TB_P_PRODUCT_LEVEL2_TYPE     valueType=1   indexValue="3,0"(多选)
│   ├─ 产品总分          PRODUCT_PRODUCT_SCORE        valueType=2   indexValueSt=10、indexValueEn=50(区间)
│   ├─ 专业能力评分      PRODUCT_PROFESSIONAL_SCORE   valueType=2   indexValueSt=11.5、indexValueEn=50.6
│   ├─ 组合上线日期      TB_P_PORTFOLIO_LAUNCH_DATE   valueType=4   indexValue="2025-09-02,2025-09-28"(日期区间)
│   ├─ 产品来源          TB_P_PRODUCT_SOURCE          valueType=3   indexValue="境内"
│   ├─ 主理人            INVEST_STAFF                 valueType=11  indexValue="STAFF001"
│   └─ 近一年年化收益率  Y1_ANN_CST_PROFIT_RATE       valueType=2   (未传值)
└─ 排序:sort = PRODUCT_PRODUCT_SCORE、sortType = DESC
响应结构(每页 10 条,每条携带 20+ 个指标值):
queryPage 响应
├─ total = 100000
└─ data[]:每条记录包含
    ├─ 基础字段:productCode、productName、productType、statDate、intro、manager、
    │            branchName、productStatus、productSource、riskLabel、label
    └─ indexList[]:每项含 indexCode / indexName / indexValue / indexUnit(可选)
        ├─ 组合类型         → "专家投顾组合"
        ├─ 产品总分         → ""
        ├─ 近一年年化收益率 → 36.52(单位 %)
        └─ 近一年最大回撤   → 23.82(单位 %)
把两段报文放在一起看,前端只传了几十个字段,后端却要把它翻译成对多张指标表的访问。请求里的每个 valueType 都对应一种 SQL 谓词,响应里的每个 indexList 项都要在查询时现算。这就是后面所有复杂度的源头。
3. 四个绕不开的痛点
原实现把所有查询逻辑落在一段代码动态构建的 SQL 上:
- 可读性与维护性差:CTE + 多层嵌套 + 字符串拼接,新增一个指标要改 SQL 生成逻辑;
- 行转列放大 JOIN:用户勾选全部指标时,每个指标一次 LEFT JOIN 行转列与过滤,返回字段多达上百个;
- 查询期 JSON 解析:产品评分以 JSON 存储,查询时逐行解析取值,CPU 开销大;
- COUNT 与分页双重执行:count 与 list 并行执行,上述开销整体翻倍。
前两条是维护成本,后两条是直接的性能成本,而且是相乘关系。一行数据要解析 JSON、要参与多次 JOIN,COUNT 再来一遍,开销就翻倍。改造成败,就看能不能把后两条从查询路径上摘掉。
预期结果是改造范围被锁定在查询期:跑批、存储参数和前端协议都不动,只换查询实现。
二、瓶颈定位:慢在调用链的哪一环
1. 调用链:五次拼接,两次执行
queryPage(queryVo)
│
├─ handlerIndexList(indexList, queryVo)          // ① 指标配置加载与分组
│   ├─ 缓存读取指标配置(命中 → 解析为指标配置列表)
│   │   └─ 未命中 → 查询全量指标配置表
│   └─ 返回 Map<来源表名, 该表指标条件列表> + 指标配置列表
│
├─ buildProductMainSql(...)                      // ② 主表 CTE
│   └─ WITH productTB AS(t_review_product_base 按产品类型/状态等过滤)
│       ├─ 按策略 ID / 初始化标志 / 普通查询走不同 JOIN 路径
│       └─ 拼接名称模糊匹配等 WHERE 条件
│
├─ 动态构建指标临时表 SQL(遍历每个来源表)        // ③ 行转列
│   ├─ indexTb_i:按指标去重抽取原始指标记录
│   ├─ indexTb2_i:每个指标一次 LEFT JOIN,展开为列
│   └─ 收集 SELECT 字段与 JOIN 关系
│
├─ 组装最终 FROM + JOIN 子句                      // ④ 拼接
│
├─ 线程池并行执行 count + list                    // ⑤ 执行
│   ├─ executeCount → COUNT(*) 总数
│   └─ executeList → ROWNUM 三层嵌套分页 + 结果映射
│       ├─ 基础字段按位置 obj[0], obj[1]… 逐个取值
│       ├─ 扩展指标按来源表区分动态列位置
│       └─ 单位转换、名称映射等后处理
│
└─ 返回分页结果(总数 + 当前页数据 + expand.indexList)
五个阶段里,① 和 ② 是准备,③ 和 ④ 是拼接,真正落到数据库的只有 ⑤。但 ③ 生成的临时表数量和 ④ 拼出的 JOIN 数量,直接决定了 ⑤ 的成本。所以看执行计划之前,先看懂这段调用链。
2. 指标预处理:配置驱动分组
handlerIndexList 是动态 SQL 的入口,职责是把前端传入的指标条件做翻译和分组:
handlerIndexList(indexList, queryVo) → (指标分组, 指标配置列表)

1. indexList 为空
     → 若默认排序为 PRODUCT_PRODUCT_SCORE(依赖指标表),置空排序
     → 返回 (空分组, 空列表)
2. 加载全量指标配置(缓存优先,未命中查配置表)
3. 遍历 indexList 中每个指标条件:
     a. 按 indexCode 在配置中查找,未命中 → 跳过(非法指标)
     b. 命中 → 补齐 valueType / sourceTable / indexBaseCode,做合法性校验
     c. 按 sourceTable 分组收集
4. 返回 Map<来源表, 指标条件列表> + 指标配置列表
要点是指标配置驱动。每个指标码在配置表中登记了来源表、值类型、基础码等信息,分组结果决定后续生成几组临时表 SQL。这一步的产出是一个以来源表名为 key 的 Map,Map 有多大,后面的 JOIN 就有多少组。
3. SQL 生成:N 个指标就是 N 次 JOIN
以「组合类型 + 4 个评分 + 9 个收益率指标」为例,最终拼接出的 SQL 结构:
WITH productTB AS (                        -- ① 主表 CTE
    FROM t_review_product_base
    WHERE 产品类型 IN (...) AND 产品状态 = 1
    SELECT 约 20 个基础字段 + INDEX_TARGET_CODE / ACCOUNT_ID / ACCOUNT_TYPE
),
indexTb_i AS (                             -- ② 指标抽取:对每个来源表 i
    FROM 指标表 i INNER JOIN productTB
    WHERE 批次日期 = 当天 AND 指标码 IN (本次传入的指标)
    SELECT DISTINCT 目标编码, 指标码, 指标值
),
indexTb2_i AS (                            -- ③ 行转列:该表每个指标一次 LEFT JOIN
    FROM (SELECT DISTINCT 目标编码 FROM indexTb_i) t
    LEFT JOIN indexTb_i AS 第 j 个指标
         ON 目标编码相同 AND 指标码 = 第 j 个指标码
    SELECT json_value(第 j 个指标.指标值, '$.meta.score') AS index_j
),
-- 评分表 4 个指标 = 4 次 LEFT JOIN;收益率表 9 个指标 = 9 次 LEFT JOIN

SELECT productTB.*, index_0 … index_j      -- ④ 最终查询
FROM productTB
LEFT JOIN indexTb2_0 / indexTb2_1 / …
WHERE 各 index_j 按 valueType 过滤(IN / BETWEEN / 等值 / 日期区间)
ORDER BY NVL(排序指标, -9.2e18) DESC       -- 空值排到最后
→ ROWNUM 三层嵌套分页                       -- ⑤ 分页
注意注释里的两行:评分表 4 个指标就是 4 次 LEFT JOIN,收益率表 9 个指标就是 9 次 LEFT JOIN。指标越多,JOIN 越多,这是线性放大,不是常数开销。用户勾满指标时,这段 SQL 的 FROM 子句会长到难以阅读。
4. 数据规模与执行计划
各指标表按「产品数 × 指标数」每日全量重算,产品数约 10 万,指标覆盖各周期收益/风险、风格、客户与商业价值、产品评分等 200+ 项:
| 表名 | 分区 | 存储内容 | 指标数 | 日增(行) | 热数据保留 | 预计总量(行) |
|---|---|---|---|---|---|---|
| T_REVIEW_PORTFOLIO_INDEX | 是 | 专业能力:风险/收益/胜率 | 101 | ~1,036 万 | 250 交易日 | ~26 亿 |
| T_REVIEW_PORTFOLIO_STR_INDEX | 是 | 专业能力:风格 | 10 | ~103 万 | 250 交易日 | ~2.6 亿 |
| T_REVIEW_DSP_P_INDEX | 否 | 商业价值、客户价值 | 45 | ~461 万 | 250 交易日 | ~11.5 亿 |
| T_REVIEW_INDEX_VALUE | 是 | 产品评分(JSON 存储) | 19 | ~195 万 | 250 交易日 | ~4.9 亿 |
| T_REVIEW_STOCK_PREFER_INDEX | 否 | 风格诊断 | 70 | ~718 万 | 12 天 | ~0.9 亿 |
| T_REVIEW_PRODUCT_MARKET_STYLE | 是 | 市场风格 | 10 | ~103 万 | 250 交易日 | ~2.6 亿 |
| T_REVIEW_STYLE_INDEX | 否 | 产品风格 | 9 | ~92 万 | 12 天 | ~0.1 亿 |
结合执行计划(EXPLAIN PLAN)与表计数验证,瓶颈集中在三点:
- 大表多次扫描:单次查询中评分表被扫 4 次、收益率表被扫 9 次(每个指标一次 JOIN);
- 复合索引使用效率低:仅命中前导列,无法有效过滤大范围数据;
- JSON 解析 + 行转列开销大:逐行解析叠加多层 LEFT JOIN,且 COUNT 与 LIST 双重执行。
到这里,优化目标可以量化了:把单次查询的 13 次大表扫描降为 0 次,把 COUNT 与 LIST 的双重执行降为一次索引查询。下一节讨论怎么做到。
三、方案选型:查询时 JOIN 还是写入时宽表
1. 两条路线的成本对比
选品场景是读多写少、多维动态过滤、高并发查询,正好是倒排索引加列式存储的主场。改造思路一句话:把查询时的计算成本前移到写入时。
DB(多张指标表,每日跑批计算)
        │  全量初始化 + 增量同步(Binlog / MQ)+ 每日对账
        ▼
ES 宽表索引 product_review_index(一产品一文档,指标按来源表分组)
        ▲
前端 indexList ──▶ DSL 生成器(按 valueType 分支)──▶ bool.filter + sort + from/size| 维度 | 原实现 | ES 方案 |
|---|---|---|
| 数据模型 | 多表垂直拆分,查询时动态 JOIN 行转列 | 反范式宽表:一产品一文档,指标按来源表分组 |
| JSON 解析 | 查询期实时解析 | 跑批期展开为扁平字段 |
| 条件构建 | Java 拼接 CTE SQL | 按 valueType 生成 DSL(bool.filter / range / terms) |
| 排序分页 | ORDER BY + ROWNUM 三层嵌套 | doc_values 列式排序 + from/size(预留 search_after) |
| 生命周期 | 单表无限增长 | 热数据保留 250 交易日,超期归档 |
配图
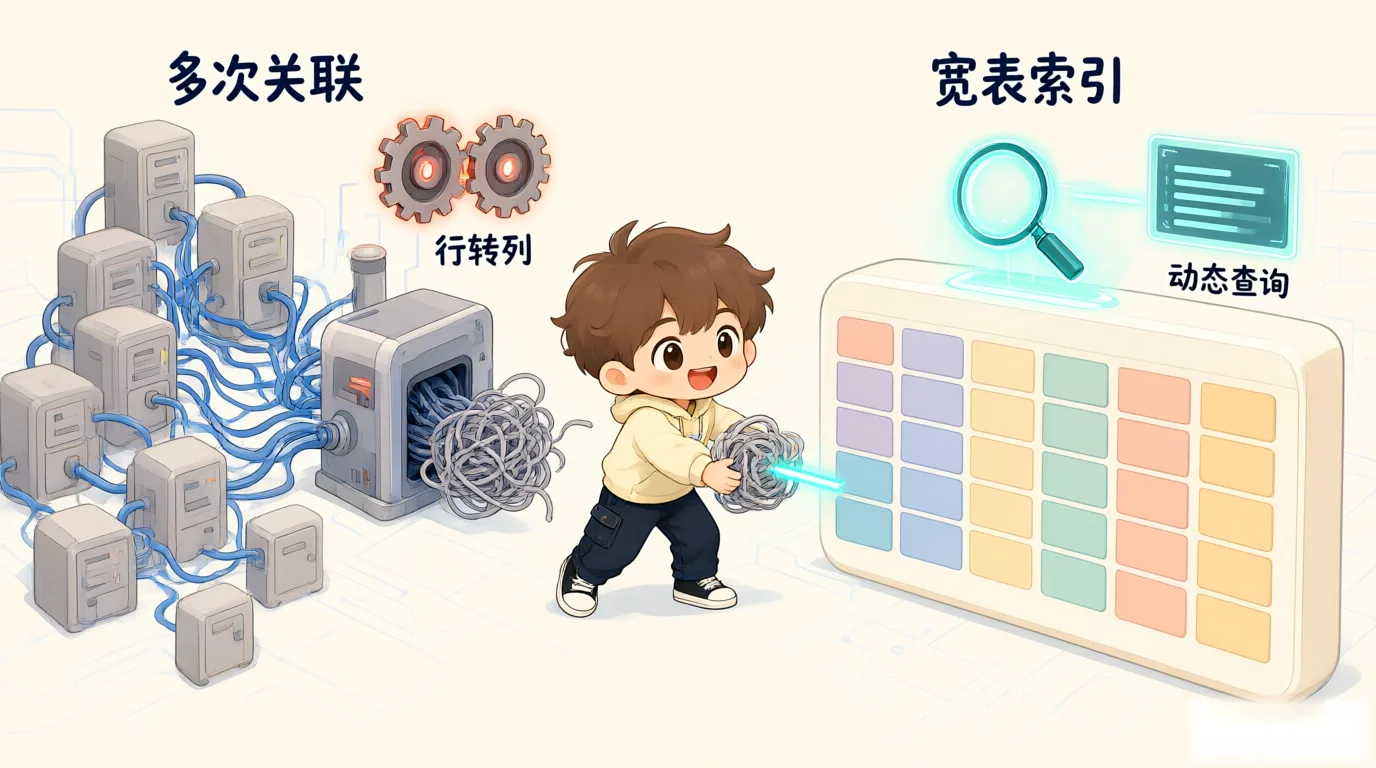
图 1:查询时 JOIN 与写入时宽表,把关联成本前移到写入
这张图是整篇的分水岭。左边是查询时关联,成本随指标数线性增长;右边是写入时宽表,查询只面对一个文档。选品页的读远多于写,这笔账怎么算都划算。
2. 索引模型:一产品一文档
一个文档对应一个产品:productCode 作为文档 ID,statDate 记录指标快照日期。字段按来源表分组,共 6 组、200+ 字段:
product_review_index
├─ productCode : keyword                     -- 文档 ID
├─ statDate    : date(yyyy-MM-dd)           -- 快照日期
├─ status / productStatus : keyword
│
├─ T_REVIEW_INDEX_VALUE             -- 产品评分:4 个 double(总分 / 专业能力 / 商业价值 / 客户价值)
├─ T_REVIEW_PORTFOLIO_INDEX         -- 专业能力·数值:101 个 double(各周期收益率、年化波动率、
│                                     贝塔、夏普、最大回撤、胜率、各板块仓位占比等)
├─ T_REVIEW_PORTFOLIO_STR_INDEX     -- 专业能力·风格:10 个 keyword(持仓 / 市值 / 业绩风格、行业分布)
├─ T_REVIEW_DSP_P_INDEX             -- 商业与客户价值:45 个 double(创收、新签、在签、退签率、跟投率)
├─ T_REVIEW_PRODUCT_BASE            -- 基础属性:主理人、上线日期、类型、来源、风险等级
│                                     (keyword / date);简介、亮点(text)
└─ T_REVIEW_PRODUCT_NEW_LABEL_INDEX -- 标签:2 个字段
两条设计规则:
- 分组名沿用来源表名:与指标元数据配置对齐,天然避免跨表字段重名冲突;
- 类型只由用途决定:参与精确/多值匹配用 keyword,参与范围过滤与排序的数值用 double,日期用 date,仅展示的长文本用 text。
应用侧实体(Spring Data Elasticsearch)按同样结构映射:@Document 指定索引名,六个分组各声明为一个嵌套对象,组内字段逐个注解类型,与指标元数据一一对应。
这样设计后,前端传的 indexCode 可以直接拼成 ES 字段路径,不需要再做一层表名到字段名的翻译。分组名就是来源表名,元数据里登记什么,索引里就长什么样。
3. 字段类型映射:VALUE_TYPE 决定一切
指标元数据中的 VALUE_TYPE 直接决定 ES 字段类型:
| VALUE_TYPE | 语义 | ES 字段类型 | 依赖能力 |
|---|---|---|---|
| 1 | 多选值 | keyword | 倒排索引,terms 精确匹配 |
| 2 | 范围值 | double | doc_values,range 过滤与排序 |
| 3 | 字符串值 | keyword | term 精确匹配 |
| 4 | 日期值 | date | range + format |
| 11 | 业务扩展(如主理人) | keyword | term 精确匹配 |
| — | 长文本(简介/亮点) | text + keyword 子字段 | 全文检索 + 精确回显 |
这张表是整个改造的契约。元数据里登记的值类型,决定 DSL 生成器该拼 terms 还是 range;字段建错类型,后面怎么调 DSL 都救不回来。比如把评分建成 text,排序会直接报错,改成 keyword 又做不了范围过滤。
预期结果是前端 indexCode 能直接映射为字段路径,新增指标时只改元数据和 mapping,查询骨架不动。剩下的工作,就是把 SQL 生成逻辑逐条翻译成 DSL。
四、落地实现:DSL、分页与数据同步
1. DSL 生成器:从拼 SQL 到拼 bool.filter
替代 SQL 拼接的是一个 DSL 生成器:同样以指标元数据为驱动,遍历 indexList,按 valueType 分支生成查询子句,统一放进 bool.filter,不参与打分,可被节点缓存。
| valueType | 生成子句 |
|---|---|
| 1(多选) | terms |
| 2(范围) | range(gte / lte) |
| 3(字符串) | term |
| 4(日期) | range + format = yyyy-MM-dd |
| 11(业务扩展:主理人) | term |
| 未传值 | 不生成子句;需要存在性语义时追加 exists |
前面那份 queryPage 请求会被翻译为:
query:
  bool.filter[
    term(productStatus = "0"),
    terms(T_REVIEW_PRODUCT_BASE.TB_P_PRODUCT_LEVEL2_TYPE = ["3", "0"]),
    range(T_REVIEW_INDEX_VALUE.PRODUCT_PRODUCT_SCORE, gte = 10, lte = 50),
    range(T_REVIEW_INDEX_VALUE.PRODUCT_PROFESSIONAL_SCORE, gte = 11.5, lte = 50.6),
    range(T_REVIEW_PRODUCT_BASE.TB_P_PORTFOLIO_LAUNCH_DATE,
          gte = "2025-09-02", lte = "2025-09-28", format = "yyyy-MM-dd")
  ]
sort:
  T_REVIEW_INDEX_VALUE.PRODUCT_PRODUCT_SCORE desc, missing = _last
分页:
  from = 0, size = 10
对照动态 SQL 的 NVL(评分, -9.2e18):ES 排序直接读 doc_values 列式存储,空值用 missing 声明即可;指标扩展从改查询代码变成维护元数据配置。
预期结果是,同一组筛选条件生成的子句数量和用户实际勾选的条件数一致,不再和指标总数挂钩。原来 13 次 JOIN 的查询,这里只剩 5 个 filter 子句。
2. 排序与分页:from/size 与 search_after 的边界
- 排序字段任意:数值/日期字段天然带 doc_values,排序不落回堆内存;
- 分页:选品列表用户集中在头部页,from + size 覆盖即可;导出或深翻页场景切换 search_after 游标,规避 max_result_window(默认 1 万)与深分页内存开销。
这里的取舍是明确的:头部页用 from + size,实现简单;超过 1 万条的深翻页不硬扛,直接换游标。选品导出正好走后者,用户对导出耗时也不敏感。
3. 同步、对账与降级:让 ES 的数据可信
采用「全量初始化 + 增量同步 + 定时对账」:
- 全量:离线跑批按 productCode + statDate 分批拉取写索引,避免一次性加载 OOM;
- 增量:监听 Binlog(Canal 类组件)或业务双写 MQ,异步更新对应文档;
- 对账:每日凌晨比对 DB 与 ES 的 COUNT 与核心指标抽样,偏差超阈值触发重建;
- 幂等:文档携带版本号 / update_time,重复投递按版本覆盖;
- 降级:ES 异常或写入延迟时,限流切换 DB 只读副本或返回最近一次成功快照。
对账是这套同步方案里最容易被省略的一步,也是 ES 方案能不能长期可信的关键。没有对账,写入延迟和漏消息只能等用户投诉才发现。降级同理,平时不用,出事时就是唯一的退路。
4. 生命周期与配套改造
- 归档:超 250 交易日(热数据窗口)的数据迁移至历史表/归档索引,可结合 ILM 做索引降级,保持热索引轻量;
- 跑批优化:全量重算改为增量 + 分片并行,控制单批数据量防 OOM,兼顾计算性能;
- 存储侧:源库继续推进数据分表/分区,为归档与历史回溯留出空间。
这三件事不在查询链路上,却决定了这套方案能跑多久。热索引只留 250 个交易日,归档和跑批各归其位,索引才不会越滚越大。
5. 预期收益:从秒级到百毫秒
以下为改造目标值(预估):
| 维度 | 现状 | 目标 |
|---|---|---|
| 查询耗时 | 秒级(全指标组合 + 深排序时 3~5s 甚至超时) | 100~300ms |
| 指标扩展 | 改查询代码与 SQL 逻辑 | 配置化,新增指标仅维护元数据与字段定义 |
| 查询实现 | 动态 SQL 拼接、上百返回字段 | DSL 生成器统一收敛 |
| 跑批稳定性 | 全量跑批易 OOM | 分批 + 分片,内存预计下降约 60% |
| 数据生命周期 | 热数据无限增长 | 250 交易日外自动归档 |
收益表里最值得关注的是第二行。指标扩展从改代码变成加配置,前者每次都要发版,后者只动元数据。对一个月要加十几个指标的选品团队来说,这比查询耗时从 3 秒降到 300 毫秒更有价值。
常见错误与排错
- 现象:勾了筛选条件,ES 却返回全量数据。原因:indexList 里的 valueType 没传或不在元数据中,DSL 生成器走了「未传值不生成子句」分支。解法:入口按指标元数据补齐 valueType,非法指标明确报错,不要静默跳过。
- 现象:排序结果末尾几名和 DB 不一致。原因:sort 没声明
missing,或排序字段被建成了 text。解法:排序字段统一 double/date,并在 sort 中显式加 missing: _last。 - 现象:翻到第 1001 页时报窗口超限。原因:from + size 深分页触发了 max_result_window 默认值 1 万。解法:导出和深翻页改走 search_after,不要调大窗口硬扛。
- 现象:新增指标上线后查询报字段不存在。原因:只改了元数据配置,没同步改索引 mapping 和实体类。解法:mapping、实体、元数据同批发布,先建字段再放流量。
- 现象:DB 与 ES 条数长期对不上。原因:增量消息漏投或重复投递,且没有对账兜底。解法:文档带版本号保证幂等,每日对账,偏差超阈值触发重建。
本篇小结
- 选品的慢不是 SQL 写得差,而是把关联成本留在了查询期。
- 宽表的关键不是字段多,而是字段按来源表分组、类型按用途确定。
- DSL 生成器只做元数据翻译,查询子句数量与指标总数无关。
- 同步方案必须带对账和降级,否则 ES 只是另一个不可信副本。
- 250 交易日热窗口,是索引体量和查询性能之间的平衡点。