生产问题排查速查手册:Linux 常用命令
凌晨两点被告警叫醒,登上跳板机,先 ps 还是先 tail?这份手册把生产排查最常用的进程、日志、接口命令固定下来,照着抄就能跑。
本篇你能学到
- 用
ps aux与ps -ef确认服务进程和父进程 - 用
zgrep在按天压缩的日志里查上下文 - 用
grep -C 5定位报错前后 5 行线索 - 用
curl -v判断网络连通性与请求响应 - 用
-w "%{http_code}"在脚本里只取状态码
一、排查总思路:三板斧
1. 固定顺序:进程、日志、接口
生产告警到手,我的固定套路是:
定位进程 → 找到日志文件 → 按 key 检索上下文 → 需要时通过 HTTP 请求验证接口这条顺序的逻辑是先确认对象、再找证据、最后做验证。进程不在,后面两步都白做;进程在但日志有异常,就去日志里找上下文;日志看不出问题,再用接口请求验证服务本身。
2. 三板斧与整机排查层次
从整机到线程,资源类问题的排查层次是先看负载、再定位进程、最后看线程栈。这份手册处理的是业务告警,落到单机上收敛为三段:进程、日志、接口;日志不在本机时,先远程拉取再检索。前者判断机器是否健康,后者判断服务是否正常。
配图
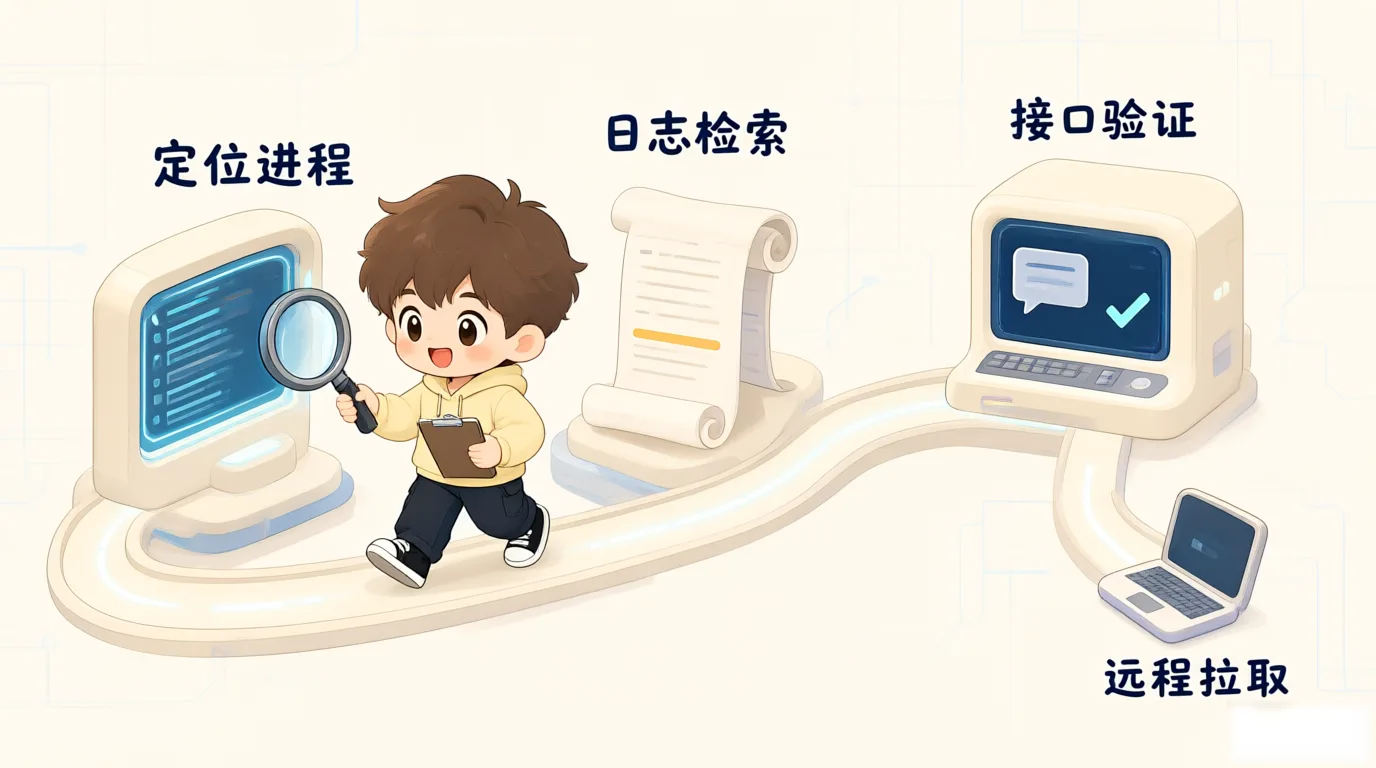
图 1:排查三板斧落地,定位进程、检索日志、验证接口,日志在远端时先拉取
3. 每一步的预期产出
进程这步要拿到 PID 和启动用户,日志这步要拿到报错前后 5 行,接口这步要拿到状态码和响应体。三样凑齐,大多数告警都能定位到具体环节,而不是停在「服务好像有问题」。
二、进程与服务排查
1. 确认进程是否存活
确认目标服务是否在运行、运行在哪个节点上:
# 查找某个进程(比如确认 nginx / java 进程是否存活)
ps aux | grep nginx
预期结果是输出里出现目标进程的 PID、启动用户和启动命令。比如 nginx 一般是一个 master 加若干 worker,只有 master 没有 worker,说明 worker 起不来,问题不在端口而在配置或权限。
2. 常用变体与判读
常用变体有两个,一个看父进程,一个排除 grep 自身:
ps -ef | grep java          # 另一种格式,能看到父进程
ps aux | grep java | grep -v grep   # 排除 grep 自身
ps -ef 的 PPID 列能看出进程由谁拉起,排查「重启后进程反复退出」时特别有用。ps aux 的输出更适合看 CPU、内存占比;管道里 grep 自身也会被匹配到,所以要加 grep -v grep。
正常状态下,列表里只剩真正的 java 进程,PID 稳定,CPU 和内存没有异常飙高。如果 PID 一直在变,说明进程在反复重启,先去日志里找退出原因。
三、日志排查:从目录到上下文
1. 日志位置:先确认目录再搜文件
应用日志通常有约定俗成的目录,我们环境是:
cd /wls/applogs/ # 应用日志根目录,按应用名分目录存放打开后能直接看到按应用名分的子目录。先确认目录再搜文件,比上来就全盘查找快得多,也不会误碰系统日志。
2. 压缩日志搜索:历史报错用 zgrep
线上日志按天滚动压缩(.gz)非常常见,直接 grep 会漏掉历史日志。用 zgrep:
zgrep -C 5 --color=auto "关键字" /path/to/app.log.2026-03-18.gzzgrep 的参数与 grep 基本一致,区别是它能直接读 .gz。预期结果是压缩包里的命中行照样带上下文打印出来,不用先解压再搜。
3. 普通文本搜索:grep 必带上下文
grep -C 5 --color=auto "关键字" /path/to/app.log参数说明:
- -C 5:显示匹配行前后各 5 行上下文,排查问题必加,单看一行日志几乎没有信息量;
- --color=auto:高亮命中内容,快速定位。
搜索出来的结果应当命中行居中,前后各 5 行调用链或异常栈一起打印。如果异常栈特别长,把 5 调大,先看完整再谈定位。
4. 加强组合:计数、过滤、实时跟踪
常用加强版:
# 统计关键字出现次数(评估影响面)
grep -c "ERROR" app.log

# 多个关键字的排查组合
grep -E "ERROR|Exception" app.log | grep "orderId=123"

# 实时滚动跟踪
tail -f app.log | grep --color=auto "关键字"
grep -c 用来评估影响面,ERROR 出现 200 次和 2 次,处理优先级完全不同。-E 把多个关键字并起来,再串一个业务 key,能快速缩小到某个订单。tail -f 适合复现中的问题,一边操作一边看输出。
这样一轮下来,先拿到影响面数字,再拿到单个订单的完整上下文,最后能实时观察复现过程。
5. 远程拉取:把日志带回本地
本地分析(看 GC 日志、dump 文件等)比在服务器上直接看舒服得多:
scp <user>@<远程主机>:/remote/path/app.log /local/path/远程路径在前、本地路径在后,执行前先确认两端目录。拉取完成后,文件应完整落到本地目录,大小与远程一致,后续用本地工具慢慢分析。
四、用 curl 验证接口
1. GET 请求:先确认接口活着
排查问题时经常需要直接调用接口验证服务状态,curl 是服务器上最顺手的工具。
curl http://<服务地址>:<端口>/api/v1/users排查网络连通性问题加 -v,可以看到完整的连接、请求、响应过程:
curl -v http://<服务地址>:<端口>/api/v1/users预期结果是返回 200 和业务 JSON。加 -v 后能看到 DNS 解析、TCP 连接、请求头、响应头和响应体,卡在哪一步一目了然。如果连 TCP 都没建起来,就不用再怀疑业务代码。
2. POST JSON:改开关、查开关
以调用一个开关接口为例(修改第三方服务可用状态):
curl --location --request POST 'http://<服务地址>:<端口>/communityservice/api/v1/switch/set' \
--header 'Content-Type: application/json' \
--data-raw '{
  "key": "thirdparty:status",
  "status": false
}'
查询类接口同理:
curl --location --request POST 'http://<服务地址>:<端口>/communityservice/api/v1/switch/get' \
--header 'Content-Type: application/json' \
--data-raw '{
  "key": "thirdparty:status"
}'
两个请求的 body 只差一个 status 字段。set 返回成功后,再 get 一次应能看到 thirdparty:status 已经变为 false,确认修改生效,而不是只看 set 的返回码。
3. 参数速查
| 参数 | 作用 |
|---|---|
-X / --request | 指定请求方法(GET / POST / PUT / DELETE) |
-H / --header | 添加请求头(如 Content-Type: application/json) |
-d / --data-raw | 携带请求体 |
-L / --location | 跟随 301/302 重定向 |
-v | 打印完整请求与响应过程,排查连通性问题必用 |
-o / -O | 响应保存到文件 |
-s | 静默模式,去掉进度条 |
-w "%{http_code}" | 只输出状态码,写脚本判断常用 |
这张表里最常用的是 -v 和 -w "%{http_code}"。前者排查连通性,后者适合写进脚本做判断,只取状态码,不解析整段响应。
4. 实战提醒:开关要留痕,也要记得恢复
应急类的开关操作,动作要留痕、恢复要记得。建议在故障处理清单里加一条「检查开关状态」,避免故障恢复后服务长期处于降级状态。
做到这一点,每次开关操作都有记录人和时间,复盘时能对上;恢复后开关回到默认值,不留下隐形降级。
常见错误与排错
- 现象:日志里搜不到昨天的报错。原因:日志已按天压缩成
.gz,grep不读压缩文件。解法:换成zgrep,路径直接指到.gz文件。 - 现象:进程列表里混进一条 grep 自己。原因:
ps aux | grep java会匹配到 grep 进程。解法:管道尾部加grep -v grep。 - 现象:只看到一行报错,不知道前后发生了什么。原因:搜索时没带上下文参数。解法:加
-C 5,异常栈长就把行数调大。 - 现象:curl 一直卡住或直接连接失败。原因:只盯着业务返回,没看连接过程。解法:加
-v看 DNS、TCP、TLS 各阶段停在哪,再确认地址和 端口。 - 现象:故障恢复了,第三方服务却一直是关闭状态。原因:应急开关改了没恢复,检查清单里也没这一项。解法:开关操作留痕,故障清单固定加一条「检查开关状态」。
本篇小结
- 排查顺序固定为进程、日志、接口,先确认对象活着,再找原因。
- 线上日志按天压缩,历史报错要用 zgrep,不要用 grep。
- grep 必带 -C 5,单看一行日志几乎没有信息量。
- curl -v 是连通性排查的第一手段,脚本里用 -w 单独取状态码。