几百个圈子的“合并同类项”:一次社区数据迁移的完整方案
社区里 500 多个圈子,一半是同一个主题被拆出来的。用户被稀释,运营管不过来,于是要在不丢流量、不丢用户关系的前提下合并成 60 余个,还要随时能整体回滚。这篇复盘完整方案。
本篇你能学到
- 判断合并容器该新建还是复用旧圈
- 用一张映射表同时兜住读写两条路径
- 定清哪些数据迁、哪些交给任务重算
- 按固定顺序执行迁移脚本并做数据核对
- 把回滚脚本当成变更包的一部分
一、圈子为什么会膨胀
1. 满员分裂留下的历史包袱
社区里的圈子,是用户加入兴趣主题、看内容、发帖、围观圈内成员实盘动态的地方。早期设计里单圈有人数上限,满员后系统自动分裂出一个同类新圈承接溢出用户。
加上运营跟随热点手工建圈,几年下来圈子总量积累到 500 多个,其中大量是同一个主题被拆成好几个圈的情况。
这套机制早期保护了单圈活跃度,副作用却越来越明显。同一主题的圈友散落在多个圈子,互动密度上不去;搜索和推荐里,用户面对四五个名字几乎一样的圈子,不知道进哪个;几百个圈子也让运营失焦,重复动作此起彼伏。
2. 四条业务目标
需求一句话概括:同类圈子合并、取消人数上限、停掉自动分裂。拆开是四条:
- 取消圈子人数限制;
- 停用满员自动分裂机制,同时取消“同类圈子只能加一个”的限制;
- 后台圈子列表增加权重展示列,并按权重排序;
- 全部流量入口平滑切到新圈子,旧链路不失效。
分裂逻辑本身不复杂,核心就是一个判断:participant_limit 到了就新建圈子。
写成伪代码是 if (memberCount >= participant_limit) createNewCircle()。这次要做的,是把这个判断从定时任务里摘掉,同时保证已经分裂出来的圈子被收回去。
预期结果:四条同时达成才算合并完成。只做了数据迁移而入口没切,用户看到的还是旧圈。
二、合并容器:新建,还是旧圈吞并
1. 旧圈吞并的三个问题
第一个要拍板的问题是谁当容器。方案 A 选一个存量圈子,把其他圈子的成员并进来。诱惑很直接:不用新建 ID,不用加映射表。
推演下去有三个问题。属性归谁:合并后的名称、头像、简介以哪个圈为准,拿哪个圈当容器哪个圈的属性就获胜,多组之间变成运营博弈。
脏数据混入:往存量圈灌成员,原生成员和迁移成员从此分不开,出问题只能按用户逐个修,无法整块回滚。聚合口径割裂:容器圈的榜单、热股既有存量数据又有新灌数据,前后口径不一致。
2. 新建圈子加映射表
最终采纳方案 B:每组建一个全新圈子,旧圈通过映射表跳转。代价是一张映射表和各入口的重定向改造,换来三个收益。
- 可整体回滚:新圈子是本次全新插入的,回滚时按新圈 ID 整块摘除;
- 可追溯:迁移动作全部有日志,每个成员怎么进来的查得清;
- 属性干净:新圈属性复制自基准圈,也就是同组中人数最多、ID 最小的旧圈,保证新圈长得像最主流的那个,避免运营博弈。
旧圈采用软下线:不再出现在搜索与推荐里,但保留可访问性,访问时重定向到新圈。历史上被分享出去的链接全部自然承接。
伪代码层面,一个合并组就是一次 createCircle + migrateMembers + insertMapping + softOffline(oldIds)。顺序不能反,映射要在入口切换前就位。
预期结果:每组产出一个新圈、N 条映射、旧圈标记为软下线,任何一步失败都能按新圈 ID 整块回滚。
三、整体设计:映射表是唯一翻译层
1. 映射表结构与索引
数据层新增一张映射表,记录新旧圈 ID 和分组:
CREATE TABLE t_circle_merge_mapping (
    id            bigint GENERATED BY DEFAULT AS IDENTITY,
    new_circle_id numeric(20) NOT NULL,   -- 合并后的新圈子ID
    old_circle_id numeric(20) NOT NULL,   -- 合并前的旧圈子ID
    kind_id       numeric(20),            -- 同类圈子分组ID
    create_time   timestamp DEFAULT CURRENT_TIMESTAMP,
    CONSTRAINT t_circle_merge_mapping_pkey PRIMARY KEY (id)
);

CREATE INDEX idx_mapping_old_circle_id ON t_circle_merge_mapping (old_circle_id);
CREATE INDEX idx_mapping_new_circle_id ON t_circle_merge_mapping (new_circle_id);
old_circle_id 上的索引是必须的。详情页每次访问旧圈都要查这张表,它是整个承接链路里最高频的查询。
预期结果:按旧圈 ID 查映射走索引,详情页重定向的耗时与直查圈子详情相当。
2. 读写入口向映射表收敛
具体改哪些功能,各家产品差别很大,照抄清单没意义。抽象来看,一次合并要动的代码归成四条主线。
写路径:所有用户加入圈子的入口统一先过映射表,请求带旧圈 ID 就翻译成新圈 ID 再落库,改造锚点是加圈服务 CircleServiceImpl#join。这样即使某个入口漏改,用户加进去的依然是新圈,行为兜底正确。
读路径:按 ID 读圈子详情,命中映射表就重定向到新圈;所有列出圈子的场景,包括列表、搜索、推荐,统一过滤掉已被合并的旧圈。
异步任务:停用满员自动分裂的定时任务;榜单、热股等聚合统计改为对合并后的数据重算。管理后台:提供新旧映射的维护与查询页面,圈子列表增加运营权重列。
核心思路是让映射表成为新旧世界之间唯一的翻译层。入口漏改一个不可怕,可怕的是漏改的入口行为不确定;统一过表之后,漏改的入口顶多体验差一点,比如多跳一次,不会写错数据。
重定向的交互定为先跳转、后提示:先把用户带到新圈子,再视情况告知发生过合并,避免用户停在旧圈看到一个死页面。
预期结果:旧圈 ID 的加圈请求落到新圈,旧圈详情页重定向到新圈,列表和搜索不再出现旧圈。读写两条路径的走法如下。
配图
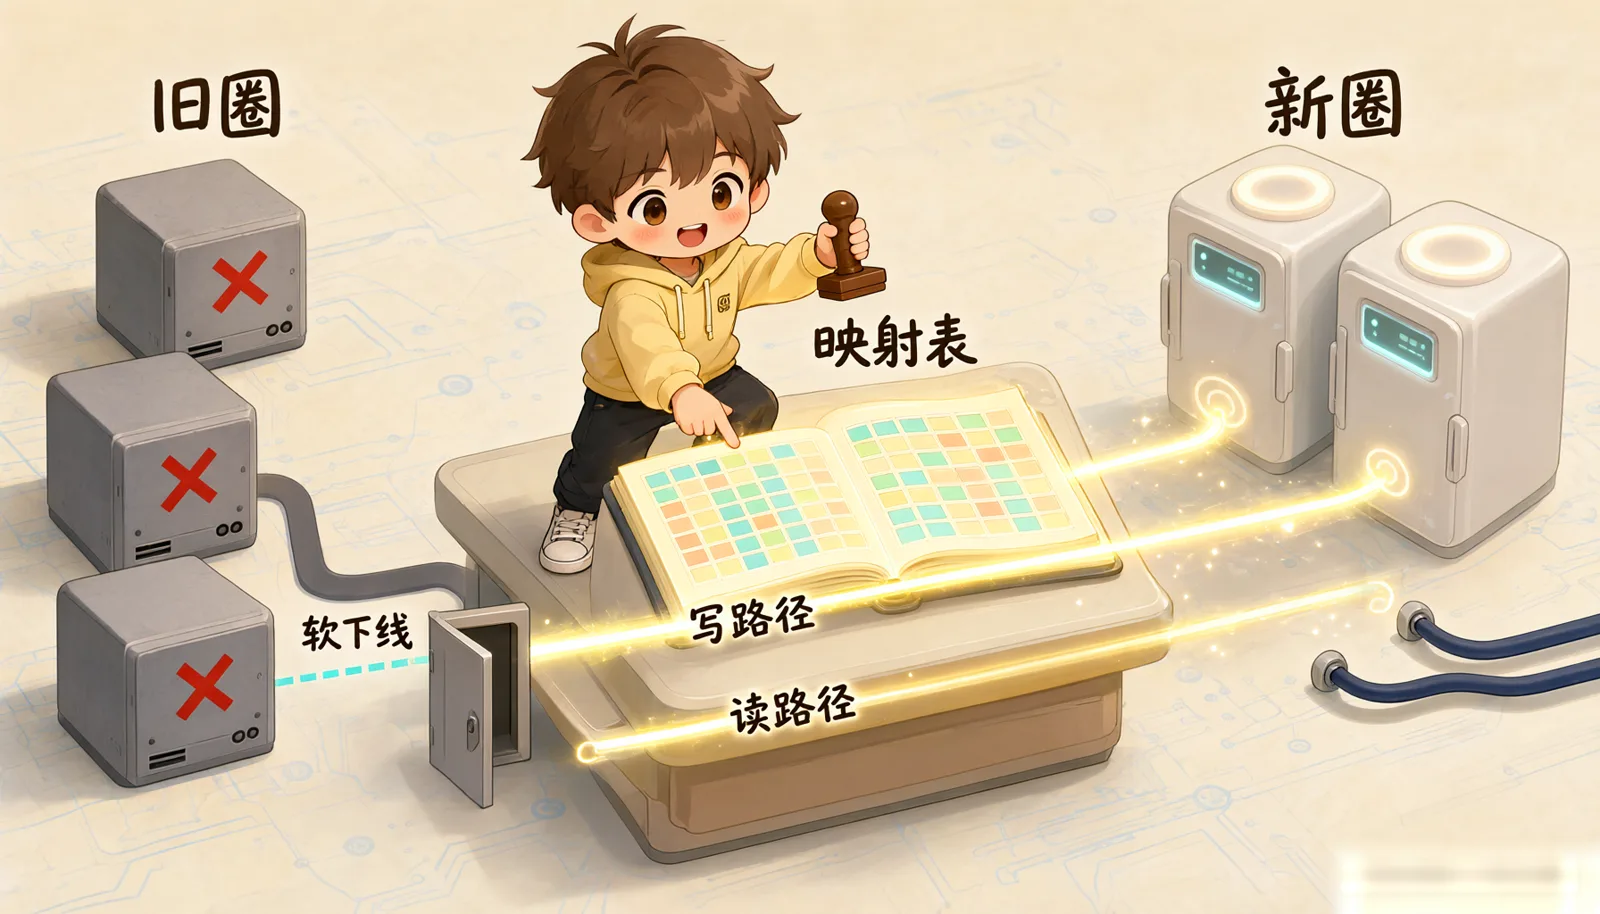
图 1:映射表翻译层,旧圈 ID 写路径翻译,读路径弹回新圈
3. 收尾:把人数上限关掉
人数上限不用改表结构,也不动存量字段。直接把 participant_limit 置为极大值、full_status 清零,再配合校验逻辑下线,双保险。
预期结果:加圈接口不再因为满员拒绝,自动分裂任务也不再触发。
四、迁移策略与上线执行
1. 手动与脚本分工
圈子处理分两类,边界要先划清:
| 场景 | 处理策略 | 执行方式 |
|---|---|---|
| 单个圈子 | 保持原样 / 仅改名 / 直接下线 | 产品在后台手动操作,不进脚本 |
| 多个同类圈子 | 前置改名 → 新建基准圈 → 迁移圈友 → 建立映射 | 自动化迁移脚本 |
全量圈子里有一小部分走手动通道,改名或下线即可,不需要迁数据;其余按同类拆成 60 余组,全部走脚本。
哪些进脚本、哪些手动做,本身就要和产品逐条确认成一张清单。这份清单与脚本同等重要,漏掉一个圈,它就会以旧姿态残留在线上。
还有一层是配置与逻辑分离。60 多组合并规则是纯数据,产品临时增删一组,只改一行配置,不动过程代码。
预期结果:清单上的每一个圈都有归属,脚本组和手动组不重不漏。
2. 哪些数据迁,哪些不迁
口径先定死,脚本才好写:
| 数据 | 口径 | 理由 |
|---|---|---|
| 圈子主体属性 | 复制基准圈全部属性到新圈 | 名称 / 头像 / 简介一次性定型 |
| 圈友关系(含消息订阅关系) | 全量迁移 + 去重 | 用户在多个旧圈时只保留一条,状态优先级最高 |
| 圈友操作日志 | 随迁移同步补记 | 迁移动作可审计、可追溯 |
| 帖子-圈子关联 | 全量复制 | 量级可控,且幂等可重放 |
| 动态类内容(交易动态 / 晒单) | 每组只带最新 1000 条 | 全量太重,新圈也不希望被陈年内容淹没 |
| 话题关联配置 | 每组复制最新一条 | 配置类数据取最新即可 |
| 收益榜单 / 持仓热股 | 不迁,由任务重算 | 聚合数据必须与任务口径一致(详见踩坑) |
| 更早的历史动态 | 不迁 | 留在旧圈,旧圈仍可访问 |
这张表里最容易被忽略的是聚合数据那一行。聚合数据一旦预刷,就和定时任务形成两个真相,任务下一跑可能覆盖预刷结果,中间还会出现口径不一致窗口。
迁移只迁事实数据,一切计算结果交给任务重算。上线后第一个任务周期跑完,新圈榜单自然齐了。
预期结果:脚本只写事实数据,新圈榜单和热股在任务周期结束后由聚合任务补齐。
3. 上线顺序与数据核对
窗口选非交易日的午后低峰,提前在测试环境完整演练一轮。执行顺序固定为:序列同步、事务内跑迁移脚本、数据核对、打开各入口的新圈展示。
序列同步必须排第一,因为新圈用手工指定的 ID 提前插入,主键序列不会自动跟上,setval 没做就会炸后续无关业务的主键冲突。
核对方式是迁移前按旧圈口径算出每个新圈的预期成员数,迁移后与实际值逐一比对:
-- 预期值:按映射表把各旧圈去重后的成员数聚合到新圈维度
SELECT m.new_circle_id, COUNT(DISTINCT u.member_id) AS expect_cnt
FROM t_circle_merge_mapping m
LEFT JOIN t_circle_member u ON u.circle_id = m.old_circle_id
GROUP BY m.new_circle_id;
除了数字核对,还要抽样走查:访问旧圈详情页应重定向到新圈,搜索旧圈名不应再出现旧圈。上线后盯三个指标:加圈接口错误率、重定向命中率、新圈内容流刷出率。
预期结果:每个新圈实际成员数与 expect_cnt 一致,旧圈入口全部重定向,三个监控指标无异常尖峰。整场上线按下面这张 Runbook 走。
配图
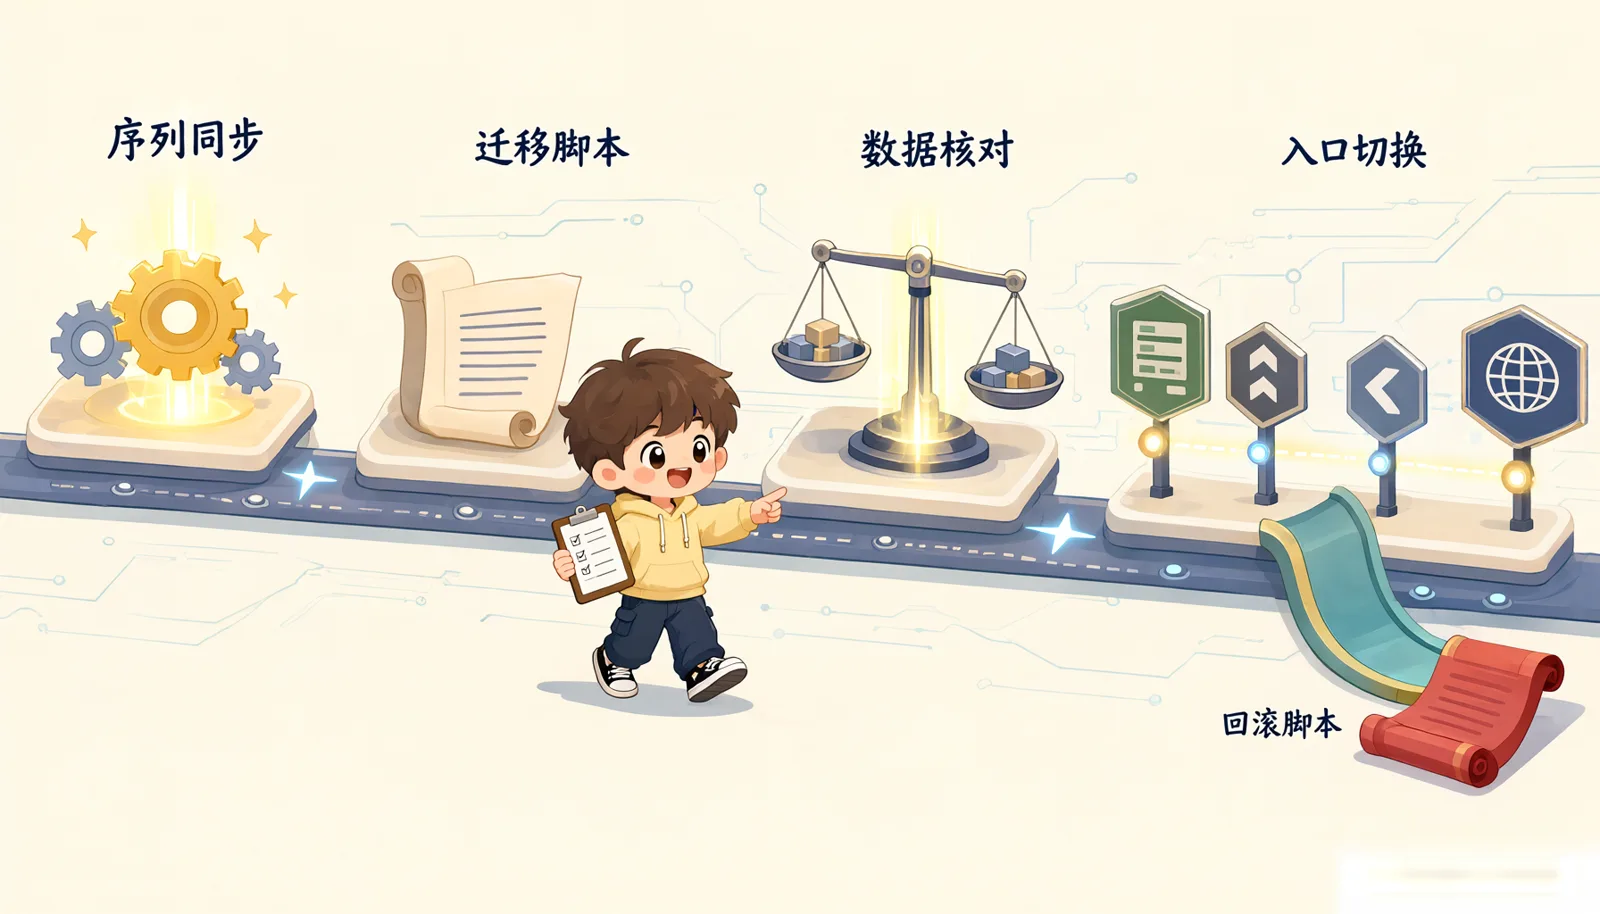
图 2:上线 Runbook,序列同步、迁移脚本、数据核对、入口切换,回滚脚本常备
常见错误与排错
现象:迁移完成后,别的业务插入数据报主键冲突。原因:新圈用手工指定的 ID 提前插入,主键序列还停在旧位置。解法:把
setval同步放到迁移脚本第一步,再跑后续插入。现象:脚本跑到一半失败,重跑时报唯一键冲突。原因:插入没做幂等,重放会重复写映射和成员。解法:写入统一加
ON CONFLICT DO NOTHING,让脚本可以无脑重放。现象:同一用户在新圈出现两条成员记录。原因:
DISTINCT ON的去重结果由ORDER BY决定,排序字段没覆盖状态优先级。解法:明确同一用户保留哪条,把状态优先级写进ORDER BY。现象:上线后新圈榜单和预刷结果对不上,任务一跑又变。原因:预刷的聚合数据和定时任务形成两个真相。解法:放弃预刷,榜单和热股由任务重算,等第一个任务周期跑完。
现象:旧分享链接打开是 404。原因:旧圈被物理下线。解法:改为软下线加重定向,旧圈保留可访问性。
本篇小结
- 合并容器要新建,旧圈吞并会让原生成员和迁移成员永久混在一起。
- 映射表是唯一翻译层,写路径翻译、读路径重定向,漏改入口也不会写错数据。
- 迁移只迁事实数据,榜单和热股交给任务重算。
setval是脚本第一步,ON CONFLICT DO NOTHING是重放保险。- 回滚脚本要和迁移脚本同评审、同入库、演练时同执行。