一次 JVM 降配评估:内存长期 99% 的实例,能不能降到 4 核 8G?
公司推行降本增效,要求把一批 8 核 16G 的虚拟机降配成 4 核 8G。监控上这批机器的内存长期停在 99%,我本来以为只是应用占得多。翻完启动脚本才发现,这笔账不是这么算的。
本篇你能学到
- 用总内存、堆、非堆与 OS 三块把一台机器的内存账算平,判断还有没有降配空间
- 从
-Xms和-XX:MaxNewSize两个参数快速识别被配置堵死降配的实例 - CMS 切 G1 时要删哪些参数,以及为什么不能手设新生代大小
- 用内存水位和 Full GC 间隔两个指标做灰度验收
一、先把账算清楚:99% 的内存被谁占了
1. 监控只给结果,不给构成
降配评估最容易犯的错,是盯着监控曲线下结论。CPU 低就说可以降,内存高就说不能降,这两种判断都跳过了关键一步:内存到底被谁占着。
所以第一步不是改配置,而是把三样东西固定下来:实例规格、CPU 曲线、内存曲线。这三样决定了后面所有推演的地基。
虚拟机规格 8 核 16G。从监控看,CPU 使用率长期偏低,这是 CPU 可以立即降配的依据。内存使用率长期维持在 99% 高位,这是内存降配危险的核心信号。
2. 打开启动脚本,看 JVM 锁了多少
为什么先看启动参数?因为 JVM 对内存的占用,在进程启动那一刻就定下了大头。监控上的水位,只是这份配置在运行时的投影。
怎么做?找到服务的启动脚本,把 SERVER_JAVA_OPTS 完整打印出来。
export SERVER_JAVA_OPTS="
  -javaagent:/path/to/apm-agent.jar
  -DLog4jContextSelector=org.apache.logging.log4j.core.async.AsyncLoggerContextSelector
  -Xms8192m
  -Xmx8192m
  -XX:MaxNewSize=128m
  -XX:+UseConcMarkSweepGC
  -XX:+PrintGCDetails
  -XX:+PrintGCTimeStamps
  -XX:+HeapDumpOnOutOfMemoryError
  -verbose:gc
  -Xloggc:$LOG_PATH/gc.log
"
javaagent 等 APM 探针参数与本文分析无关,已简化。真正要紧的是下面这几个参数。
| 参数 | 含义 |
|---|---|
-Xms 8192m / -Xmx 8192m | 堆内存初始/最大大小,启动即锁定 8GB |
-XX:MaxNewSize 128m | 新生代最大仅 128MB(占堆 1.5%) |
-XX:+UseConcMarkSweepGC | CMS 收集器 |
-XX:+PrintGCDetails 等 | 打印 GC 详情与时间戳 |
-XX:+HeapDumpOnOutOfMemoryError | OOM 时自动生成堆 dump |
有两个数字很刺眼。-Xms 8192m 让堆在启动瞬间锁定 8GB,-XX:MaxNewSize 128m 让 8GB 的堆里新生代只剩 128MB。
3. 剩下 8GB 去哪了
16GB 总内存减去 8GB 堆,还剩 8GB。这 8GB 要装下非堆内存,包括 Metaspace、线程栈、直接缓冲区等,还要留给操作系统自身开销。
实测下来,这部分实际占用了约 8GB。也就是说整机内存几乎没有余量,这正是监控里 99% 使用率的来源。降到 8G 总内存后,连 JVM 自己都装不下。
把账摊开看:堆 8GB 加非堆与 OS 8GB,正好等于 16GB 的总内存。
配图
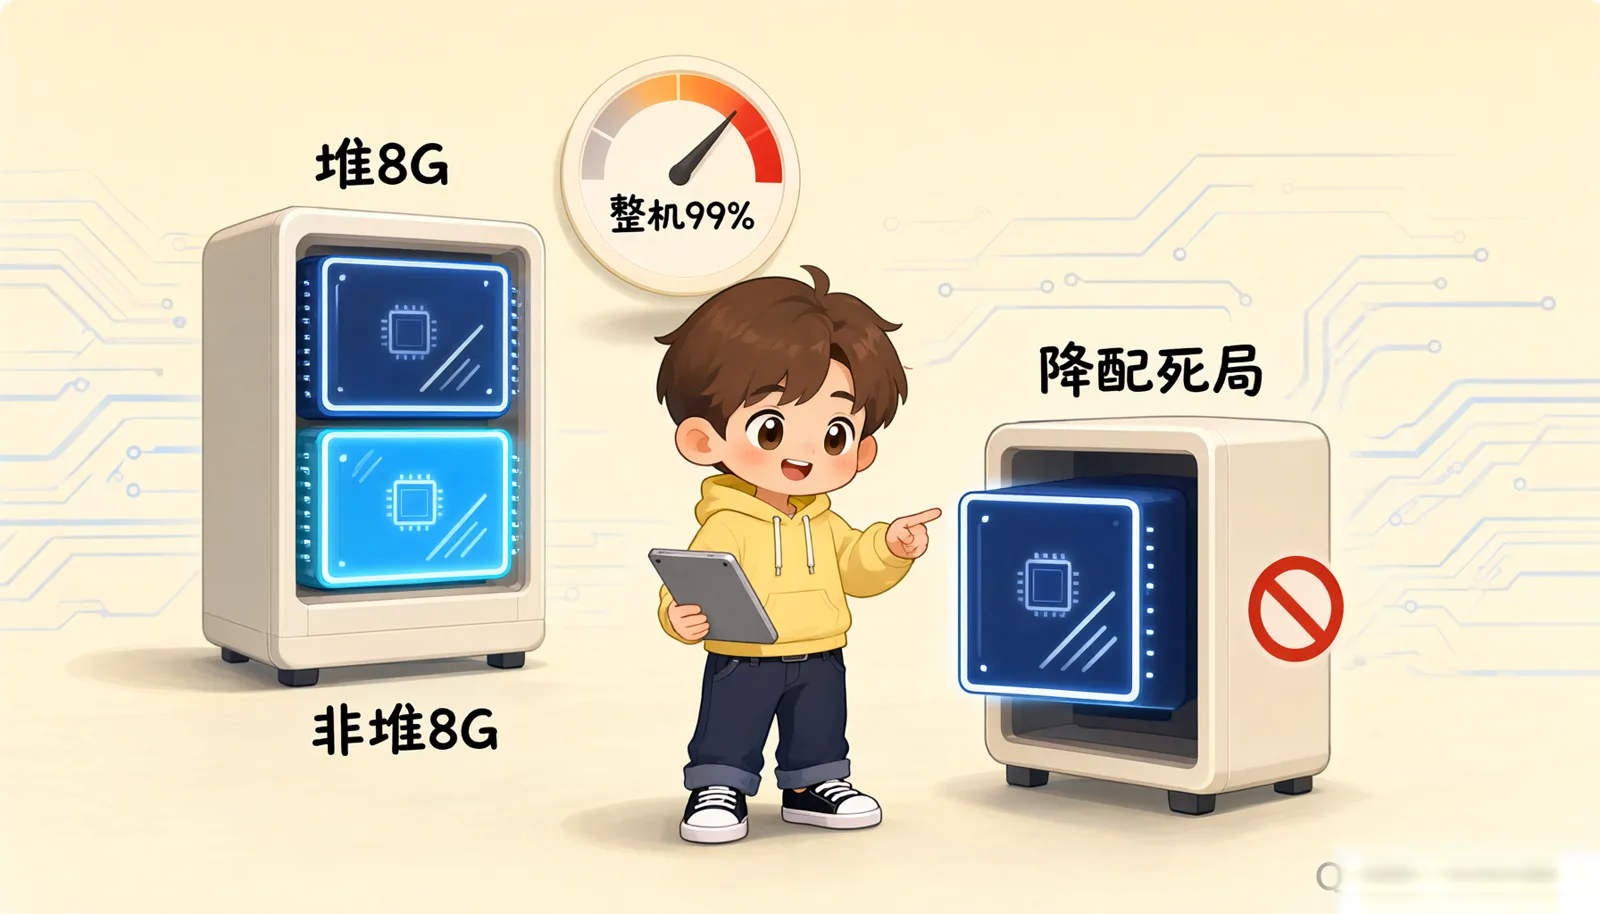
图 1:内存账本,16G 里堆与非堆各占 8G,整机水位 99%
预期结果:账算完,结论已经很清楚。这台机器没有可压缩的空间,降配到 8G 会在启动阶段直接失败,与业务代码写得好不好无关。
二、两个核心问题:账不平,新生代还畸形
1. 内存账算不平,8G 机器装不下 8G 堆
为什么强调这一点?因为很多人降配时只改机器规格,JVM 参数原样带过去,结果服务根本起不来。
推演过程很简单,算式只有一行:8GB 堆 + 非堆与 OS > 8GB 总内存。-Xms 8192m 会在启动瞬间锁定 8GB 堆内存,而实例总内存只有 8GB。操作系统连自身运行所需的内存都没有,进程会被 OOM Killer 直接杀掉。
这类故障在监控上的表现不是慢,而是断。进程起来几分钟后失联,日志里看不到业务异常。预期结果就是直接降配必挂,没有任何侥幸空间。
2. 新生代 128MB,Full GC 每 20 小时一次
第二个问题更隐蔽。8GB 的堆里,新生代只有 128MB,算下来是 128MB / 8192MB ≈ 1.5%,这个比例小得离谱。
新生代太小会引发三步连锁反应。对象在 Eden 区活不了几轮就被挤到老年代,因为 Eden 太小、Minor GC 太频繁,对象稍微多活一会就超过晋升阈值。大量本应朝生夕死的临时对象因此被晋升到老年代。老年代快速填满,触发 CMS Full GC。
查证方法是看 GC 日志。启动参数里的 -Xloggc:$LOG_PATH/gc.log 已经把日志落盘,GC 日志显示,平均 20 小时一次 Full GC。
预期结果是频繁 Full GC 带来的停顿直接反映到业务响应时间上。内存水位高不是根因,配置畸形才是。
三、优化方案:堆降到 4GB,收集器换 G1
1. 先定参数,再动机器
为什么先改 JVM 再谈降配?因为降配目标是 4 核 8G,而 8G 机器装不下 8G 堆。只有把堆降下来,机器规格才有调整的余地。
怎么做?按下面的对照表逐项替换。不要只改 -Xmx 留下 -Xms,也不要保留任何 CMS 相关参数。
| 配置项 | 调整前 | 调整后 | 理由 |
|---|---|---|---|
| 堆内存 | -Xms8192m -Xmx8192m | -Xms4096m -Xmx4096m | 堆降到 4GB,给非堆和 OS 留出空间 |
| 新生代 | -XX:MaxNewSize=128m | 删除参数,交给 JVM 自动管理 | 128m 太小;自动管理约为堆的 1/3 |
| GC 收集器 | -XX:+UseConcMarkSweepGC | -XX:+UseG1GC | G1 更适合大堆与高吞吐场景 |
| 停顿目标 | 无 | -XX:MaxGCPauseMillis=200 | G1 的目标最大停顿时间 |
2. 调整后的启动参数
最终使用的关键参数是这几个。
-Xms4096m
-Xmx4096m
-XX:+UseG1GC
-XX:MaxGCPauseMillis=200
-XX:+HeapDumpOnOutOfMemoryError
-Xloggc:$LOG_PATH/gc.log
CMS 相关参数全部移除。G1 下不需要也不建议手动设置新生代大小,-XX:MaxNewSize 应当删除,否则会干扰 G1 的暂停预测模型。
还有一个容易忽略的点:-XX:MaxGCPauseMillis=200 是软目标。它让收集器按 200 毫秒去规划回收节奏,不是硬性保证。预期结果是单次停顿可控,而不是每次都不超过 200 毫秒。
3. 预期结果
堆降到 4GB 后,16GB 机器上非堆与 OS 仍占约 8GB,整机水位应从 99% 回落到 70% 左右。
新生代交给 JVM 自动管理,大约是堆的三分之一。临时对象能在 Eden 里正常消亡,晋升到老年代的数量明显减少。
Full GC 的频率随之下降,配合 G1 的停顿目标,业务 RT 的毛刺会收敛。这些预期需要在灰度阶段逐项验证,不能只看一条曲线。
四、灰度验证:先跑一台,再谈降配
1. 为什么必须灰度
参数变更同时影响内存、GC 和 RT。一次全量推开,出问题时分不清是参数、流量还是机器本身。灰度一台,等于给这次变更留一个可对照的样本。
怎么做?先拿 1 台实例替换启动参数,观察一周。这一周要覆盖完整的业务周期,包括高峰和跑批。
2. 三个验收指标
观察期只看三个指标,其他曲线作为辅助。
- 内存使用率是否从 99% 回落到 70% 左右的健康水位;
- GC 频率和耗时是否明显下降,尤其 Full GC 是否消失、单次停顿是否可控;
- 业务响应时间是否保持稳定。
三项都达标,才说明参数调整生效。如果内存水位降了但 Full GC 依旧频繁,要回头检查是否有大对象直接进入老年代。
3. 按批次推进降配
灰度通过后,再按批次推进降配。整条路径是 灰度 1 台 → 观察 7 天 → 分批降配。每批保留旧的启动参数和回滚脚本,出现异常时能在一台机器上快速还原。
预期结果是参数先落地、规格后调整,两步之间留出观察期。这样即使降配后出现问题,也能判断是 JVM 配置还是机器资源导致的。
常见错误与排错
- 现象:按 8G 规格直接起服务,进程秒退或几分钟后失联。原因:
-Xms8192m在启动瞬间锁定 8GB 堆,8G 机器没有内存留给操作系统,进程被 OOM Killer 杀掉。解法:先把堆降到-Xms4096m -Xmx4096m,再调整机器规格。 - 现象:切到 G1 后停顿目标形同虚设,Young GC 次数异常。原因:
-XX:MaxNewSize=128m还留着,手设新生代干扰了 G1 的暂停预测模型。解法:删除该参数,新生代交给 JVM 自动管理。 - 现象:参数改完内存水位还在高位,以为配置没生效。原因:只看水位没看 GC,老年代仍在被临时对象快速填满。解法:对比
-Xloggc日志里的 Full GC 间隔,确认老年代增长是否放缓。 - 现象:灰度机器正常,全量推开后部分实例 RT 抖动。原因:灰度时间太短,没覆盖业务高峰。解法:至少观察一周,覆盖完整业务周期后再按批次推进。
本篇小结
-Xms是硬承诺:只要它等于机器总内存的一大半,这台机器就没有降配的可能性。- 内存 99% 不一定是用得多,可能是配得差:新生代 128m 的畸形配置才是 Full GC 频繁的根因。
- 换 G1 要连带删参数:CMS 相关参数和
-XX:MaxNewSize都要清掉,否则新收集器跑不出预期。 - 先灰度一台,再按批次降配:一周观察期换来的是可回滚的节奏。