Spring Boot 整合 RabbitMQ 深度复盘:从 6 个疑问到生产级配置方案
接入 RabbitMQ,配置十分钟就能抄完。真上线时问题全在别处:2 台机器到底起了多少消费线程,
prefetch设成 1 有什么用,图片审核的 JSON 数组为什么一接就抛ClassCastException。这篇把 6 个疑问和结论整理成一套可复用模板。
本篇你能学到
- 用交换机加路由键解耦生产者和下游队列
- 算清
concurrency与prefetch对集群消费的影响 - 判断什么时候不该自定义消费线程池
- 用 15672 控制台确认消费者真的在监听
- 用原生
Message加TypeReference接住顶层 JSON 数组
一、概念:队列、交换机、路由键各管什么
1. 直接发队列会把上游锁死
直觉上,指定队列名发消息最简单。但生产者一旦写死所有下游队列的名字,耦合度就上来了:新增一个下游业务,必须改上游代码再发版。
这就是直接发队列的致命伤。队列是存储消息的驿站,生产者却要替所有驿站记地址,下游每加一个,上游就动一次。
2. 交换机按路由键分发
引入交换机之后,三个角色可以按快递物流系统来理解:队列是驿站,负责存消息;路由键是包裹上的地址标签;交换机是分拣中心。
生产者只把消息扔给交换机并贴上标签,交换机按路由键分发给所有订阅者,生产者和消费者就此解耦,也就是发布/订阅模式。
生产端要传的只有 exchange 和 routingKey,伪代码是 producer.send(exchange, routingKey, msg) -> binding 匹配 -> queue -> consumer。
预期结果:下游新增只需在交换机上多加一条绑定,上游代码零改动。消息到了消费端,确认时机同样关键,处理完再 ack 的写法在第四节展开。
配图
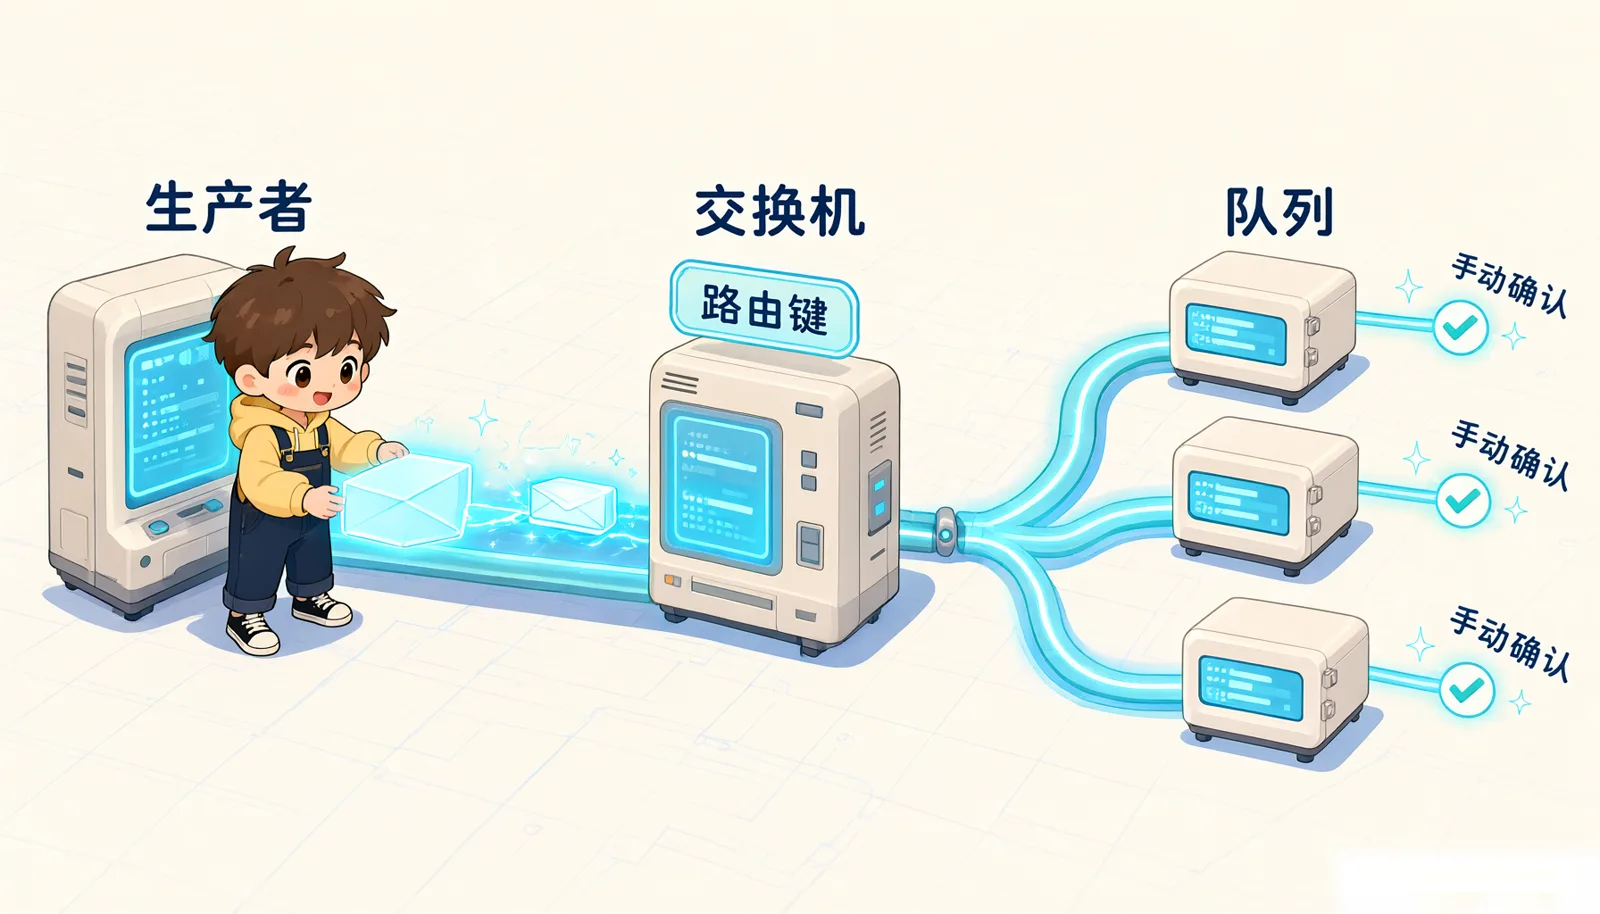
图 1:路由与手动确认,交换机按路由键分发,处理完再 ack
二、并发模型:线程数与预取
1. concurrency 是每个监听器的线程数
只有 2 台机器,是不是单线程消费,这是个常见误解。配置 concurrency: 5,Spring 会为每个 @RabbitListener 启动 5 个长驻阻塞线程。2 台机器、两个监听器,就是 20 个线程并发消费。
线程启动后阻塞等消息,处理完一条并 ACK 之后才拉取下一条。这个过程天然背压,队列里的消息不会一下子全灌进应用内存。线程总数可以按 总线程 = 机器数 × 监听器数 × concurrency 估算。
2. prefetch: 1 让集群能者多劳
prefetch: 1 限制每个线程每次只预取 1 条,处理完 ACK 才拉下一条。多节点集群里,快的机器自然多消费,慢的少拿,负载均衡是靠这个参数做出来的。
如果不限制,某台机器可能先抢一大批消息压在内存里慢慢处理,另一台闲着。消息没丢,但延迟和内存都难受。
3. 不要自定义线程池
Spring 默认使用 SimpleAsyncTaskExecutor,在 RabbitMQ 场景下表现为长驻阻塞线程。处理完一条、ACK 之后才拉下一条,天然背压,高效且不会 OOM。
不建议自定义 ThreadPoolTaskExecutor。自定义会让拉取线程和处理线程分离:拉取线程把 MQ 消息瞬间拉空、塞进自定义线程池的无界阻塞队列,极易引发 JVM 内存溢出,同时 ACK 机制也会失效。
预期结果:保持默认线程模型,消息激增时消费速率随线程数上去,应用内存曲线平稳。两种模型的差别看下图。
配图
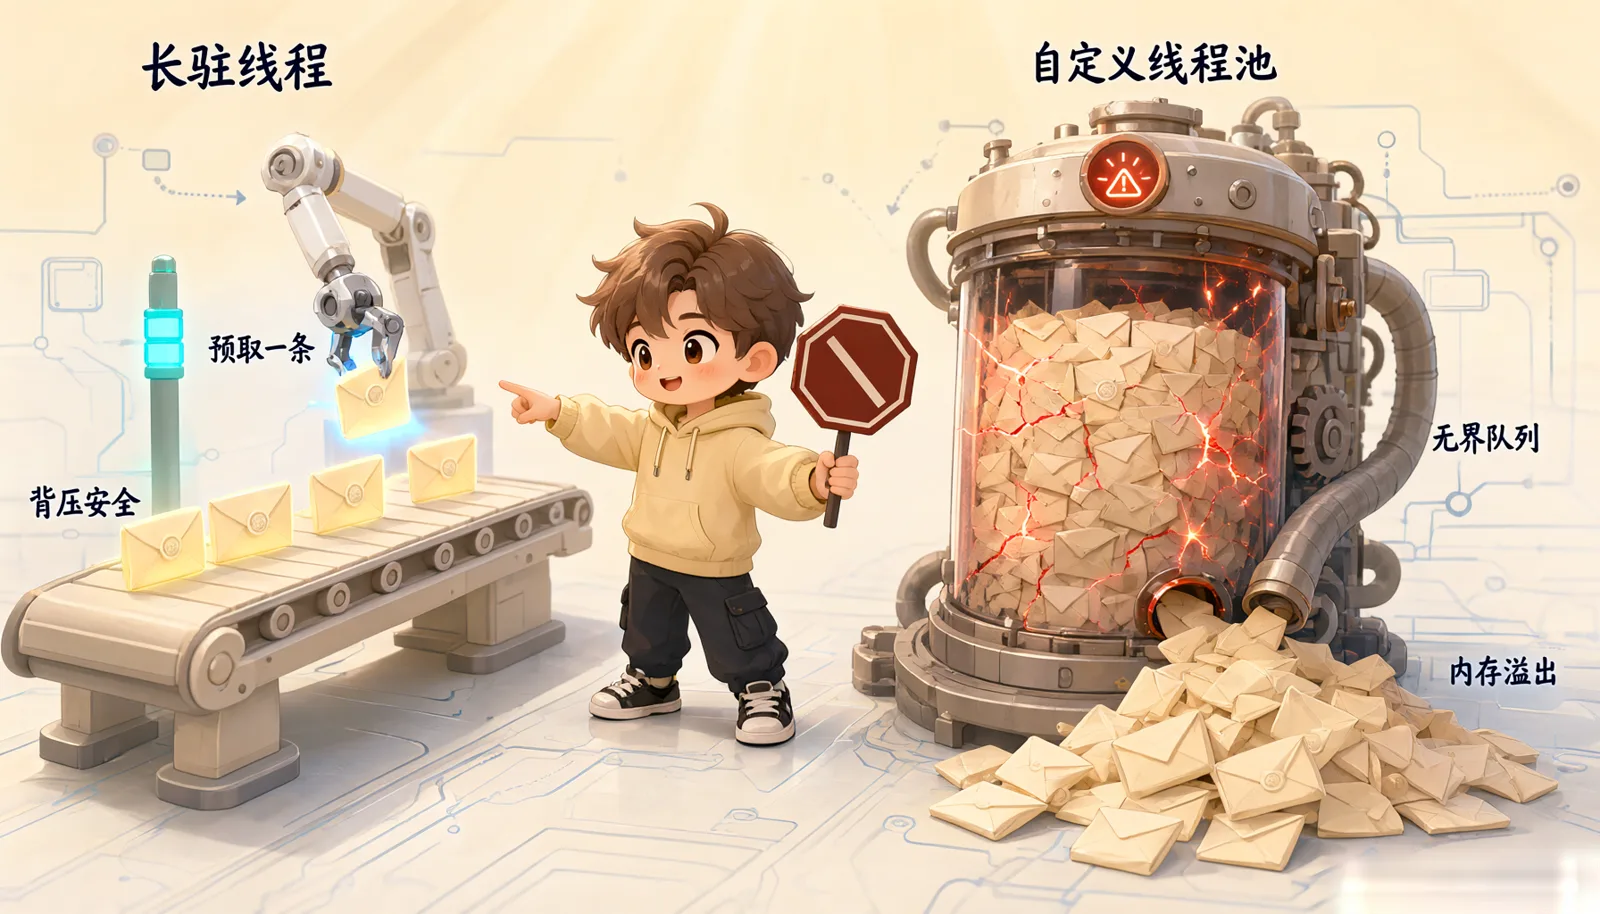
图 2:线程模型对比,长驻线程与自定义线程池,预取和队列的取舍
三、启动验证与动态队列名
1. Config 日志只能证明声明成功
启动后控制台没有监听成功的提示,心里没底,于是很多人在 RabbitMQConfig 里打日志。这个日志只能证明基础设施声明成功,相当于施工队把驿站建好了,不能证明快递员到岗上班。
实践结论是:Config 日志没报错,默认就是成功的。最权威的验证是登录 RabbitMQ Web 控制台(15672 端口),看对应队列的 Consumers 数量是否等于配置的并发总数,比如 2 台机器乘 5 线程等于 10。
也可以监听 Spring 的 ListenerContainerConsumerStartedEvent 事件,打印一条醒目的启动日志,适合做启动自检。
预期结果:控制台 Consumers 数量与预期一致,启动日志里能看到每个监听容器的启动事件。
2. SpEL 取队列名,代码不写死
@RabbitListener(queues = "#{@textFilterQueue.name}") 这串注解常让人犯迷糊。它是 Spring 的 SpEL 表达式:@textFilterQueue 去 IoC 容器里找对应的 Queue Bean,.name 取它真实的队列名。
好处是队列名不硬编码。application.yml 里的后缀怎么改,Java 代码都不用动,代码与配置就此解耦。
预期结果:改配置里的队列后缀,重启后监听自动落到新队列,代码零改动。
四、反序列化陷阱与生产级配置模板
1. 顶层 JSON 数组不能用 List<T> 直接接
外部推送的图片审核消息是 JSON 数组,直接用 List<T> 接收会报错。
原因是 Spring 默认的 Jackson2JsonMessageConverter 处理顶层 JSON 数组时泛型被擦除,元素被解析成 List<LinkedHashMap>,后续调用实体方法就抛 ClassCastException。
解法是用原生 org.springframework.amqp.core.Message 接消息体,再用 ObjectMapper 加 TypeReference 手动反序列化,泛型信息由 TypeReference 显式带上。
预期结果:数组消息能正确转成 List<CommonMessage>,不再出现 LinkedHashMap 强转失败。
2. 三份可直接复用的配置
下面这套剥离了具体业务,可以直接搬到其他项目。先是 application.yml:
spring:
  rabbitmq:
    host: 127.0.0.1
    port: 5672
    username: guest
    password: guest
    virtual-host: /
    listener:
      simple:
        acknowledge-mode: manual  # 【底线】开启手动确认,防止消息丢失

        # 【Spring 自动线程池机制说明】:
        # Spring 底层会自动创建并管理"长驻消费者线程",无需开发者手动配置 ThreadPoolTaskExecutor。
        # 线程启动后会阻塞等待消息,处理完一条并 ACK 后才会拉取下一条,不会导致内存溢出。

        concurrency: 5            # 初始长驻线程数:每个 @RabbitListener 启动 5 个线程
        max-concurrency: 10       # 最大长驻线程数:消息激增时的扩容上限
        prefetch: 1               # 【核心】每次只预取1条,保证多节点集群的完美负载均衡

# 自定义动态后缀配置(用于演示动态队列名)
app:
  mq:
    suffix: "v1"
acknowledge-mode: manual 是底线,配合代码里的 basicAck 和 basicNack 才是完整的手动确认。max-concurrency: 10 给消息激增留了扩容上限,prefetch: 1 保证负载均衡。
第二个文件是配置类,负责声明队列、交换机、绑定和消息转换器:
@Slf4j
@Configuration
public class RabbitMQConfig {

    // ================= 通用通道配置 =================
    @Bean
    public Queue commonQueue(@Value("${app.mq.suffix}") String suffix) {
        String name = "biz_common_queue_" + suffix;
        log.info("[声明] 通用队列: {}", name); // 证明声明成功
        return new Queue(name, true);
    }

    @Bean
    public DirectExchange commonExchange(@Value("${app.mq.suffix}") String suffix) {
        return new DirectExchange("biz_common_exchange_" + suffix, true, false);
    }

    @Bean
    public Binding commonBinding(Queue commonQueue, DirectExchange commonExchange,
                                 @Value("${app.mq.suffix}") String suffix) {
        return BindingBuilder.bind(commonQueue).to(commonExchange)
                .with("biz_common_routkey_" + suffix);
    }

    // ================= 消息转换器 =================
    @Bean
    public MessageConverter jsonMessageConverter() {
        return new Jackson2JsonMessageConverter();
    }

    @Bean
    public RabbitTemplate rabbitTemplate(ConnectionFactory connectionFactory,
                                         MessageConverter jsonMessageConverter) {
        RabbitTemplate template = new RabbitTemplate(connectionFactory);
        template.setMessageConverter(jsonMessageConverter);
        return template;
    }
}
三个 Bean 覆盖队列、交换机、绑定,队列名统一由 ${app.mq.suffix} 拼出来。RabbitTemplate 显式装配同一个 Jackson2JsonMessageConverter,避免生产端和消费端序列化方式不一致。
第三个文件是消费者,两种场景的写法都在这:
@Slf4j
@Component
@RequiredArgsConstructor
public class MessageConsumer {

    private final ObjectMapper objectMapper;

    // 场景 1:普通 JSON 对象
    // 利用 SpEL 表达式动态获取队列名,框架自动反序列化
    @RabbitListener(queues = "#{@commonQueue.name}")
    public void receiveObjectMessage(CommonMessage message, Channel channel,
                                     @Header(AmqpHeaders.DELIVERY_TAG) long deliveryTag) throws IOException {
        try {
            log.info("接收到对象消息 -> id: {}", message.getId());
            // TODO: 业务处理
            channel.basicAck(deliveryTag, false); // 成功手动 ACK
        } catch (Exception e) {
            log.error("处理异常", e);
            channel.basicNack(deliveryTag, false, true); // 异常拒绝,重新入队
        }
    }

    // 场景 2:JSON 数组
    // 必须使用原生 Message 接收并手动反序列化,防止泛型擦除
    @RabbitListener(queues = "#{@batchQueue.name}") // 假设有 batchQueue
    public void receiveArrayMessage(org.springframework.amqp.core.Message amqpMessage, Channel channel,
                                    @Header(AmqpHeaders.DELIVERY_TAG) long deliveryTag) throws IOException {
        try {
            // 手动精准反序列化为 List
            List<CommonMessage> messages = objectMapper.readValue(
                    amqpMessage.getBody(), new TypeReference<List<CommonMessage>>() {});

            log.info("接收到数组消息,共 {} 条", messages.size());
            // TODO: 遍历处理
            channel.basicAck(deliveryTag, false);
        } catch (Exception e) {
            log.error("数组处理异常", e);
            channel.basicNack(deliveryTag, false, true);
        }
    }
}
两个场景的差异要记牢。普通对象靠框架自动反序列化,成功 basicAck、异常 basicNack 重新入队;数组消息用原生 Message 接收,手动 readValue。业务逻辑必须包在 try-catch 里,否则异常会绕过 ack 逻辑。
预期结果:三个文件放进新项目,改掉 app.mq.suffix 就能跑通收发,消息处理完才从队列移除。
3. 六个疑问的结论速查
| 疑问 | 一句话结论 |
|---|---|
| 为什么要有交换机 | 解耦生产者与消费者,下游增减无需改上游 |
| concurrency / prefetch | 每监听器 N 个长驻线程;prefetch=1 实现集群能者多劳 |
| 能否自定义线程池 | 不要,会破坏原生背压导致 OOM |
| 如何确认监听成功 | 15672 控制台看 Consumers 数,或监听 StartedEvent |
#{@queue.name} | SpEL 从容器取 Bean,队列名与代码解耦 |
| JSON 数组接收 | 泛型擦除坑,用原生 Message + TypeReference 手动反序列化 |
常见错误与排错
现象:启动无报错,控制台里队列的
Consumers一直是 0。原因:SpEL 里的 Bean 名写错,或队列后缀配置与声明不一致,监听容器没绑上队列。解法:核对#{@commonQueue.name}中的 Bean 名,再看 15672 的Queues页面有没有同名队列。现象:一条坏消息被反复消费,日志刷屏。原因:
basicNack(deliveryTag, false, true)无条件重新入队,必然失败的消息形成死循环。解法:捕获异常后记录消息体,按失败次数决定重新入队还是落库人工处理。现象:图片审核消息抛
ClassCastException,提示LinkedHashMap无法强转。原因:顶层 JSON 数组被Jackson2JsonMessageConverter按泛型擦除解析。解法:方法参数改成原生Message,用objectMapper.readValue(body, new TypeReference<List<CommonMessage>>() {})手动反序列化。现象:消息量一大,应用内存飙升甚至 OOM,ACK 也不生效。原因:注入了自定义
ThreadPoolTaskExecutor,拉取线程瞬间把队列拉空塞进无界队列。解法:移除自定义线程池,恢复默认长驻线程,配prefetch: 1。
本篇小结
- 交换机按路由键分发,生产者不该写死下游队列名。
concurrency是每个监听器的长驻线程数,2 台机器乘 5 就是 10 个消费者。prefetch: 1是集群负载均衡的关键,处理完再 ack 才有背压。- 手动确认是消息不丢的底线,成功
basicAck、失败basicNack。 - 顶层 JSON 数组用原生
Message加TypeReference接,绕开泛型擦除。