股友圈 Agent Skill:需求、设计与实现
用户在 Agent 里问一句「白酒圈最近在聊什么」,背后要跨知识库和持仓接口两条通道。这篇拆解股友圈 Skill 从 60 个问句到 3 个子命令的收敛过程,以及 CLI 与提示词层怎么分工。
本篇你能学到
- 用问句驱动的方法收敛 Skill 的能力边界
- 判断哪些数据走知识库检索、哪些走业务接口
- 用 SKILL.md 约束 Agent 的触发、调用链与筛选偏好
- 设计统一错误形态,让 Agent 只解析一种错误
- 用
X-Request-ID与限流错误码做调用追踪
一、定位与架构:两条数据通道
1. 股友圈与 Skill 的定位
股友圈是券商 APP 内的投资社区:用户围绕投资主题组成圈子,在圈内发帖讨论、分享持仓、晒策略操作。股友圈 Skill 解决的问题是,让本地 Agent 具备读取社区数据的能力,按自然语言问句发现相关圈子、召回圈内热点内容、查询指定圈子的授权聚合持仓。
这里有个边界要先说清:Skill 不生产观点,只提供事实数据。后端不输出投资建议、不判断买卖方向、不暴露未授权用户隐私;所有有观点的表达(摘要、解读、提示)都由 Agent 完成。
2. 双通道架构
架构遵循一条核心原则:数据通道只出事实数据,Agent 负责理解与表达。
用户自然语言提问
      │
      ▼
本地 Agent(LLM)
   · 触发判断 → 查询构造(受 SKILL.md 提示词约束)
   · 召回结果筛选与组织、事实摘要、风险提示
      │
      ▼
Skill 调用层(CLI:python scripts/get_data.py)
      │
      ├── 知识库检索通道 ──► 圈子档案集合 / 圈子内容集合
      │     (语义检索:question + top_k)
      │
      └── 业务接口通道 ──► 授权聚合持仓服务
            (结构化查询:circle_id)
两条通道的分工很明确:表达自由度高、结构弱的数据走知识库语义检索(圈子档案、帖子内容),天然支持模糊问句;精确的授权聚合统计走业务接口(圈内热门持仓),保证口径与时效可控。
配图
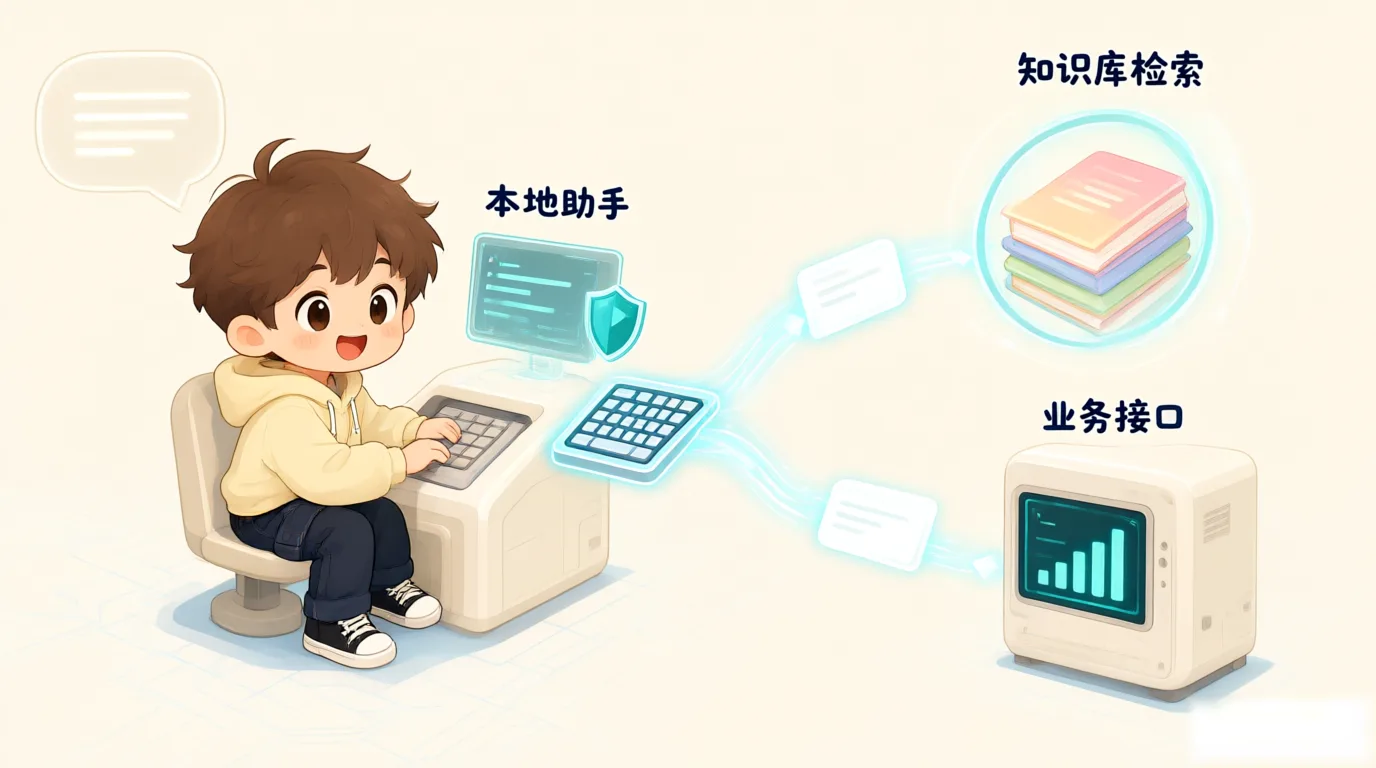
图 1:知识库与业务接口双通道,静态知识走检索,实时数据走接口
上图里,知识库通道接的是静态档案与内容,业务接口通道接的是实时聚合持仓。两条线在 Skill 调用层汇合,对 Agent 暴露成同一套 CLI 子命令,Agent 不需要知道数据来自哪条通道。
预期结果是 Agent 只面对 3 个子命令,不用理解底层两套协议。两条通道各自演进,只要 CLI 契约不变,Agent 侧无需改动。
3. 能力总览
| # | 能力 | 功能说明 | 子命令 | 数据通道 |
|---|---|---|---|---|
| 1 | 搜索圈子 | 按自然语言问句语义检索相关圈子 | search_circle | 知识库(圈子档案集合) |
| 2 | 圈子热点内容 | 按问句语义检索圈内热门话题/帖子 | hot_posts | 知识库(圈子内容集合) |
| 3 | 圈子热门持仓 | 查询指定圈子的授权聚合持仓排行 | hot_holdings | 业务接口(聚合持仓服务) |
3 个能力对应 3 个子命令,每个子命令只绑定一条通道。这种一一对应关系是后面错误处理和限流设计的基础,排查时看到子命令就知道该找哪条链路。
4. 数据通道的边界
| 数据域 | 通道 | 内容 | 时效口径 |
|---|---|---|---|
| 圈子档案集合 | 知识库检索 | 圈子名称、简介、成员规模、圈子 ID(circle_id) | 随知识库更新 |
| 圈子内容集合 | 知识库检索 | 热门帖子/话题正文、投票信息、发布时间 | 随知识库更新 |
| 授权聚合持仓 | 业务接口 | 股票代码/名称/市场/持仓人数 | T-1 日频(dt / tradeDate) |
通道选择的逻辑:圈子与内容属于非结构化、表达自由度高的数据(用户问法无法枚举),语义检索以 question 直接承接自然语言,召回由知识库平台完成。
持仓属于精确统计数据(口径、排序、授权链路要求明确),走结构化业务接口,入参只有一个 circle_id,按持仓人数排序返回。
这样一来,每条数据都有唯一通道,不存在同一份数据两条路都能取的情况。口径只有一个,排查时也不会出现两边数字对不上却不知道信谁。
二、需求分析:60 个问句如何收敛成 3 个命令
1. 问句驱动:先收问句,不列功能
需求收集不做功能清单,而是直接收集用户可能提出的问句。归纳为 3 大场景(信息发现、决策辅助、社交互动)共 12 类约 60 个问句。
问句驱动的好处是需求颗粒度足够细,每一类问句都能明确指向它需要的底层数据与实现方式。功能清单容易写成「支持圈子搜索」,问句则会写成「半导体有哪些圈子」,后者直接决定检索参数怎么传。
2. 需求矩阵:12 类问句落到 3 类数据
| 场景 | 需求类别 | 代表性问句 | 底层数据 | 实现方式 |
|---|---|---|---|---|
| 信息发现 | 圈子发现 | "有哪些热门投资圈子?" | 圈子档案(名称、简介、规模) | search_circle |
| 信息发现 | 主题圈子检索 | "半导体有哪些圈子?" | 圈子档案 | search_circle |
| 信息发现 | 新兴主题追踪 | "最近哪些新圈子火了?" | 圈子档案 + 内容热度 | search_circle + Agent 筛选 |
| 决策辅助 | 热点内容获取 | "XX 圈子今天在讨论什么?" | 圈子内容(帖子、话题) | hot_posts |
| 决策辅助 | 内容筛选 | "圈内最近一个月的热帖?" | 圈子内容(含时间、投票) | hot_posts + Agent 筛选 |
| 决策辅助 | 共识提取 | "这个圈子的主流观点是什么?" | 圈子内容 | hot_posts + Agent 摘要 |
| 社交互动 | 持仓洞察 | "白酒圈最热门的持仓是啥?" | 授权聚合持仓 | search_circle → hot_holdings |
| 社交互动 | 持仓对比 | "科技圈和医药圈都在买什么?" | 授权聚合持仓 | Agent 多次调用对比 |
| 社交互动 | 调仓方向 | "XX 圈子大家最近在买什么?" | 授权聚合持仓 | hot_holdings(T-1 口径) |
| 数据分析 | 内容统计 | "圈内讨论最多的股票是哪几只?" | 圈子内容 | hot_posts + Agent 统计 |
| 数据分析 | 舆情倾向 | "圈子情绪偏乐观还是悲观?" | 圈子内容 | hot_posts + Agent 分析 |
| 风险预警 | 持仓异动监控 | "XX 圈持仓排名变了要提醒我" | 授权聚合持仓 | Agent 轮询 hot_holdings |
矩阵里最右列不是接口名,而是实现方式。有些需求标着 search_circle + Agent 筛选,说明一次检索不够,还要 Agent 做二次判断;这类需求不应该倒逼后端加参数。
3. 归并原则:三条规则
60 个问句归并下来只有三条规则:
- 原子数据高度重合:12 类需求落在三类底层数据上,圈子档案、圈子内容、授权聚合持仓。对应用户侧只有 3 个查询能力;语义检索天然兼容问法的千变万化(同一能力覆盖「热门圈子/新圈子/半导体圈子」等不同问法);
- 分析类需求由 Agent 组合实现:情绪倾向、观点共识、内容统计、持仓对比等,不单独设接口,由 Agent 基于召回内容二次分析;
- 监控预警类由 Agent 轮询实现:异动提醒不设推送接口,由 Agent 按需轮询查询能力并自行判断变化。
预期结果是需求评审时能明确回答「这个需求加不加接口」。落在三类原子数据内的,加检索条件;需要观点和统计的,交给 Agent;需要持续观察的,交给轮询。最终只保留 search_circle、hot_posts、hot_holdings 三个子命令,后面所有的复杂度才有上限。
三、职责边界:数据通道、提示词层与知识库
1. 职责分工:通道出事实,Agent 做表达
| 用户意图 | 数据通道 | 通道职责 | Agent 职责 |
|---|---|---|---|
| 搜索圈子 | 知识库检索 | 按问句语义召回圈子档案(含圈子 ID) | 问句构造;按相似度筛选结果;未指定数量时取相关度最高 3 条 |
| 圈子热点内容 | 知识库检索 | 按问句语义召回帖子/话题正文 | 时间与投票筛选;事实摘要;不扩展未验证结论 |
| 圈子热门持仓 | 业务接口 | 返回授权用户的聚合持仓统计 | 引导两步调用(先取圈子 ID);提示数据口径与风险 |
这张表把谁负责什么写死了。通道只返回数据和字段,筛选、摘要、风险提示都由 Agent 完成。同一条数据因此可以被不同问法复用,后端不需要为每种问法准备一套返回结构。
2. 合规与隐私:四条硬约束
- 授权聚合口径:持仓数据仅返回股票维度的聚合人数(holdNum),不含任何账户、仓位与收益明细,不涉及个人身份信息;
- 数据时效透明:持仓结果携带 dt(数据日期)与 tradeDate(交易日期),Agent 在输出时向用户说明 T-1 快照口径;
- 不输出投资建议:数据通道只出事实数据;观点表达(摘要、解读、提示)全部由 Agent 完成,并附「数据基于授权聚合统计,不构成投资建议」的风险提示;
- 反编造约束:SKILL.md 明确要求 Agent 任何情况下都实际调用 Skill 查询,不依赖训练知识编造圈子名称、帖子内容或持仓数据。
这四条分别对应数据边界、表达边界、合规边界和行为边界。四条都落在接口契约与提示词里,不能只靠开发口头约定,否则换一个 Agent 实现就会失守。
3. 提示词层:四类行为约束
行为约束不下沉到接口,而是集中在提示词层(SKILL.md)下发,共四类:
- 触发条件:用户问句涉及「股友圈」「圈子」「社区热点」等字眼时触发,并给出示例问句(「股友圈有哪些半导体圈子」「XX 圈子里在讨论什么」「这个圈子热门持仓股票有哪些」)帮助模型对齐触发语义;
- 反编造约束:任何情况下实际调用查询,不依赖训练知识回答圈子、帖子、持仓的具体信息;
- 调用链指引:查询持仓前,先用
search_circle找到目标圈子及其circle_id(取整数部分),再调用hot_holdings; - 结果默认值与筛选逻辑:用户未明确要求返回数量时,优先返回相关度最高的 3 条;热点内容优先返回近一个月内的、有投票的优先筛选投票数较多的。这类模糊偏好不进接口参数,由提示词约束 Agent 在召回结果上执行。
这是接口做薄、提示词做厚的直接体现:接口只承接确定性的结构(问句、数量、ID),所有柔性偏好都留在端侧。预期结果是新增一条筛选偏好时只改 SKILL.md,不用发版改接口。
4. 知识库建设:带着 schema 建集合
知识库平台承载两个在线检索集合,是圈子搜索与内容查询的主通道:
| 集合 | 主要内容 | 检索元数据 | 角色 |
|---|---|---|---|
| 圈子档案集合 | 圈子名称、简介、成员规模、圈子 ID | docnm_kwd、doc_id、chunk_id | 在线检索 |
| 圈子内容集合 | 热门帖子/话题正文、投票、发布时间 | 同上,另含 title、url(可为空) | 在线检索 |
每个集合按结构化元数据规范建设(文档名、文档/知识块 ID、原始链接、标题),支撑语义检索与溯源定位。知识库不是把文档扔进去,而是带着检索 schema 建设的。
此外,规则约束、产品说明、解读口径等集合以端侧知识形式注入 Agent 语境,用于约束输出风格与合规边界。这样每条召回结果都能回溯到文档和知识块,Agent 引用时有据可查。
四、接口协议:三个子命令与统一错误
1. 调用入口与环境准备
命令入口:
python scripts/get_data.py <子命令> [参数...]环境要求:
- Python 3 与
requests库; - API Key 通过环境变量注入(本文以 SKILL_API_KEY 指代,部署环境按实际变量名配置)。未设置时脚本直接报错退出,提示到 Skill 开放平台获取;
- 请求超时 60 秒。
请求头约定(所有请求):
| 请求头 | 说明 |
|---|---|
X-API-Key | Skill 接入凭证,用于识别与限流 |
X-Skill-ID | Skill 标识(guyouquan-query) |
X-Request-ID | 每次调用生成的 UUID,用于链路追踪 |
Authorization: Bearer | 知识库通道附加访问令牌(随 Skill 配置分发,建议外置到环境变量管理并定期轮换) |
输出约定:成功时 stdout 打印 JSON(知识库通道为 records 数组、业务通道为 results 数组);失败时 stderr 打印 {"error": "..."} 并以退出码 1 结束。
预期结果是本地装好 Python 3 和 requests、配好环境变量后,一条命令就能跑通。密钥不进代码,轮换时只改环境变量。
2. search_circle:语义搜索圈子
根据自然语言问句,语义检索相关的股友圈子(某行业、概念、股票对应的圈子)。
请求参数:
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
--question | string | 是 | 用户问题,如「半导体有哪些热门圈子」 |
--top_k | int | 是 | 召回数量,最大 20 |
底层协议:POST {skill-host}/restapi/guyouquan/e-server-transfer-service/dify/retrieval,请求体为知识库检索标准结构:
{
  "knowledge_id": "<圈子档案集合 ID,由配置指定>",
  "query": "半导体有哪些热门圈子",
  "retrieval_setting": { "top_k": 10, "score_threshold": 0.1 }
}
返回结构(stdout 输出 records[],每个元素为 total + chunks[] 结构):
| 字段 | 说明 |
|---|---|
total | 命中结果数量(每条记录的顶层字段) |
content_with_weight | 检索到的圈子正文,主要可用信息(含圈子 ID,供后续持仓查询) |
docnm_kwd | 文档名称 |
similarity / vector_similarity / term_similarity | 综合 / 向量 / 关键词相似度,可用于筛选可信结果 |
chunk_id / doc_id | 知识块 ID / 文档 ID |
url / title | 原始链接 / 标题(可能为空) |
调用示例:
python scripts/get_data.py search_circle --question "半导体有哪些热门圈子" --top_k 10[
{
"total": 3,
"chunks": [
{
"chunk_id": "chunk-020817",
"doc_id": "doc-000118",
"content_with_weight": "半导体观察(圈子ID:118):跟踪半导体产业链上下游,当前成员 4120 人,聚焦设备、材料与设计环节…",
"docnm_kwd": "半导体观察",
"similarity": 0.86,
"vector_similarity": 0.83,
"term_similarity": 0.89,
"title": "",
"url": ""
}
]
}
]约定:用户未明确要求返回数量时,优先返回相关度最高的 3 条内容。
调用成功后,stdout 拿到 records 数组,content_with_weight 里带圈子 ID。这个 ID 取整数部分,就是下一步 hot_holdings 的入参。
3. hot_posts:圈子热点内容
根据自然语言问句,语义检索圈子内的热门话题/帖子内容。
请求参数:
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
--question | string | 是 | 用户问题,如「今天股友圈都在聊什么」 |
--top_k | int | 是 | 召回数量,最大 20 |
底层协议:与 search_circle 同一检索接口,knowledge_id 指向圈子内容集合;请求体结构相同。
返回结构:与 search_circle 相同的 total/chunks[] 结构,content_with_weight 为帖子/话题正文。
调用示例:
python scripts/get_data.py hot_posts --question "今天半导体相关圈子都在聊什么" --top_k 10筛选约定(提示词层执行):优先返回近一个月内的内容;如果有投票,优先筛选投票数较多的内容。
拿到的是帖子正文和时间,时间与投票的二次筛选在 Agent 侧完成。接口不提供时间范围和投票排序参数,这两条偏好只存在于 SKILL.md。
4. hot_holdings:圈子热门持仓
查询指定圈子的热门持仓股票列表(授权用户聚合口径)。
请求参数:
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
--circle_id | int | 是 | 圈子 ID,需先通过 search_circle 获取(取整数部分) |
底层协议:POST {skill-host}/restapi/guyouquan/follow-svc/option/stockFriendCircle/queryHotStock,请求体:
{
  "channel": "<渠道标识>",
  "requestId": "<每次调用生成的 UUID>",
  "body": { "circleId": 118, "sortType": "1" }
}按持仓人数排序(sortType=1)。
返回结构(stdout 输出 results[]):
| 字段 | 说明 |
|---|---|
stockCode / stockName | 股票代码 / 名称 |
market | 市场标识,如 SZ、SH |
holdNum | 持仓人数(授权聚合口径) |
dt | 数据日期 |
tradeDate | 交易日期 |
rzrqFlag | 保留标识,无业务含义 |
调用示例:
# 第一步:搜索圈子获取 circle_id
python scripts/get_data.py search_circle --question "白酒有哪些圈子" --top_k 3
# 第二步:按圈子 ID 查询热门持仓
python scripts/get_data.py hot_holdings --circle_id 118[
{ "stockCode": "600519", "stockName": "贵州茅台", "market": "SH", "holdNum": 1834, "dt": "2026-05-01", "tradeDate": "2026-04-30", "rzrqFlag": "0" },
{ "stockCode": "000858", "stockName": "五粮液", "market": "SZ", "holdNum": 1456, "dt": "2026-05-01", "tradeDate": "2026-04-30", "rzrqFlag": "0" }
]返回的 results 按 holdNum 倒序,携带 dt 与 tradeDate。Agent 输出时必须把 T-1 口径讲清楚,不能让用户以为是实时持仓。
5. 错误处理与限流:只暴露一种错误形态
所有错误(含 CLI 参数错误、网络错误、HTTP 错误、业务错误)统一转换为 stderr 输出 {"error": "..."} 加退出码 1,Agent 只需解析一种错误形态。
| HTTP 状态 | 触发条件 | 错误信息 |
|---|---|---|
| 401 | API Key 缺失 | "缺少 API Key。" |
| 403 | API Key 无效或无权限 | "API Key 无效或没有权限。" |
429 + error_code=RATE_LIMIT_EXCEEDED | 调用频率超限 | "接口调用频率超限。" |
429 + error_code=DAILY_QUOTA_EXCEEDED | 当日配额用尽 | "今日调用次数已达上限。" |
| 429(其他) | 未知限流 | "请求超过限制。" |
| 503 | 服务不可用 | "服务暂时不可用,请稍后重试。" |
| 其他 | 响应异常 | 按 HTTP 标准状态码抛出 |
业务层校验:响应 status 非 1 或 msg 非空时,msg 作为错误信息抛出。CLI 层面,参数缺失、取值非法等由解析器直接转为统一错误形态;各子命令的参数说明可通过 -h 查看。
Agent 处理建议:频率超限按指数退避重试;每日配额用尽直接告知用户;参数错误参考 -h 修正后重试。
这样 Agent 侧只需要一个错误分支:读 error 字段、看退出码。两类限流错误码分开,重试策略才能不同,RATE_LIMIT_EXCEEDED 可以退避重试,DAILY_QUOTA_EXCEEDED 重试也没用。
6. 应用场景速查
| 用户问法 | 调用方式 |
|---|---|
| "股友圈有哪些半导体圈子?" | search_circle --question "半导体有哪些热门圈子" --top_k 3 |
| "最近什么主题的圈子火?" | search_circle --question "最近热门的投资圈子" --top_k 10 |
| "今天股友圈都在聊什么?" | hot_posts --question "今天股友圈都在聊什么" --top_k 10 |
| "半导体圈子最近一个月聊了啥?" | hot_posts --question "半导体圈子最近一个月的热门帖子" --top_k 10(时间与投票筛选由 Agent 执行) |
| "白酒圈最热门的持仓是啥?" | 先 search_circle --question "白酒有哪些圈子" --top_k 3,再 hot_holdings --circle_id <ID> |
| "科技圈和医药圈都在买什么?" | Agent 分别查询两个圈子持仓后对比组织 |
| "白酒圈持仓排名变了提醒我" | Agent 轮询 hot_holdings 并自行判断排名变化 |
这张表可以直接贴进 SKILL.md 的示例区。左边是用户问法,右边是命令模板,Agent 触发后照抄参数即可。常见问法都有确定命令,模型自由发挥的空间就被压小了。
常见错误与排错
- 现象:Agent 不调用 Skill,直接用训练知识回答圈子信息。原因:SKILL.md 的触发条件或反编造约束缺失,模型走了默认回答路径。解法:补触发词与示例问句,明确要求任何情况下先查询再回答。
- 现象:
hot_holdings报圈子不存在。原因:把search_circle返回的圈子 ID 连同前缀一起传入,没有取整数部分。解法:提示词层固定要求取circle_id的整数部分,再调用持仓接口。 - 现象:请求返回 401 或 403,但同一 Key 手工调用正常。原因:环境变量 SKILL_API_KEY 未注入 Agent 进程,或 Key 没有该 Skill 权限。解法:先确认环境变量在 Agent 进程里可见,再核对 Key 的权限范围。
- 现象:频繁 429,但当天调用量并不高。原因:只按总配额排查,忽略了频率限制;两类错误码混在一起处理。解法:看
error_code区分 RATE_LIMIT_EXCEEDED 与 DAILY_QUOTA_EXCEEDED,前者退避重试,后者停止调用。 - 现象:用户问「最近一个月的热帖」,返回结果却跨了几个月。原因:时间筛选被误以为在接口侧,实际要由 Agent 在召回结果上执行。解法:在 SKILL.md 里保留这条筛选约定,并在输出前检查发布时间。
本篇小结
- 双通道由数据形态决定:非结构化走知识库检索,精确统计走业务接口。
- 接口做薄,提示词做厚:接口只承接问句、数量、ID,柔性偏好留在 SKILL.md。
- 两步调用链靠 circle_id 闭环:search_circle 召回 ID,hot_holdings 精确消费。
- 所有错误统一成 {"error": "..."} 加退出码 1,端侧只解析一种形态。
- X-Request-ID 与两类限流错误码,让链路可追踪、重试可区分。