PostgreSQL 复合索引失效分析:索引明明建了,为什么查询还在全量排序?
一条社区动态列表的查询,索引建得看起来没问题,执行计划里却赫然出现一个
Sort节点,单步耗时 2.2 秒。返回只有 684 行,数据库却先排了 33 万行。这篇记录完整的定位过程,以及复合索引列序背后的 B-Tree 原理。
本篇你能学到
- 从执行计划的
Sort节点判断索引有没有提供有序性 - 用「等值、排序、范围」的顺序给复合索引排列表
- 理解排序字段本身带范围条件,为什么仍能放在范围过滤字段之前
- 用
CREATE INDEX CONCURRENTLY在线换索引,并处理 INVALID 索引 - 一套可复用的列序判断表,下次建索引直接套
一、现象:684 行结果,2.2 秒排序
1. 问题 SQL 与业务语义
先看查询本身。这是一条社区动态列表的分页查询,带一次与股票明细表的连接。
SELECT
    t1.trending_id   AS trendingId,
    t1.trending_type AS trendingType,
    t1.release_time  AS releaseTime,
    tis.secu_code
FROM t_stock_friend_circle_trending_index t1
INNER JOIN t_sfc_trending_index_stock tis
    ON tis.trending_id = t1.trending_id
WHERE t1.circle_id = 129
  AND t1.del = '0'
  AND t1.trending_type IN (3, 4, 5)
  AND t1.release_time < CAST('2026-03-18 08:37:02.000' AS TIMESTAMP)
业务语义是:查询某圈子下、指定动态类型、指定时间之前的动态,按 release_time 倒序取最新的若干条。
2. 当时的索引
表上原本有这样一个索引。
CREATE INDEX idx_stock_friend_circle_trending_index_release_order
ON public.t_stock_friend_circle_trending_index (
        circle_id,
        del,
        trending_type,
        release_time DESC
);
直觉上这个索引设计得很标准:等值字段在前、范围字段在后,排序方向也和 ORDER BY 一致。但它失效了。
3. 执行计划里的证据
为什么判断是索引的问题?因为执行计划里出现了排序节点,而这条查询的排序字段本来就在索引里。
->  Sort  (cost=525679.88..526459.81 rows=311972 width=25)
    (actual time=2210.691..2210.768 rows=684 loops=3)
      Sort Key: t1.release_time DESC
      Sort Method: quicksort  Memory: 42346kB
      ->  Parallel Bitmap Heap Scan on t_stock_friend_circle_trending_index t1 ...
            Recheck Cond: (... AND (trending_type = ANY ('{3,4,5}'::numeric[])) ...)
执行计划说明了一切。出现了 Sort 节点,Sort Method: quicksort Memory: 42346kB,数据库把符合条件的约 33 万行数据放进内存里做排序。
实际返回只有 684 行,却先排序了海量数据,单步耗时约 2.2 秒。
预期结果:问题锁定在排序,不在连接,也不在扫描。接下来要回答的是,索引里明明有 release_time,为什么没能提供顺序。
二、定位:IN 打断了 release_time 的有序性
1. 复合索引在磁盘上怎么排
索引能否避免排序,PostgreSQL 中即避免 Sort 节点,MySQL 中即避免 filesort,取决于索引的物理存储顺序能否直接满足全局排序的要求。
复合索引 (A, B, C) 的数据在磁盘上是这么排的。
- 先按 A 排好序;
- 在 A 相同的情况下,按 B 排好序;
- 在 A 和 B 都相同的情况下,按 C 排好序。
关键点在于:只有当前面的字段处于等值查询时,后面的字段才是全局有序的。一旦前面的字段是范围查询,比如 IN、<、>,后面字段的顺序就会在不同范围值之间被打乱。
2. 旧索引的物理样子
旧索引 (circle_id, del, trending_type, release_time) 中,数据在索引里的物理排列简化后是这样。
| 行号 | circle_id | del | trending_type | release_time |
|---|---|---|---|---|
| 1 | 129 | 0 | 3 | 10:00 |
| 2 | 129 | 0 | 3 | 09:00 |
| 3 | 129 | 0 | 3 | 08:00 |
| 4 | 129 | 0 | 4 | 10:05 |
| 5 | 129 | 0 | 4 | 09:30 |
| 6 | 129 | 0 | 4 | 08:30 |
| 7 | 129 | 0 | 5 | 10:02 |
| 8 | 129 | 0 | 5 | 09:15 |
查询要求 trending_type IN (3,4,5) 且 ORDER BY release_time DESC,数据库的困境从这里开始。
它需要同时关注类型 3、4、5 三块区域。类型 3 内部时间有序,10:00 到 08:00;类型 4 内部也有序,10:05 到 08:30。
但跨类型看,时间是乱的:索引第 1 行是 10:00,第 4 行却是 10:05,第 7 行是 10:02,夹在中间。
因为要的是全局最新的 N 条,数据库不能直接按索引顺序读,否则会先读出类型 3 的 10:00,漏掉类型 4 的 10:05。
结果是只能把类型 3、4、5 的全部数据,约 33 万条,捞出来放进内存里按 release_time 重新排序。这就是那 2.2 秒的来源。
3. 新索引的物理样子
把排序字段提到范围字段之前,索引变成 (circle_id, del, release_time, trending_type),物理排列随之改变。
| 行号 | circle_id | del | release_time | trending_type |
|---|---|---|---|---|
| 1 | 129 | 0 | 10:05 | 4 |
| 2 | 129 | 0 | 10:02 | 5 |
| 3 | 129 | 0 | 10:00 | 3 |
| 4 | 129 | 0 | 09:30 | 4 |
| 5 | 129 | 0 | 09:15 | 5 |
| 6 | 129 | 0 | 09:00 | 3 |
数据库的执行过程变了。它看到 ORDER BY release_time DESC,发现索引前缀正好按 release_time 排好了,于是直接从索引最新的一端开始读,也就是 10:05。
边读边检查 trending_type 是否在 (3,4,5) 里。第 1 行是 4,命中 1/5;第 2 行是 5,命中 2/5;第 3 行是 3,命中 3/5。
读路径可以概括为 倒序读索引 → 过滤 trending_type → 凑够 N 条停止。凑够 N 条就立即停止扫描。
预期结果是:不需要排序,也不需要扫 33 万行,只扫几行索引就出结果。
配图
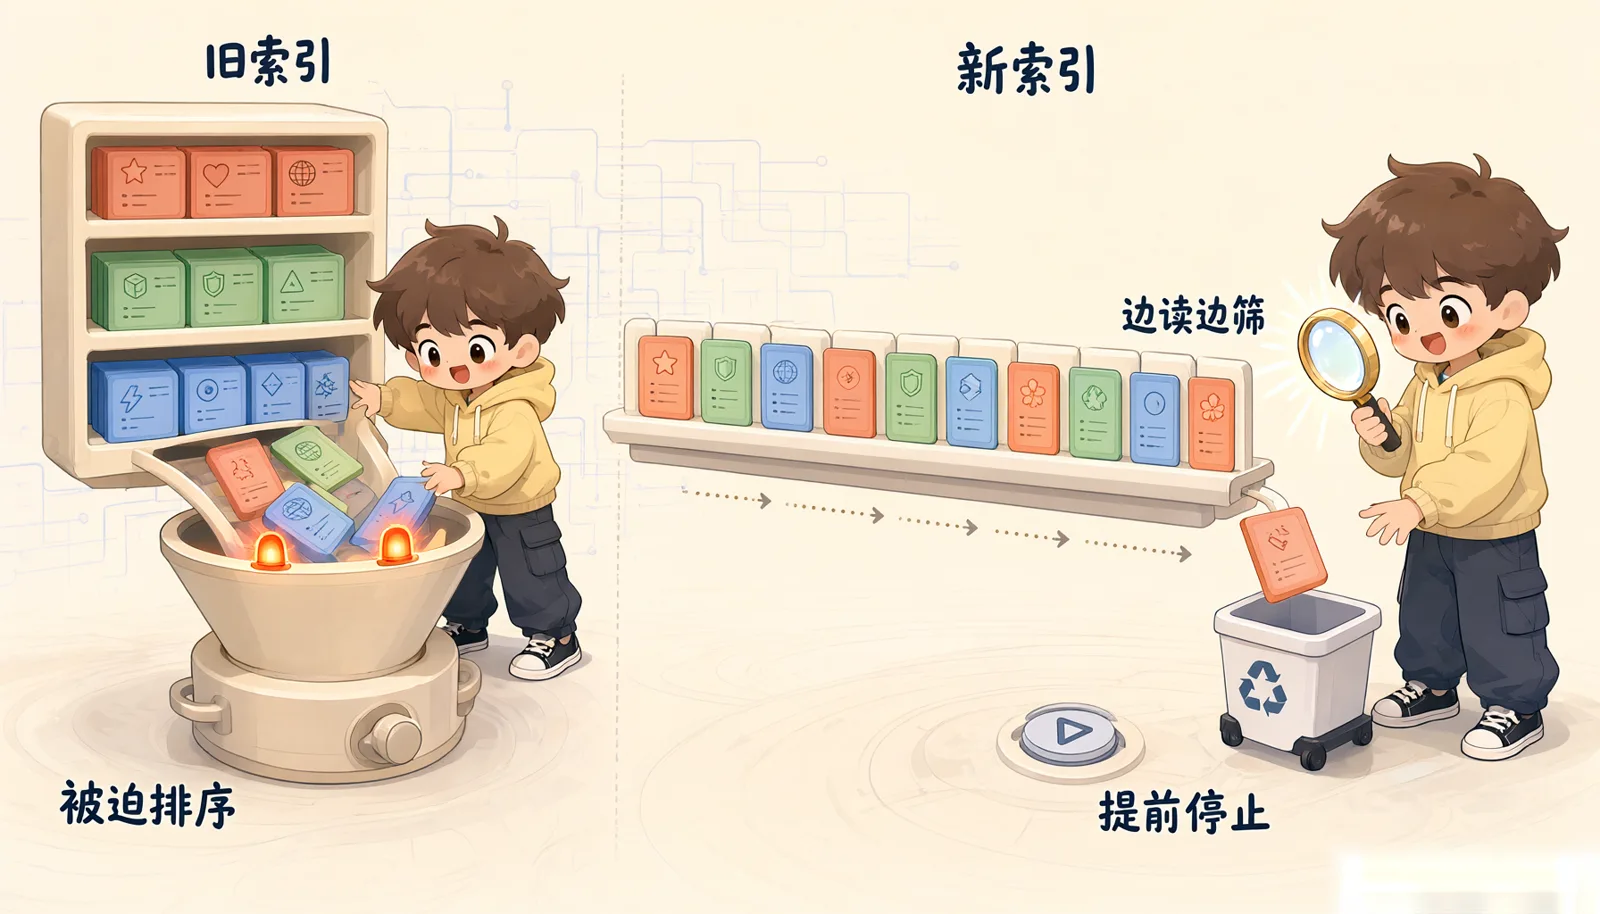
图 1:旧索引 vs 新索引,复合索引的列序决定能否命中
4. release_time 自己也是范围查询,凭什么能放前面
这是定位过程中最容易被问住的一点。release_time < '2026-…' 确实是范围查询,但它和 trending_type 有本质区别。
release_time 是排序字段本身。当它放在索引前面时,索引的物理顺序就是按时间排好的。release_time < ? 只是告诉数据库扫描到哪里停止,它不会打乱时间本身的先后顺序。
就像查字典找拼音 A 开头的字:字典本身按拼音排好,从 A 开始读、读到 B 之前停下就行,不需要额外排序。
trending_type 则是干扰字段。当它排在 release_time 前面时,把数据切成了多个时间块,类型 3 一块、类型 4 一块,破坏了 release_time 的全局连续性。
这就像把字典按封面颜色分成红皮、蓝皮、绿皮三摞,每摞内部按拼音排。要找所有字典里拼音最靠前的 5 个字,就得同时翻开三摞反复比较,这就退化成了排序问题。
预期结果:定位结论落到列序上。等值字段在前,排序字段紧随其后,范围过滤字段放最后靠扫描过滤。
三、方案:换一个列序,再换掉旧索引
1. 建新索引、删旧索引、更新统计
为什么不能直接改旧索引?因为索引列序无法原地修改,只能新建一个再删掉旧的。
怎么做?按下面的顺序执行,先建后删,中间不要省略统计信息更新。
-- 1. 创建新索引(CONCURRENTLY 后台运行,不锁表)
CREATE INDEX CONCURRENTLY idx_circle_time_type_opt
ON t_stock_friend_circle_trending_index (
    circle_id,
    del,
    release_time DESC,  -- 排序字段提前
    trending_type       -- 范围过滤字段放最后
);

-- 2. 删除旧索引
DROP INDEX idx_stock_friend_circle_trending_index_release_order;

-- 3. 更新统计信息
ANALYZE t_stock_friend_circle_trending_index;
2. 两个工程细节
CREATE INDEX CONCURRENTLY 避免建索引期间长时间锁表。代价是构建稍慢,且失败后可能留下 INVALID 索引需要清理。
索引变更后执行 ANALYZE 更新统计信息,帮助优化器选中新索引。跳过这一步,很可能看到新索引建好了但执行计划还走旧路径。
3. 预期结果
新索引生效后,执行计划里的 Sort 节点消失,扫描按 release_time 倒序进行,凑够条数立即停止。
对比改前的数据:排序对象从约 33 万行降到实际返回的几百行,Sort Method: quicksort Memory: 42346kB 这类内存排序不再出现。
业务侧的表现是列表页响应恢复稳定,不再出现单步 2.2 秒的毛刺。
四、沉淀:一张列序判断表
1. 字段角色决定位置
为什么按角色排,而不是按 WHERE 里出现的顺序排?因为索引的有序性只对前缀连续生效,角色决定了哪一列能提供全局顺序。
对于 WHERE A = ? AND B IN (...) ORDER BY C DESC LIMIT N 这类查询,可以直接套下面的表。
| 字段角色 | 查询条件 | 在索引中的最佳位置 | 原因 |
|---|---|---|---|
| 等值过滤 | circle_id = 129 | 最前面 | 快速定位数据块 |
| 排序字段 | ORDER BY release_time | 紧随等值字段之后 | 保证取出的数据天然有序,避免内存排序 |
| 范围/过滤 | trending_type IN (...) | 最后面 | 作为扫描过程中的过滤条件,不破坏前面的有序性 |
2. 一句话法则
范围条件会污染其后的索引列的有序性,因此排序字段必须排在其他范围过滤字段之前,哪怕排序字段本身也带范围条件。
它只是扫描的停止边界,不破坏顺序。索引列的顺序不是按字段在 WHERE 里出现的顺序排,而是按等值、排序、范围的角色排。
3. 预期结果
下次再遇到列表页的分页查询,先看 ORDER BY 的字段有没有紧跟在等值条件之后。如果没有,基本可以先怀疑列序,而不是先怀疑数据量。
常见错误与排错
- 现象:索引建了,执行计划里仍然是
Sort。原因:范围字段排在排序字段之前,打断了release_time的有序性。解法:把排序字段提到范围过滤字段之前,重建索引。 - 现象:
CREATE INDEX CONCURRENTLY中断后,索引留在 INVALID 状态。原因:并发构建失败不会自动清理。解法:先DROP INDEX再重建,确认索引有效后再删旧索引。 - 现象:新索引建好,优化器还是走旧路径。原因:统计信息没更新,优化器对选择率的估计还停留在旧数据。解法:执行
ANALYZE目标表。 - 现象:照着 WHERE 里字段出现的顺序建索引,依然全量排序。原因:索引列序按角色排,不按书写顺序排。解法:按等值、排序、范围重排后重建。
- 现象:换索引期间查询突然变慢,出现全表扫描。原因:先删了旧索引再建新索引,中间没有可用索引。解法:先
CONCURRENTLY建新索引,再DROP旧索引。
本篇小结
- 范围条件会污染其后索引列的有序性,
IN、<、>之后的字段不再全局有序。 - 排序字段要排在范围过滤字段之前,它自带的范围只是扫描停止边界,不破坏顺序。
- 索引列序按角色排:等值过滤、排序字段、范围过滤,与 WHERE 中的书写顺序无关。
- 在线换索引先建后删,建完执行
ANALYZE,再观察执行计划确认命中。