Oracle 亿级数据迁移实战:38 亿大表里安全搬走 1.3 亿行
下午 17:00 开始迁数据,19:30 实时入库任务就要跑,次日 07:00 还有跑批。三张表加起来 38 亿行,能动的只有中间几个小时。这篇复盘讲清楚窗口怎么定、事务粒度怎么控,以及三个坑背后的原理。
本篇你能学到
- 用影子表把迁移与切换解耦,切换失败时原路换回
- 按分区切分迁移任务,让失败只回滚当前分区
/*+ APPEND */与/*+ PARALLEL(8) */两个 hint 各自解决什么问题- 先裸迁后建索引、多会话并发,把迁移速度拉开一个量级
- 断点续跑的实现思路:从已迁移的最大分区接着走
一、先划边界:迁哪些数据、留多大窗口
1. 业务背景:按账户类型分表写入
业务调整后,指标入库需要按账户类型分表写入,也就是把一批数据从原表拆迁到新表。这次迁移只涉及指标数据,业务逻辑不动。
涉及的账户类型定义如下。
GT_GP("1","模拟交易-股票组合"),
EX_GP("6","外部产品-股票组合"),
SIGNAL("7","信号类"),
SIGNAL_EXT("8","信号测试类"),
IMS_GP("9","实盘高手-股票组合"),
QUANTIFICATION_GP("10","量化策略-股票组合"),
FREE_GP("11","免费组合-股票组合")
账户类型决定了数据落到哪张目标表。迁移之前必须先把这份映射关系确认清楚,因为它同时影响迁移脚本的过滤条件和入库代码的改写范围。
2. 三张表的数据量与取舍
为什么先看数据量?因为迁移方案的成本几乎全由数据量决定,是先迁一个月还是三年,是单表还是三表,策略完全不同。
三张表的关系和数据量如下。
| 说明 | 源表 | 目标表 | 数据量(账户类型9)约38亿 | 数据量(账户类型1,6,7)约1.3亿 |
|---|---|---|---|---|
| 产品评分指标表 | T_REVIEW_INDEX_VALUE | T_REV_IMS_IDX_VAL | 164,817,733 | 13,580,912 |
| 专业能力组合(数值类)指标表 | T_REVIEW_PORTFOLIO_INDEX | T_REV_PORT_IMS_IDX | 3,374,517,067 | 106,324,818 |
| 专业能力组合(字符类)指标表 | T_REVIEW_PORTFOLIO_STR_INDEX | T_REV_PORT_IMS_STR_IDX | 229,809,300 | 6,684,740 |
账户类型 9 一家的数据量就有约 38 亿,迁移耗时且风险高。最终决策是只迁移账户类型 1、6、7 的数据,约 1.3 亿条。
这个取舍直接决定了后面的窗口能不能撑住。如果连 38 亿一起迁,下面的按分区提交和多会话并发都救不了时间。
3. 窗口只有两个半小时
数据迁移安排在当天下午 17:00,属于业务低峰期。当晚 19:30 有实时入库任务,次日早上 07:00 有跑批入库任务。
从 17:00 到 19:30,只有两个半小时。表结构变更后必须同步更新入库代码,否则当晚入库就会写错表,所以窗口里还要给代码发布留时间。
预期结果是:迁移脚本必须在两个半小时内跑完 1.3 亿行,并且切换动作要能和代码发布对上节奏。这两个约束会贯穿后面的所有设计。
二、影子表切换:迁移与切换解耦
1. 为什么不原地改表
为什么不能直接改原表?原地删改意味着长事务、长时间锁表,Undo 表空间会被持续撑大,而且中途失败很难快速回到原状。
影子表的思路是另起一张表承接数据,线上读写继续走旧表。迁移期间业务完全不受影响,切换只在最后一步发生。
怎么做?新建的 _TEMP 表一开始不带索引,把数据整批搬进去,校验通过后再动表名。
2. 五步流程
整个方案分五步。
- 新建
xxx_TEMP表(不带索引); - 用 SQL 脚本把目标数据从源表导入
_TEMP表; - 校验数据是否全部迁移成功;
- 源表改名(
RENAME旧表为备份名); _TEMP表改名为源表表名,原子上位。
配图
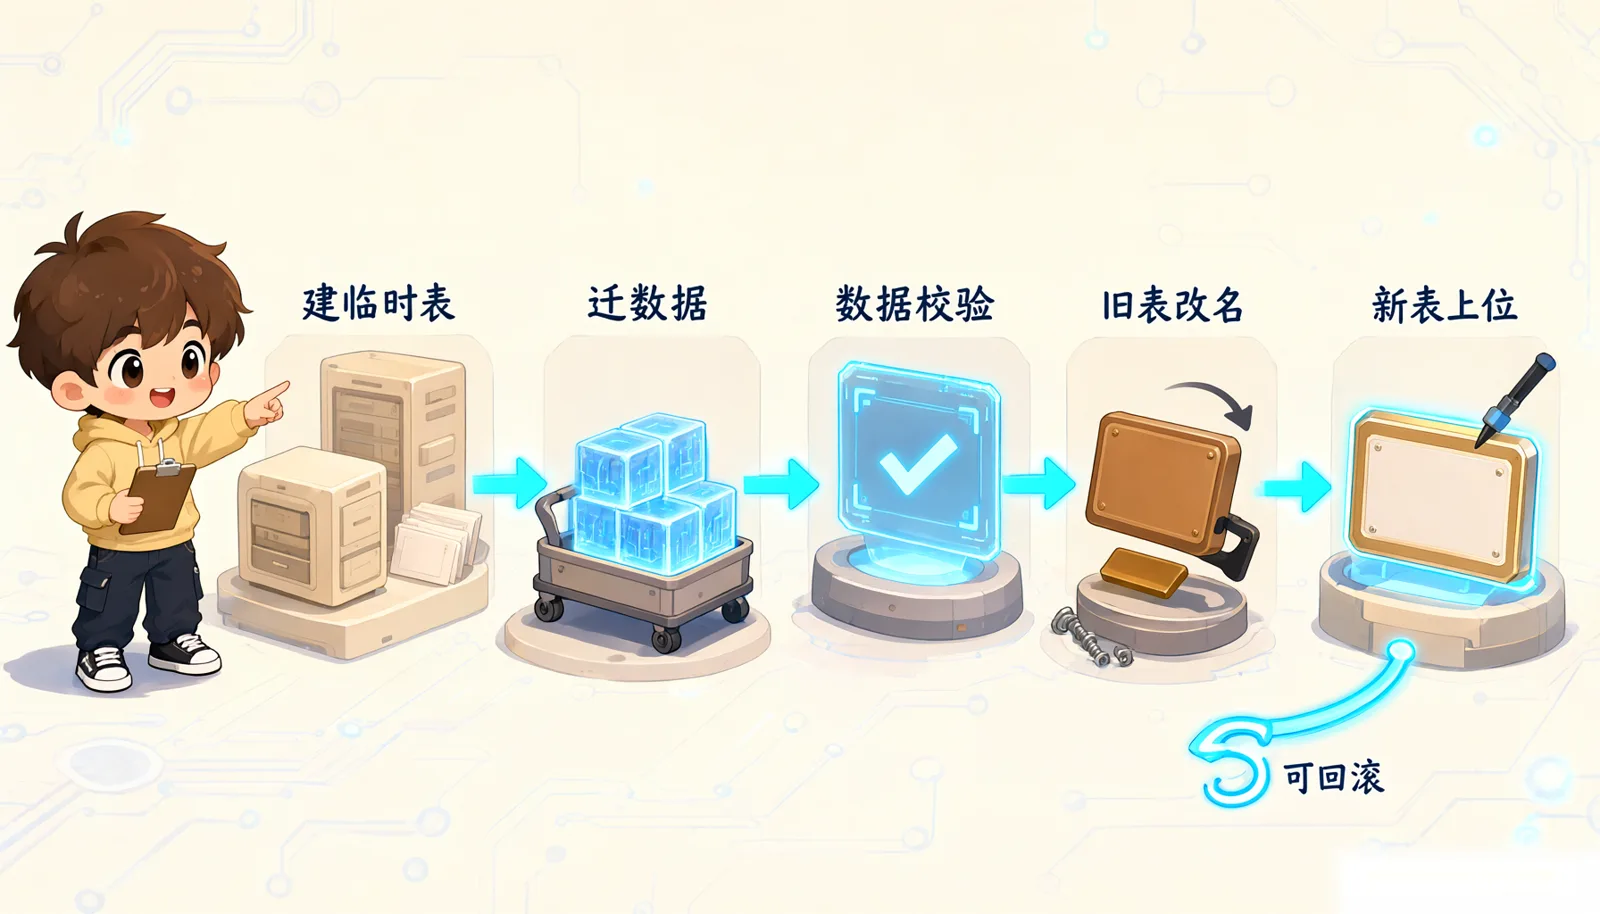
图 1:影子表切换五步,迁移与切换解耦,可随时回滚
第 4 步和第 5 步都是 DDL,执行很快,真正的耗时全在第 2 步。把耗时动作和切换动作分开,是这个方案最核心的价值。
3. 回滚靠什么
切换前旧表数据完整保留,天然具备回滚能力。切换后一旦发现异常,把两个表名换回去即可,不需要重跑任何数据。
预期结果是切换风险被压缩到两次 RENAME 之间。即使切换后发现入库代码有问题,也能在分钟级回到旧表,而不是面对一份已经改坏的数据。
三、迁移脚本:分区遍历、直路径插入、按批提交
1. 为什么按 STAT_DATE 切
为什么按分区切,而不是一条 INSERT 搬完?因为一条大 SQL 会形成超长事务,Undo 持续增长,失败时全部回滚,几个小时的活白干。
按 STAT_DATE 切分后,每个分区一条插入语句、一次提交。失败只影响当前分区,前面已经提交的分区不用重做。
2. 脚本骨架
脚本按 STAT_DATE 分区遍历,每个分区一条 INSERT /*+ APPEND */ 直路径插入,单独提交。
DECLARE
    -- 游标:获取所有需要迁移的 STAT_DATE(去重)
    CURSOR date_cursor IS
        SELECT DISTINCT pi.STAT_DATE
        FROM T_REVIEW_PORTFOLIO_INDEX pi
        WHERE pi.ACCOUNT_TYPE IN (1)  -- 只选择账户类型为1的记录
        ORDER BY pi.STAT_DATE;        -- 按分区升序排列

    v_stat_date   NUMBER(10,0);  -- 当前处理的分区
    v_rowcount    NUMBER;        -- 本次插入的行数
    v_total_rows  NUMBER := 0;   -- 总插入行数(累加计数器)
BEGIN
    -- 遍历所有需要迁移的分区
    FOR date_rec IN date_cursor LOOP
        v_stat_date := date_rec.STAT_DATE;
        DBMS_OUTPUT.PUT_LINE('正在处理分区: ' || v_stat_date);

        -- 全量插入当前分区数据(APPEND 直路径插入提高性能)
        INSERT /*+ APPEND */ INTO T_REVIEW_PORTFOLIO_INDEX_TEMP
        SELECT /*+ PARALLEL(8) */ *
        FROM T_REVIEW_PORTFOLIO_INDEX pi
        WHERE pi.STAT_DATE = v_stat_date
          AND pi.ACCOUNT_TYPE IN (1);

        v_rowcount := SQL%ROWCOUNT;
        v_total_rows := v_total_rows + v_rowcount;

        COMMIT;  -- 每个分区独立提交
        DBMS_OUTPUT.PUT_LINE('  已插入 ' || v_rowcount || ' 行,分区: ' || v_stat_date);
    END LOOP;

    DBMS_OUTPUT.PUT_LINE('数据迁移完成!总计插入行数: ' || v_total_rows);
EXCEPTION
    WHEN OTHERS THEN
        ROLLBACK;
        DBMS_OUTPUT.PUT_LINE('错误发生在分区 ' || v_stat_date || ': ' || SQLERRM);
        RAISE;
END;
这个骨架可以套到另外两张表上,只需要替换表名和账户类型过滤条件。
3. 三个要点
/*+ APPEND */ 是直路径插入,绕过 Buffer Cache,直接写数据文件,Undo/Redo 开销大幅降低。
/*+ PARALLEL(8) */ 让数据库并行执行引擎参与扫描,单条 SQL 内部就能吃满多核。
按分区 COMMIT 控制事务粒度,失败只回滚当前分区,也避免了长事务撑爆 Undo 表空间。
预期结果是每个分区的事务长度可控,任何一次失败都不会把已完成的迁移清零。
4. 窗口不够时怎么续跑
脚本本身具备分区级幂等性。迁移中途数据库宕机或网络中断,恢复后查询 _TEMP 表中已存在的最大 STAT_DATE,从游标里过滤掉已迁移分区,即可断点续跑。
这样做的前提是分区级提交。如果整批一个事务,中断后什么都留不下,只能从头再来。
配图
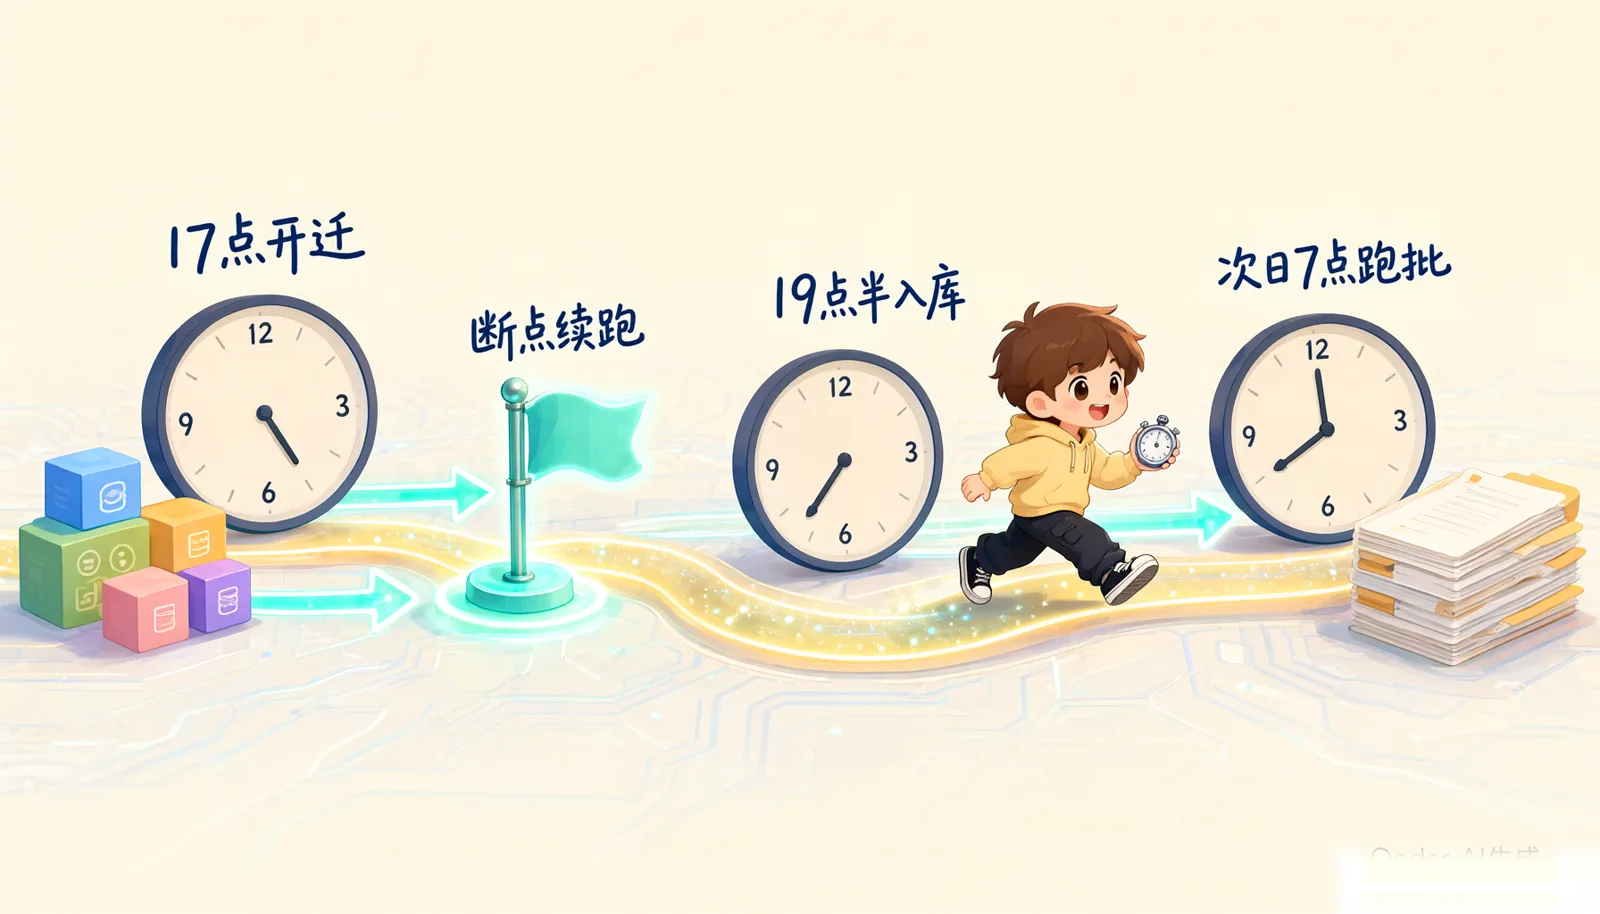
图 2:迁移窗口与断点续跑,按批提交,窗口不够也能接着跑
预期结果是窗口不够时可以分两次跑,第二次从断点继续,不用重新评估整条迁移链路。
四、三个坑:日志、索引、并发
1. 坑 1:日志打太多,脚本自己挂了
现象:为了监控迁移进度,在循环里高频 DBMS_OUTPUT.PUT_LINE,跑到一半报错中断。
原理:DBMS_OUTPUT 的默认缓冲区只有约 2~3.2 万字符,长循环高频打印会触发下面的错误。
ORA-20000: ORU-10027: buffer overflow, limit of 20000 bytes解决有三个层次。移除循环内逐批打印,只在关键节点汇总输出,包括分区开始、分区结束、任务汇总和异常信息。调试时可以动态扩容,执行 DBMS_OUTPUT.ENABLE(1000000)。生产级脚本建议把日志写入独立的日志表,既不占内存也便于事后审计。
预期结果是脚本能跑完全程,输出量稳定在缓冲区上限以内。
2. 坑 2:先建索引再迁数据,慢到怀疑人生
现象:一开始 _TEMP 表是带索引建的,插入速度随着数据量增大明显劣化。
原理:普通行级 INSERT 每写一行,都要同步维护 B 树索引,包括页分裂、节点更新和额外 Redo。海量数据下索引维护开销远超数据写入本身,还容易产生索引碎片。
解决是先迁数据,后建索引。
-- 数据迁完之后,集中并行建索引
CREATE INDEX idx_xxx ON xxx (col1, col2) PARALLEL 8 NOLOGGING;
-- 建完后恢复 LOGGING 并收集统计信息
ALTER INDEX idx_xxx LOGGING;
EXEC DBMS_STATS.GATHER_TABLE_STATS(user, 'XXX', cascade => TRUE);注意:NOLOGGING 模式建的索引在介质恢复时需要重建,生产上要确认备份策略后再使用。
预期结果是插入阶段不再有索引维护开销,建索引阶段集中消耗资源,总耗时明显缩短。
3. 坑 3:单线程跑迁移,数据库资源没吃满
现象:单会话执行时,数据库服务器 CPU、IO 利用率都很低,纯靠时间磨。
原理:单个会话受限于单进程的 CPU 调度与串行 IO,无法利用数据库服务器的多核与并行能力。
解决分三步。按 STAT_DATE 分区范围或 ACCOUNT_TYPE 拆分任务,多个会话并发执行,每个会话负责互不重叠的分区区间。
配合 /*+ PARALLEL(n) */ hint 让单条 SQL 内部也并行扫描。并发会话数别超过数据库 PARALLEL_MAX_SERVERS 的承受能力,避免挤占跑批资源。
预期结果是服务器 CPU 和 IO 利用率抬起来,迁移从单线程的线性耗时变成多核并行。
五、切换与收尾:校验、改名、回归
1. 数据校验
为什么校验不能只对总数?因为 COUNT(*) 相同不代表内容相同,重复行和缺失行可能刚好抵消。
怎么做?对源表、目标表分别 COUNT(*),并抽样比对 SUM、极值等关键指标,确认 100% 匹配。
2. 原子切换与代码协同
用 RENAME 完成新旧表切换,这是 DDL 原子操作,对线上业务影响极小。伪代码就两行:RENAME 源表 TO 源表_BAK,再 RENAME _TEMP TO 源表。
切换前要把新版入库代码准备好,按账户类型分表写入。切换动作与代码发布必须协同进行,否则 19:30 的实时入库会写错表。
3. 回归验证
19:30 实时入库、次日 07:00 跑批,全链路验证通过后,旧表数据保留观察一段时间再下线。
预期结果是全程零回滚、零业务中断。旧表多留几天,是给这次迁移留的最后一道保险。
常见错误与排错
- 现象:脚本跑到一半报
ORA-20000: ORU-10027。原因:循环里高频PUT_LINE,超过默认 20000 bytes 缓冲。解法:删掉逐批打印只留分区汇总,或执行DBMS_OUTPUT.ENABLE(1000000)。 - 现象:插入速度随数据量增长明显劣化。原因:
_TEMP建表时带了索引,每写一行都要维护 B 树。解法:先裸表迁数据,完成后用PARALLEL 8 NOLOGGING建索引,再ALTER INDEX恢复 LOGGING 并收集统计。 - 现象:服务器 CPU、IO 都很低,迁移纯靠时间磨。原因:单会话受单进程调度与串行 IO 限制。解法:按分区拆多会话并发,并控制总并发不超过
PARALLEL_MAX_SERVERS。 - 现象:迁移中断后重跑,出现重复数据或唯一键冲突。原因:脚本没做幂等,已提交分区被重复插入。解法:先查
_TEMP的最大STAT_DATE,过滤游标里已迁移的分区。 - 现象:切表当晚入库写错了表。原因:表结构变了,入库代码没同步。解法:切换与代码发布协同,先验证 19:30 实时入库再收尾。
本篇小结
- 影子表把迁移与切换拆成两件事,切换前旧表原样保留,回滚只是换两个表名。
- 按分区提交让事务粒度可控,失败只回滚当前分区,也不会撑爆 Undo。
- 先裸迁后建索引,配合多会话并发和
PARALLELhint,才能吃满数据库资源。 - 断点续跑靠最大已迁移分区,窗口不够也能接着跑。